Definizione canonica: cosa costituisce un sistema di IA
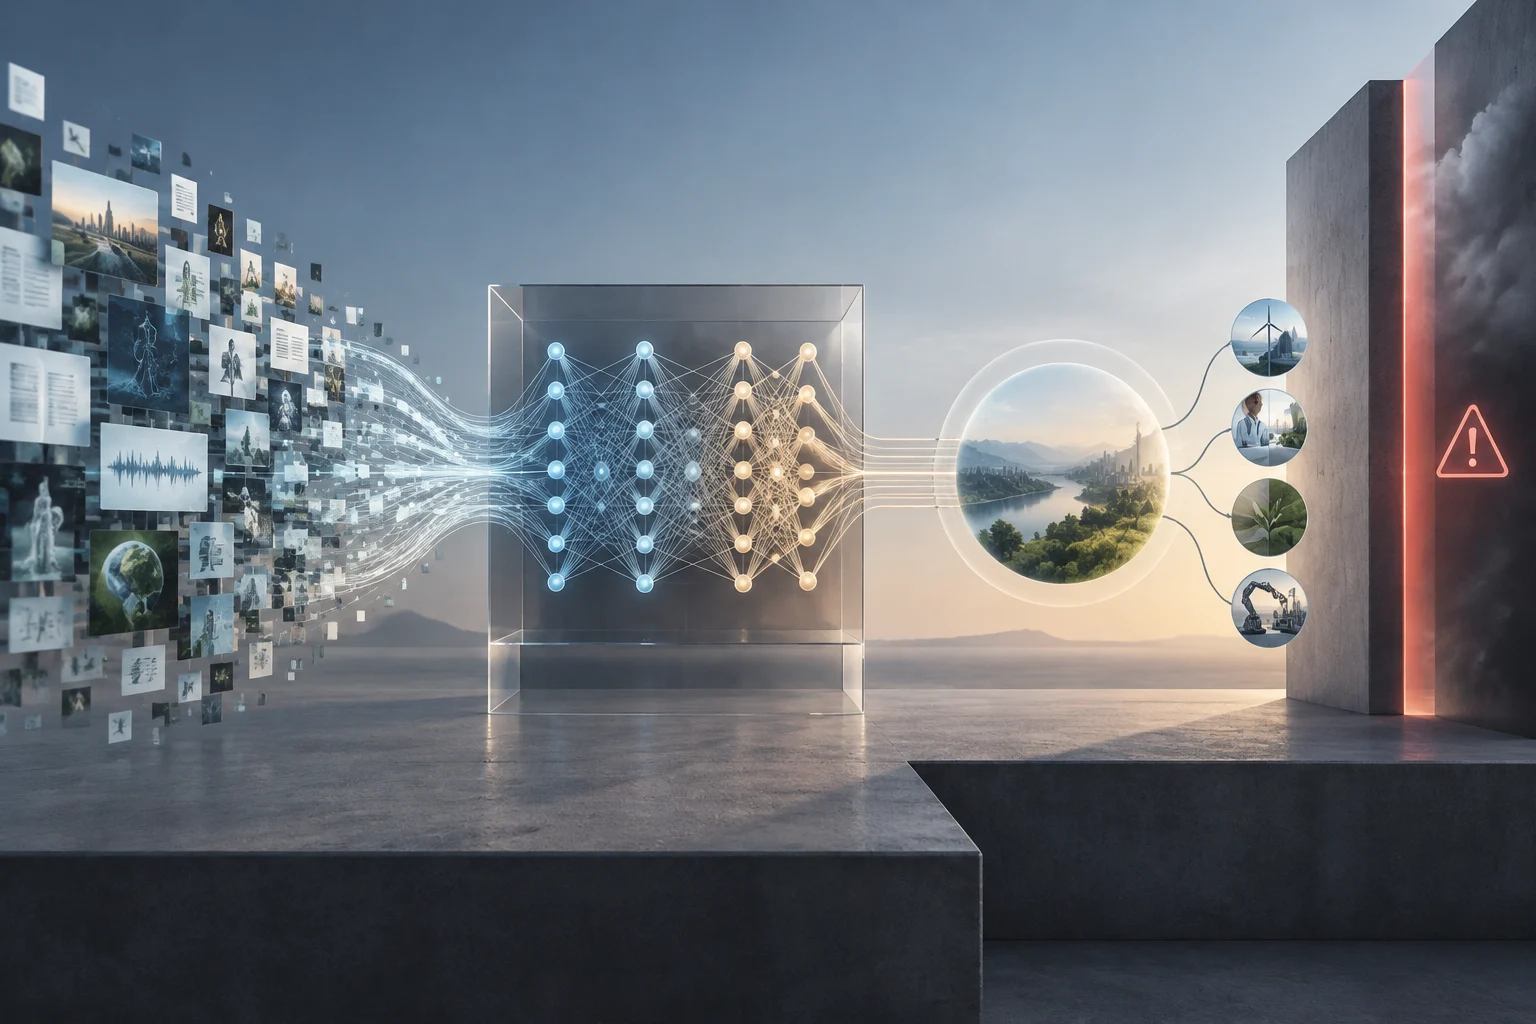
L'intelligenza artificiale è definita come il campo dell'informatica dedicato alla creazione di sistemi in grado di svolgere compiti che tradizionalmente richiedono intelligenza umana, come la percezione, il ragionamento, l'apprendimento e la comprensione del linguaggio naturale. Questa definizione, supportata da organismi come l'Unione Europea e le aziende tecnologiche, stabilisce che non si tratta di una singola tecnologia, ma di un insieme di metodi che permettono alle macchine di elaborare informazioni e prendere decisioni.
Il Regolamento Europeo sull'Intelligenza Artificiale (AI Act), entrato in vigore nel febbraio 2025, offre un quadro giuridico per classificare questi sistemi in base al loro livello di rischio. La normativa distingue tra sistemi a scopo generale e specifico, stabilendo obblighi per i fornitori e gli utenti. Questa regolamentazione mira a garantire che lo sviluppo dell'IA sia trasparente, sicuro e rispettoso dei diritti fondamentali, segnando uno standard globale per l'industria.
Differenza con la programmazione tradizionale
A differenza di un programma tradizionale, dove ogni regola è preprogrammata esplicitamente da uno sviluppatore, un sistema di IA impara modelli a partire dai dati. Nella programmazione classica, se il criterio cambia, il codice deve essere modificato manualmente. Nell'IA, il sistema adatta i propri parametri interni quando esposto a nuovi esempi, permettendogli di adattarsi a situazioni non previste nel suo design iniziale.
Meccanismi di funzionamento: dal dato alla decisione
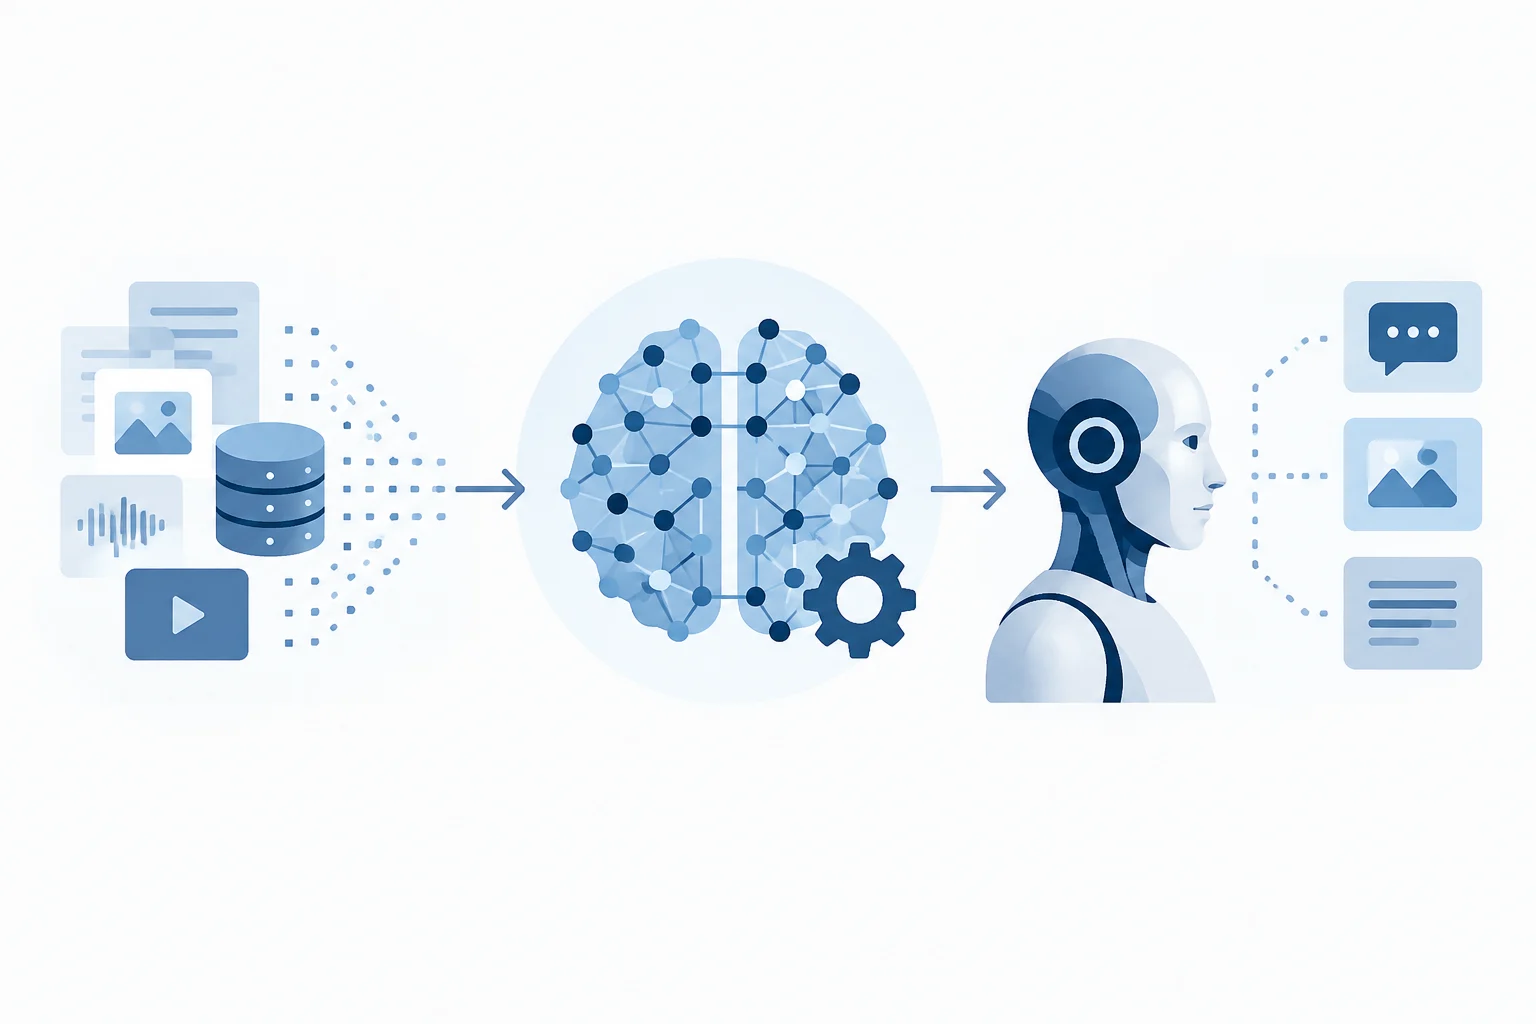
Il funzionamento di un sistema di IA si basa sull'apprendimento automatico (machine learning), un sottoinsieme dell'IA in cui i sistemi identificano modelli in grandi volumi di dati senza essere programmati esplicitamente per ogni caso. Il processo inizia con la raccolta di dati, utilizzati per addestrare un modello matematico. Questo modello adatta i propri parametri interni finché le sue previsioni non si allineano con i risultati attesi nel set di dati di addestramento.
Una volta addestrato, il modello entra nella fase di inferenza, il momento in cui il sistema applica i modelli appresi a nuovi dati per generare una risposta o una decisione. Ad esempio, un modello addestrato con immagini di animali può identificare una razza di cane in tempo reale, anche se non ha mai visto quell'immagine specifica prima. La qualità dell'inferenza dipende direttamente dalla quantità e dalla rilevanza dei dati utilizzati nell'addestramento.
Il ciclo di vita del modello
Lo sviluppo di un sistema di IA segue un ciclo iterativo che include la raccolta di dati, l'addestramento, la validazione, il deployment e il feedback. La validazione è cruciale per misurare la precisione del modello su dati non visti durante l'addestramento, evitando l'overfitting. Il feedback permette di aggiornare il modello con nuovi dati, migliorandone le prestazioni nel tempo.
Tipi di apprendimento automatico
All'interno dell'apprendimento automatico, esistono tre approcci principali che si differenziano per come sono strutturati i dati e come il modello riceve le sue istruzioni. La scelta del metodo dipende dalla natura del problema e dalla disponibilità di dati etichettati. Ogni approccio ha applicazioni specifiche e requisiti distinti in termini di qualità e volume delle informazioni in ingresso.
La seguente tabella confronta i tre tipi principali di apprendimento automatico, evidenziandone le caratteristiche, esempi di applicazione e requisiti di dati:
| Tipo di apprendimento | Descrizione | Esempio di applicazione | Requisiti di dati |
|---|---|---|---|
| Supervisionato | Il modello impara da dati etichettati con la risposta corretta. | Rilevamento dello spam nelle e-mail. | Dati etichettati (input e output atteso). |
| Non supervisionato | Il modello identifica modelli o raggruppamenti in dati non etichettati. | Segmentazione dei clienti nel marketing. | Dati non etichettati, grandi volumi. |
| Per rinforzo | Il modello impara per prova ed errore, ricevendo ricompense o penalità. | Robot di navigazione o giochi di scacchi. | Ambiente simulato o reale con feedback continuo. |
L'apprendimento supervisionato è il più comune nelle applicazioni commerciali, poiché permette di valutare oggettivamente la precisione del modello. Il non supervisionato è utile quando la struttura dei dati è sconosciuta o si cercano relazioni nascoste. L'apprendimento per rinforzo è impiegato in ambienti dinamici dove l'azione dell'agente ha conseguenze immediate misurabili.
IA debole, IA forte e IA generativa
Il campo dell'IA è tradizionalmente diviso in due rami: l'intelligenza artificiale debole (o stretta) e l'intelligenza artificiale forte (o generale). L'IA debole è progettata per svolgere compiti specifici, come il riconoscimento vocale in un assistente virtuale o la raccomandazione di prodotti in una piattaforma di e-commerce. La maggior parte delle applicazioni attuali appartiene a questa categoria, poiché sono più facili da sviluppare e valutare.
L'IA forte (AGI, in inglese) aspira a emulare l'intelligenza umana nella sua totalità, permettendo alla macchina di ragionare, adattarsi e imparare in modo simile a una persona. Questo tipo di IA è ancora in fase di ricerca e non è stato raggiunto da alcun sistema commerciale. La distinzione è importante per evitare aspettative irrealistiche sulle capacità attuali della tecnologia.
IA generativa vs. IA analitica
Negli ultimi anni, l'IA generativa ha guadagnato protagonismo, un sottoinsieme dell'IA che crea nuovo contenuto (testo, immagini, codice) a partire dai modelli appresi. A differenza dell'IA analitica, che classifica o predice, l'IA generativa produce output creativi. Modelli come GPT-4 di OpenAI sono esempi di IA generativa, utilizzati per redigere testi, generare codice o creare immagini. Questa capacità ha ampliato la portata dell'IA nei settori creativi e nello sviluppo software.
Usi pratici ed esempi spiegati
L'intelligenza artificiale è applicata in diversi settori, dalla salute all'industria. Nel campo medico, i sistemi di IA aiutano nella diagnosi per immagini, analizzando radiografie o risonanze per rilevare anomalie che potrebbero sfuggire all'occhio umano. Questi sistemi non sostituiscono il medico, ma agiscono come uno strumento di supporto che accelera il processo e riduce il carico di lavoro.
Nel settore finanziario, l'IA è utilizzata per il rilevamento delle frodi, analizzando le transazioni in tempo reale per identificare modelli sospetti. Nell'e-commerce, i motori di raccomandazione suggeriscono prodotti basandosi sulla cronologia degli acquisti e sul comportamento dell'utente. Nell'industria, l'IA ottimizza la catena di approvvigionamento, predice i guasti alle macchine e automatizza i processi di controllo qualità.
Esempio: diagnosi medica
Un sistema di IA addestrato con migliaia di immagini di retine può rilevare segni di diabete o glaucoma con una precisione paragonabile a quella di uno specialista. Il modello analizza l'immagine e genera una probabilità di malattia, che il medico esamina e conferma. Questo approccio permette di scalare la capacità diagnostica in zone con scarsità di specialisti, migliorando l'accesso alle cure.
Limiti, rischi e necessità di supervisione
Nonostante i suoi vantaggi, l'IA presenta rischi significativi che devono essere gestiti. Uno dei più notevoli è l'allucinazione, fenomeno per cui un modello generativo inventa informazioni inesistenti o errate, presentandole con la stessa fiducia dei dati reali. Questo accade perché il modello predice la parola o l'elemento più probabile successivo, senza verificare la veridicità delle informazioni.
Un altro rischio importante è il bias nei dati di addestramento. Se i dati utilizzati per addestrare un modello non sono rappresentativi della popolazione target, le raccomandazioni del sistema possono favorire o danneggiare certi gruppi. Ad esempio, un modello di assunzione addestrato con dati storici distorti può perpetuare la discriminazione di genere o razza. La supervisione umana è essenziale per rilevare e correggere questi bias.
Dipendenza e svanimento del giudizio
La fiducia eccessiva nei sistemi di IA può portare alla dipendenza tecnologica, dove i professionisti adottano le suggerimenti del sistema senza esaminarli criticamente. Questo è particolarmente preoccupante in settori critici come la salute o la giustizia, dove un errore può avere conseguenze gravi. La formazione degli utenti e l'implementazione di protocolli di verifica sono essenziali per mitigare questo rischio.
Glossario di base dei termini chiave
Per comprendere l'IA, è utile familiarizzare con alcuni termini tecnici. Un modello è la rappresentazione matematica che il sistema utilizza per fare previsioni. Un dataset (insieme di dati) è la raccolta di informazioni con cui il modello viene addestrato. L'inferenza è il processo di applicazione del modello addestrato a nuovi dati per ottenere una risposta.
L'addestramento è la fase in cui il modello adatta i suoi parametri per minimizzare l'errore nei dati di addestramento. La validazione è il processo di valutazione del modello con dati non visti durante l'addestramento, per misurare la sua capacità di generalizzazione. L'overfitting si verifica quando il modello memorizza i dati di addestramento invece di imparare modelli generali, riducendo le sue prestazioni su nuovi dati.
Importanza della qualità dei dati
La qualità dei dati è determinante per il successo di un sistema di IA. Dati incompleti, rumorosi o distorti possono portare a modelli imprecisi o ingiusti. La governance dei dati implica stabilire processi per garantire la qualità, la privacy e la sicurezza delle informazioni utilizzate nell'addestramento e nell'inferenza. Senza una solida base di dati, anche l'algoritmo più avanzato non funzionerà correttamente.