Che cosa misura PingER e a cosa serve
PingER è un progetto di monitoraggio delle reti associato allo SLAC National Accelerator Laboratory. Il suo metodo si basa soprattutto sull’invio di messaggi ICMP Echo a host remoti e sulla misurazione delle risposte. L’idea fondamentale per chi interpreta i risultati è semplice: il progetto osserva il comportamento dei pacchetti di prova tra due punti. Non certifica la qualità complessiva di una connessione né l’esperienza di tutte le applicazioni che la utilizzano.
Il progetto è stato concepito per seguire le prestazioni dei percorsi Internet tra istituzioni e studiarne i cambiamenti nel tempo. Il suo valore principale è quindi osservare le tendenze: per esempio, capire se il tempo di risposta di un percorso peggiora in modo persistente o se compaiono intervalli con più pacchetti senza risposta. Una singola misurazione può fornire un indizio utile, ma non basta per individuare una causa o descrivere l’intero servizio Internet di una persona. Il risultato riguarda i pacchetti, gli estremi, il percorso e le condizioni del test considerato.
L’RTT non è la latenza in una sola direzione
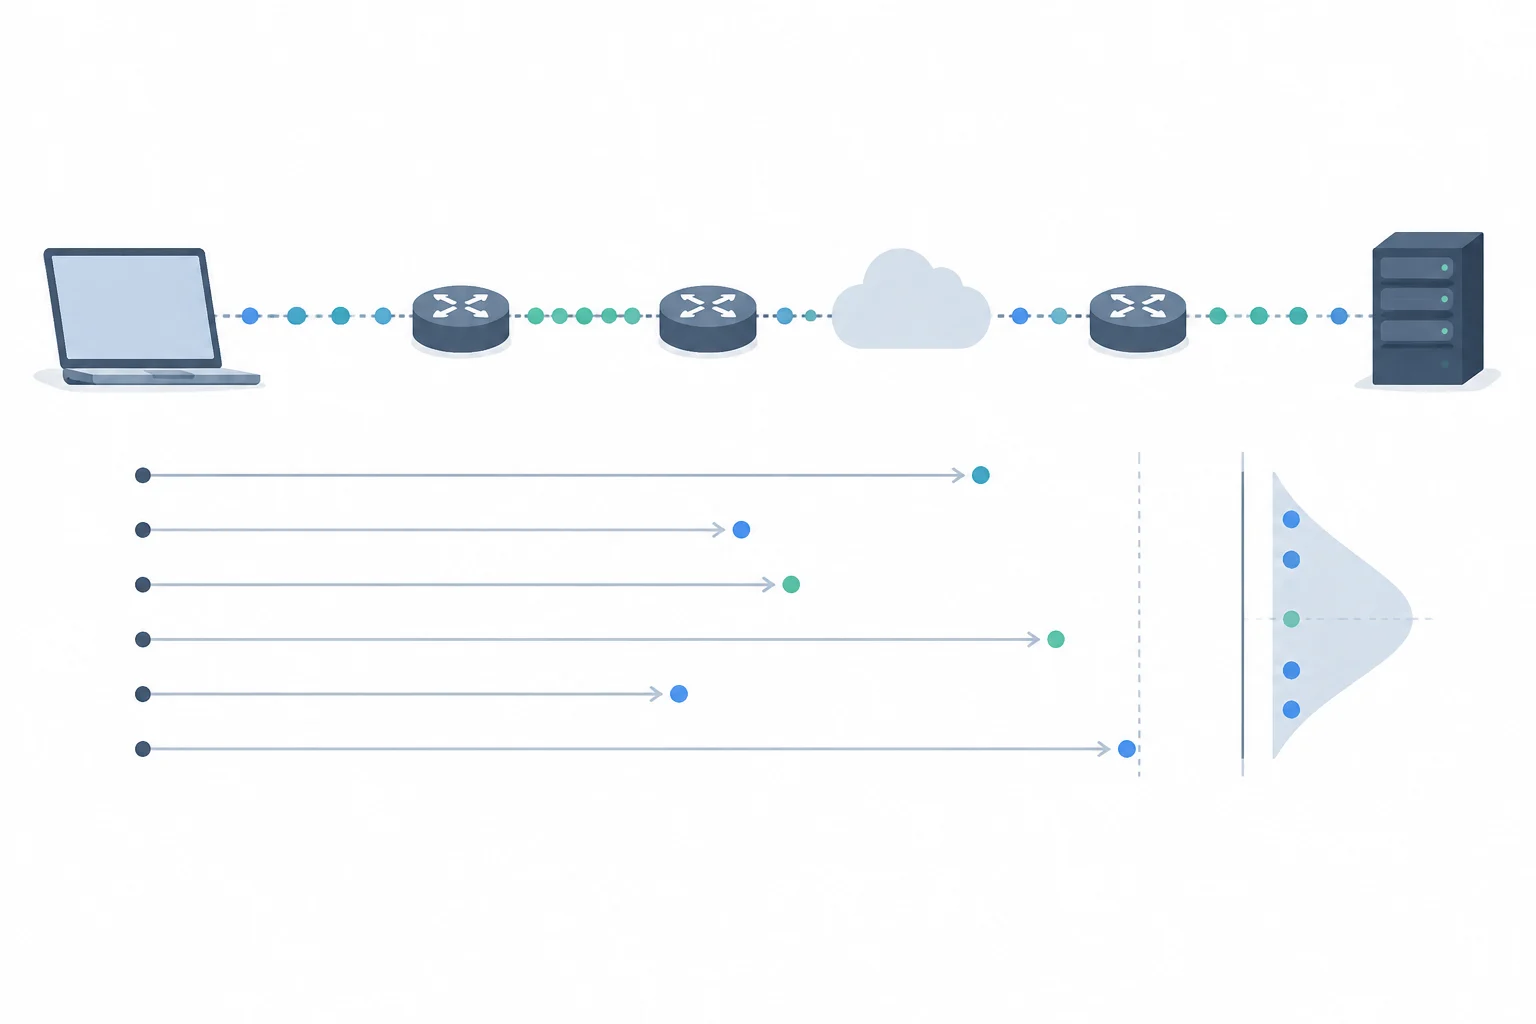
Il round-trip time, o RTT, è il tempo che trascorre da quando parte un pacchetto di prova a quando torna la risposta. In un test ICMP Echo, il sistema di misurazione invia una richiesta e riceve dal destinatario un messaggio echo. Il risultato comprende il percorso di andata, quello di ritorno e il tempo che il sistema remoto impiega per rispondere. Non separa il ritardo delle due direzioni: perciò l’RTT non può essere letto come la sola latenza dalla sorgente alla destinazione.
La distinzione è importante perché su Internet il traffico non segue sempre lo stesso percorso nei due sensi. Anche quando i percorsi coincidono, la congestione può essere diversa in ciascuna direzione. Un RTT elevato indica quindi che una parte del tragitto completo o della risposta richiede più tempo, ma non individua il problema. Non dimostra neppure che una specifica applicazione avrà esattamente quel ritardo: incidono anche il server e il tempo che impiega a rispondere. L’RTT descrive lo scambio misurato nel suo insieme, non attribuisce la responsabilità a un collegamento o servizio specifico.
Perdita di pacchetti: un segnale utile, non una spiegazione completa
In questo tipo di test, una richiesta che non riceve risposta entro il tempo configurato viene conteggiata come persa dal sistema di monitoraggio. La definizione dipende quindi da una soglia temporale: una risposta che arriva dopo il limite può essere considerata persa anche se il pacchetto ha infine raggiunto la destinazione. La misurazione descrive ciò che è accaduto a quei pacchetti di prova secondo quella regola, non necessariamente a tutto il traffico della connessione. Il tasso di perdita va quindi interpretato in relazione all’ambito e alle impostazioni del test.
La documentazione di calibrazione di PingER descrive una configurazione in cui il client attende 20 secondi prima di considerare persa una risposta. È un dettaglio del metodo documentato, non una regola universale per ogni strumento né la garanzia che tutte le installazioni attuali usino lo stesso valore. Un risultato di perdita richiede contesto: dimensione e tipo dei pacchetti, intervallo tra i test, tempo di attesa e percorso seguito. Se queste condizioni cambiano, i risultati potrebbero non essere direttamente confrontabili, anche quando vengono presentati entrambi come percentuali di perdita.
Variazione e jitter: osservare la distribuzione, non solo il massimo
L’RTT non deve necessariamente rimanere costante. Le differenze tra le risposte possono mostrare che il percorso ha un comportamento irregolare, aspetto rilevante per comunicazioni interattive, voce o video. La documentazione di PingER descrive diversi metodi per misurare il jitter. Uno stima le variazioni osservando come cambia la distanza temporale tra le risposte quando i test vengono inviati a intervalli regolari. È un modo per caratterizzare le misure, ma non spiega da solo perché la distanza sia cambiata.
È quindi utile confrontare statistiche compatibili e osservare l’insieme dei campioni. Il valore massimo può dipendere da una risposta eccezionale; mediana e percentili aiutano a distinguere il comportamento abituale dagli episodi estremi, mentre una serie temporale mostra quando si verificano i cambiamenti. La variazione è un’osservazione, non una diagnosi: può essere collegata al carico, a percorsi che cambiano o al ritardo del sistema che risponde. Un test ICMP da solo non permette di determinare quale fattore sia intervenuto. Condizioni di prova coerenti rendono più significativi i confronti, senza trasformare un andamento misurato nella prova della sua causa.
Perché PingER non equivale a un test di velocità
Un test RTT invia pacchetti piccoli e ne misura le risposte; non cerca di saturare il collegamento con un trasferimento prolungato. Un RTT basso, quindi, non dimostra che sia disponibile un throughput elevato, mentre un RTT alto non quantifica da solo quanti megabit al secondo possa trasferire una connessione. In alcuni casi ritardo e capacità massima possono essere collegati, ma sono metriche diverse. La misura del tempo di risposta e quella del trasferimento sostenuto rispondono a domande differenti.
Strumenti come iperf3 eseguono misurazioni attive per stimare la larghezza di banda raggiungibile e riportano il throughput; a seconda del test possono anche fornire dati sulla perdita e altri parametri. Per un confronto utile, gli estremi devono partecipare alla prova e protocollo, durata e carico devono essere definiti chiaramente. PingER studia ritardo e risposta della rete; iperf3 prova il throughput tra estremi configurati. Nessuna delle due misure equivale necessariamente a un test commerciale tra un dispositivo domestico e un server vicino, perché estremi e condizioni possono essere diversi.
Come interpretare un risultato senza formulare diagnosi eccessive
Consideriamo un esempio ipotetico: durante una serie di test, una destinazione mostra tempi di risposta variabili e alcune risposte non arrivano entro il limite configurato. Il risultato sarebbe compatibile con una variazione dell’RTT e con una perdita secondo la regola di attesa usata. Non dimostrerebbe da solo che il provider Internet sia congestionato. Occorre verificare se il fenomeno si ripete, se interessa altre destinazioni e se coincide con problemi nelle applicazioni utilizzate.
Per trasformare le metriche in una decisione pratica, annota destinazione e orario, ripeti le osservazioni in momenti diversi e confronta più di un percorso. Se il problema compare solo con un host, può trovarsi su quel sistema o lungo il relativo percorso. Se interessa più destinazioni e coincide con problemi d’uso, approfondire la diagnosi diventa più utile, senza però identificare ancora il componente responsabile. Per esaminare il throughput serve un test pensato per trasferire dati e, quando possibile, un server di prova vicino e affidabile.
Prima di interpretare il risultato, controlla questi aspetti:
- Che cosa è stato misurato: ICMP Echo, dimensione dei pacchetti e numero di campioni.
- Come è stato misurato: intervallo, limite di attesa e statistiche riportate.
- Dove è stato misurato: sistema di origine, destinazione e percorso in ciascuna direzione.
- Quale decisione occorre prendere: indagare ritardo, perdita, variazione o capacità di trasferimento.
La limitazione delle risposte ICMP può influire sulle misurazioni ping. Può accadere anche il contrario: un test piccolo può ricevere buone risposte mentre un trasferimento sostenuto funziona male. La conclusione più solida combina PingER con il problema osservato e con una misurazione adatta, senza confondere un segnale di rete con una spiegazione definitiva.