A autonomia é sempre demonstrada para uma tarefa
Chamar um robô de «autónomo» sem especificar o que faz deixa por responder a pergunta importante: autónomo para realizar que tarefa, em que condições e com que ajuda? Um sistema pode deslocar-se por um corredor conhecido sem assistência e, ainda assim, precisar de supervisão quando os obstáculos ou o espaço disponível mudam. Por isso, é preferível tratar a autonomia como uma capacidade ligada a uma tarefa e a um contexto, e não como uma propriedade universal do aparelho. Esta precisão também evita comparar capacidades diferentes como se fossem equivalentes apenas por serem descritas com a mesma palavra. Uma afirmação útil deixa claro o que o robô fez, em que circunstâncias e qual foi, se houve, o papel de uma pessoa.
Esta distinção também importa ao ler anúncios. Concluir uma sequência preparada pode demonstrar que o robô a executou naquelas circunstâncias; por si só, não prova que resolverá tarefas diferentes, reagirá a alterações imprevistas ou trabalhará sem supervisão durante períodos prolongados. A conclusão prudente é delimitada: as evidências sustentam aquilo que foi testado, não uma capacidade geral que não foi medida. Uma apresentação clara deve mostrar a fronteira entre o que foi observado e aquilo que ainda não se pode concluir. Esta delimitação não desvaloriza uma demonstração; permite descrever com rigor o que ela comprova.
Como ponto de partida para avaliar qualquer afirmação, deve pedir-se uma definição operacional: o que conta como conclusão da tarefa, que condições estavam presentes e que ajuda era permitida? Sem essa definição, uma taxa de sucesso — mesmo aparentemente elevada — não tem uma interpretação clara. O objetivo não é reduzir a autonomia a um único número, mas fazer com que qualquer número venha acompanhado do cenário e das regras que lhe dão significado. Assim, o leitor compreende o que o resultado representa sem lhe atribuir um alcance maior. Uma definição específica da tarefa também facilita comparações posteriores, desde que as condições e os critérios sejam realmente comparáveis.
Descrever o cenário antes de comparar resultados
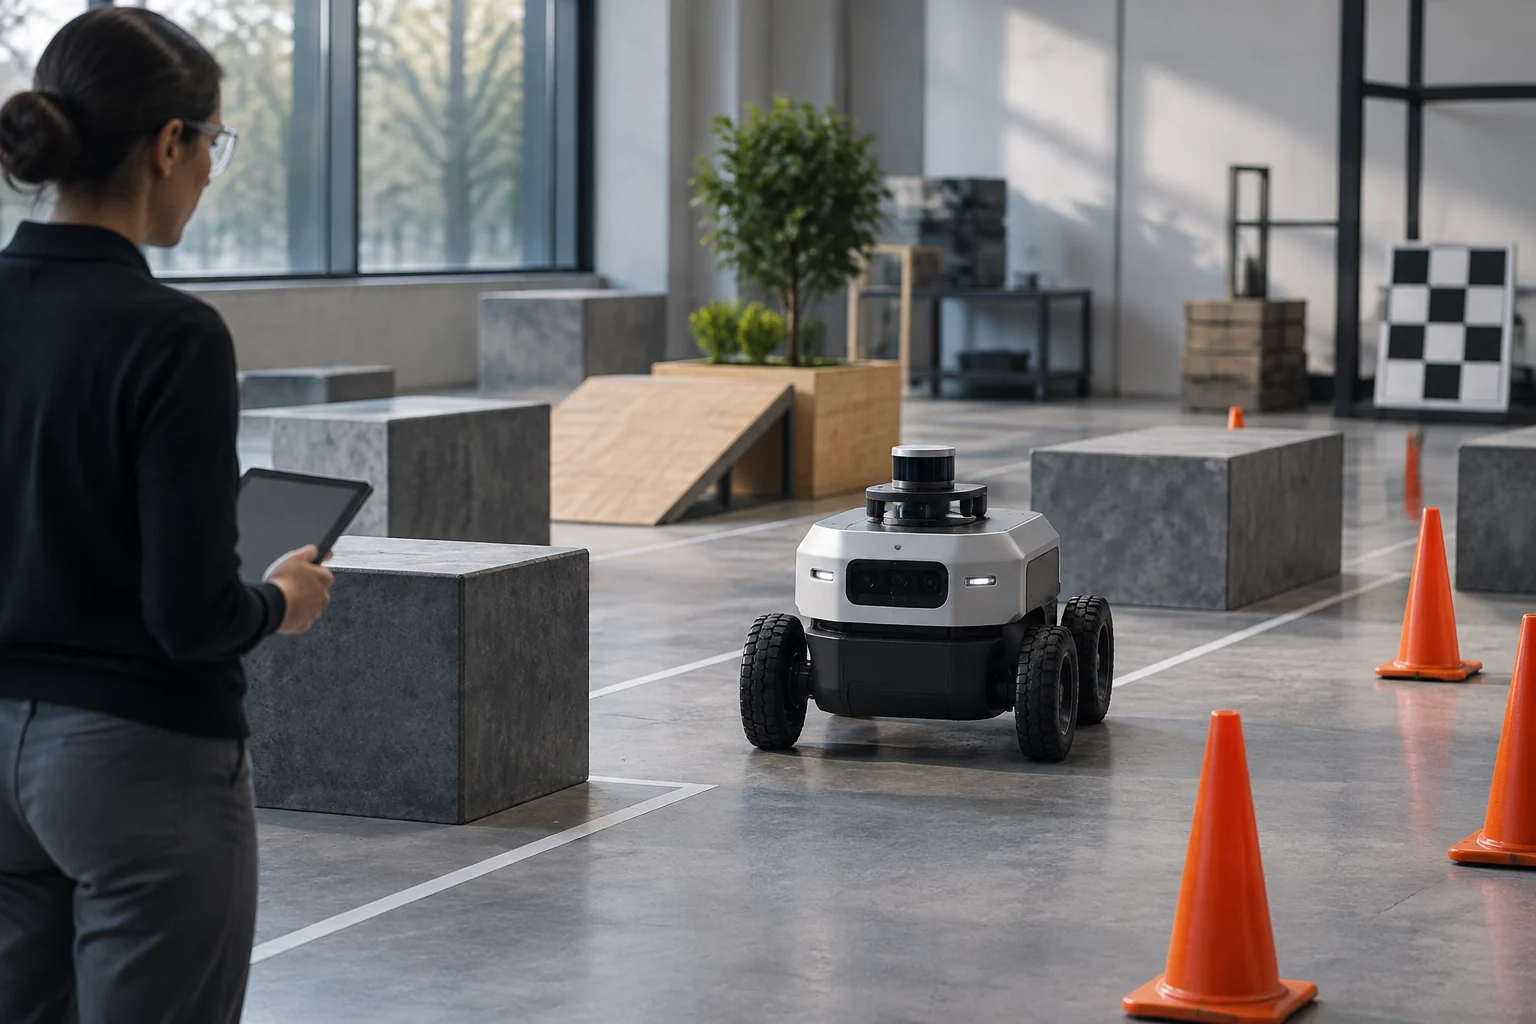
Um teste interpretável deve explicar que tarefa foi solicitada e em que ambiente decorreu. No caso de um robô móvel, isso pode incluir o tipo de superfície, o percurso, os obstáculos e o espaço disponível; numa tarefa de manipulação, os objetos e a sua disposição. Também é importante indicar se o ambiente se manteve igual entre tentativas ou se foram introduzidas variações. Estes elementos não são pormenores metodológicos decorativos: determinam que capacidade foi avaliada. Ao conhecê-los, é possível distinguir uma execução em condições estáveis de outra exposta a mudanças relevantes e perceber o que os resultados podem sustentar de forma razoável.
Avaliar a eficiência de um robô de vigilância é o tema de um artigo da Star Robotics. O seu âmbito é específico: não permite transferir automaticamente critérios de avaliação para todos os tipos de robô, nem substitui a descrição da tarefa examinada. A referência pode orientar a leitura nessa área, mas não responde, por si só, a todas as perguntas sobre outras utilizações. Para contextualizá-la, consulte o artigo original: https://star-robotics.com/como-evaluar-la-eficiencia-de-un-robot-de-vigilancia/. Ao recorrer à fonte, importa manter presente o âmbito que ela própria identifica: uma referência sobre robôs de vigilância não se transforma implicitamente numa evidência sobre todos os sistemas robóticos.
O número de tentativas e as condições iniciais também devem ser claros. Uma execução bem-sucedida numa única demonstração não permite saber se o resultado é repetível. Se forem publicados valores médios, é útil indicar quantas tentativas incluem e como foram escolhidas. As fontes verificadas para esta análise não estabelecem um número mínimo universal de repetições; por isso, é preferível exigir transparência e contexto em vez de apresentar uma quantidade arbitrária como regra padrão. Comunicar as condições permite avaliar a média sem a confundir com uma garantia de desempenho em qualquer circunstância. As repetições acrescentam evidências úteis, mas o seu significado depende sempre do que foi repetido e de como o teste foi conduzido.
Sucessos, falhas e ajuda humana: métricas que contam a história
A taxa de sucesso é uma métrica intuitiva, desde que «sucesso» seja definido antes de os resultados serem observados. A tarefa é considerada concluída se o robô chegar ao destino, embora tenha embatido num obstáculo? Conta como sucesso se uma pessoa reposicionar um objeto ou indicar ao robô como prosseguir? Uma avaliação útil esclarece estes critérios e separa as tentativas concluídas sem ajuda daquelas que precisaram de assistência ou acabaram em falha. Se os critérios mudarem entre testes, as taxas resultantes deixam de descrever o mesmo tipo de resultado. Um número sem definição pode parecer preciso e, ainda assim, deixar por esclarecer a questão central.
As intervenções humanas merecem especial atenção. Há uma diferença entre supervisionar por segurança, dar uma instrução normal ao sistema e assumir o controlo para corrigir uma trajetória. Se tudo isso for resumido como «funcionamento autónomo», perde-se informação necessária para comparar testes. Convém especificar que tipo de ajuda era permitido e quando ocorreu, em vez de agrupar situações diferentes sob um único rótulo. Também é útil indicar se a intervenção foi pontual ou necessária para concluir a tarefa. Um registo transparente permite distinguir supervisão de correção direta, sem tratar qualquer presença humana como irrelevante ou decisiva.
Além do resultado final, pode ser útil registar os tipos de erro, o tempo ou a duração da tarefa e a recuperação após uma falha, quando forem pertinentes. Não se deve presumir que uma métrica específica é adequada a todos os casos: na navegação, podem importar os desvios ou a deteção de obstáculos; na manipulação, o resultado e a estabilidade da sequência. A métrica deve acompanhar a tarefa, não o título que se pretende defender. Apresentar várias medidas pertinentes permite descrever melhor o desempenho, sem fingir que um número isolado resume todos os seus aspetos. A escolha das medidas deve, portanto, ser explicada em função da tarefa, e não apresentada como uma lista universal.
Da demonstração à utilização fora do ambiente testado
Um teste controlado ajuda a isolar uma capacidade, mas não garante que o comportamento se mantenha quando o ambiente muda. A diferença entre estes contextos deve ser apresentada como um limite do alcance das evidências, e não como prova automática de que o robô falhará em condições reais. Para avaliar até que ponto os resultados podem ser generalizados, é preciso saber que elementos variaram, quais permaneceram fixos e se a avaliação incluiu situações diferentes das utilizadas durante o desenvolvimento. Quanto mais clara for essa descrição, mais fácil será perceber que mudanças foram abrangidas e quais continuam por testar. Uma afirmação não deve ir além das condições que o teste efetivamente representa.
The Colosseum é um benchmark de investigação sobre generalização na manipulação robótica. O artigo descreve uma avaliação dessa generalização nessa área; é, portanto, um exemplo de trabalho com um âmbito delimitado, não uma garantia de que os resultados se aplicam a qualquer plataforma ou tarefa. O título e o registo académico podem ser consultados em https://arxiv.org/html/2402.08191v2. O valor metodológico de um benchmark depende de se verificar que tarefas e condições inclui antes de extrapolar os seus resultados para outros contextos. Um benchmark pode contribuir para a avaliação sem constituir uma medida universal de autonomia.
As comparações entre simulação e hardware real devem ser descritas com cuidado, sem tratar os dois como equivalentes. Um resultado obtido em simulação pode ajudar a explorar configurações ou a repetir condições, mas não deve ser apresentado como uma medição física se o robô não executou o teste. Se um anúncio combinar dados dos dois ambientes, a distinção deve ficar visível. O contexto da medição faz parte do resultado: sem ele, um número não permite avaliar até que ponto o teste se assemelha à utilização descrita. Identificar o ambiente em que cada resultado foi obtido evita atribuir a um teste propriedades que não mediu.
O que as fontes de avaliação contribuem — e o que deixam de fora
As fontes verificadas para esta análise não documentam um padrão comum que abranja a autonomia de todos os robôs. O artigo da Star Robotics trata da avaliação da eficiência de robôs de vigilância, enquanto The Colosseum aborda a generalização em tarefas de manipulação robótica. São referências com âmbitos diferentes; nenhuma deve ser apresentada como um protocolo universal para navegação, manipulação e outras utilizações. O seu valor está nas questões específicas que abordam, não numa pretensão de responder a todas as perguntas sobre autonomia robótica.
Esse âmbito concreto é, ao mesmo tempo, uma qualidade e um limite. Uma avaliação aplicada a robôs de vigilância não demonstra automaticamente aptidão para outras tarefas, segurança em todos os ambientes ou capacidade para realizar trabalhos prolongados. Do mesmo modo, os resultados de um benchmark de manipulação não garantem o mesmo desempenho na navegação ou noutras plataformas. As afirmações devem manter o alcance permitido pelos métodos e experiências descritos. Delimitar uma referência não significa rejeitá-la: ajuda a utilizá-la no tema que aborda e impede que seja transformada em apoio para conclusões alheias. Esta distinção é especialmente importante quando um termo amplo como «autonomia» é usado para aplicações muito diferentes.
Também não basta citar um artigo para transformar uma capacidade específica em autonomia geral. É preciso verificar que tipo de robô e que tarefa a fonte aborda, que indicadores utiliza e que aspetos deixa de fora. As referências disponíveis ilustram temas específicos — eficiência de robôs de vigilância e generalização na manipulação —, mas não permitem, por si só, estabelecer um método comum de certificação. Manter esta distinção protege a precisão da análise e facilita a verificação da origem de cada conclusão. Também ajuda a identificar com clareza que evidências adicionais seriam necessárias para sustentar uma afirmação mais abrangente.
Perguntas para avaliar um anúncio sem extrapolar
Antes de comparar dois robôs, convém verificar se os testes dizem respeito a tarefas e cenários suficientemente semelhantes. Uma taxa de sucesso obtida num ambiente desimpedido não equivale diretamente a outra registada com obstáculos variáveis. Também é importante saber se o resultado corresponde a execuções físicas, a simulação ou a uma combinação, e se foram divulgados tanto os sucessos como as tentativas falhadas. Sem essa informação, uma comparação pode parecer precisa e ser, na realidade, pouco informativa. A semelhança entre as condições de teste é tão importante como a forma de apresentar os resultados, pois números parecidos podem descrever situações muito diferentes.
O leitor pode fazer perguntas simples: que tarefa foi definida? Como se decidiu que estava concluída? Quantas vezes foi repetida? Que variações foram testadas? Quando interveio uma pessoa? Como foram registados os erros? Se for citado um estudo, que robô, tarefa e métodos abrangia? Estas perguntas não pressupõem má-fé nem exigem que todos os anúncios publiquem um estudo académico. Ajudam a distinguir uma demonstração limitada de evidências mais abrangentes e a identificar rapidamente que informações faltam para interpretar uma afirmação com cuidado. Respostas claras tornam um anúncio mais informativo sem exagerar aquilo que as evidências demonstram.
A conclusão deve manter o mesmo âmbito do teste. Se o robô navegou repetidamente num cenário descrito, é isso que se pode afirmar; se o teste também mediu obstáculos, desvios e recuperação, esses resultados podem ser acrescentados. A autonomia não se comprova com uma palavra, mas com evidências rastreáveis e limites explícitos. Esta cautela permite reconhecer progressos reais sem transformar um sucesso pontual numa promessa sobre tarefas que ainda não foram avaliadas. Em última análise, descrever com precisão o que foi feito e o que não foi torna mais útil qualquer afirmação sobre o desempenho.