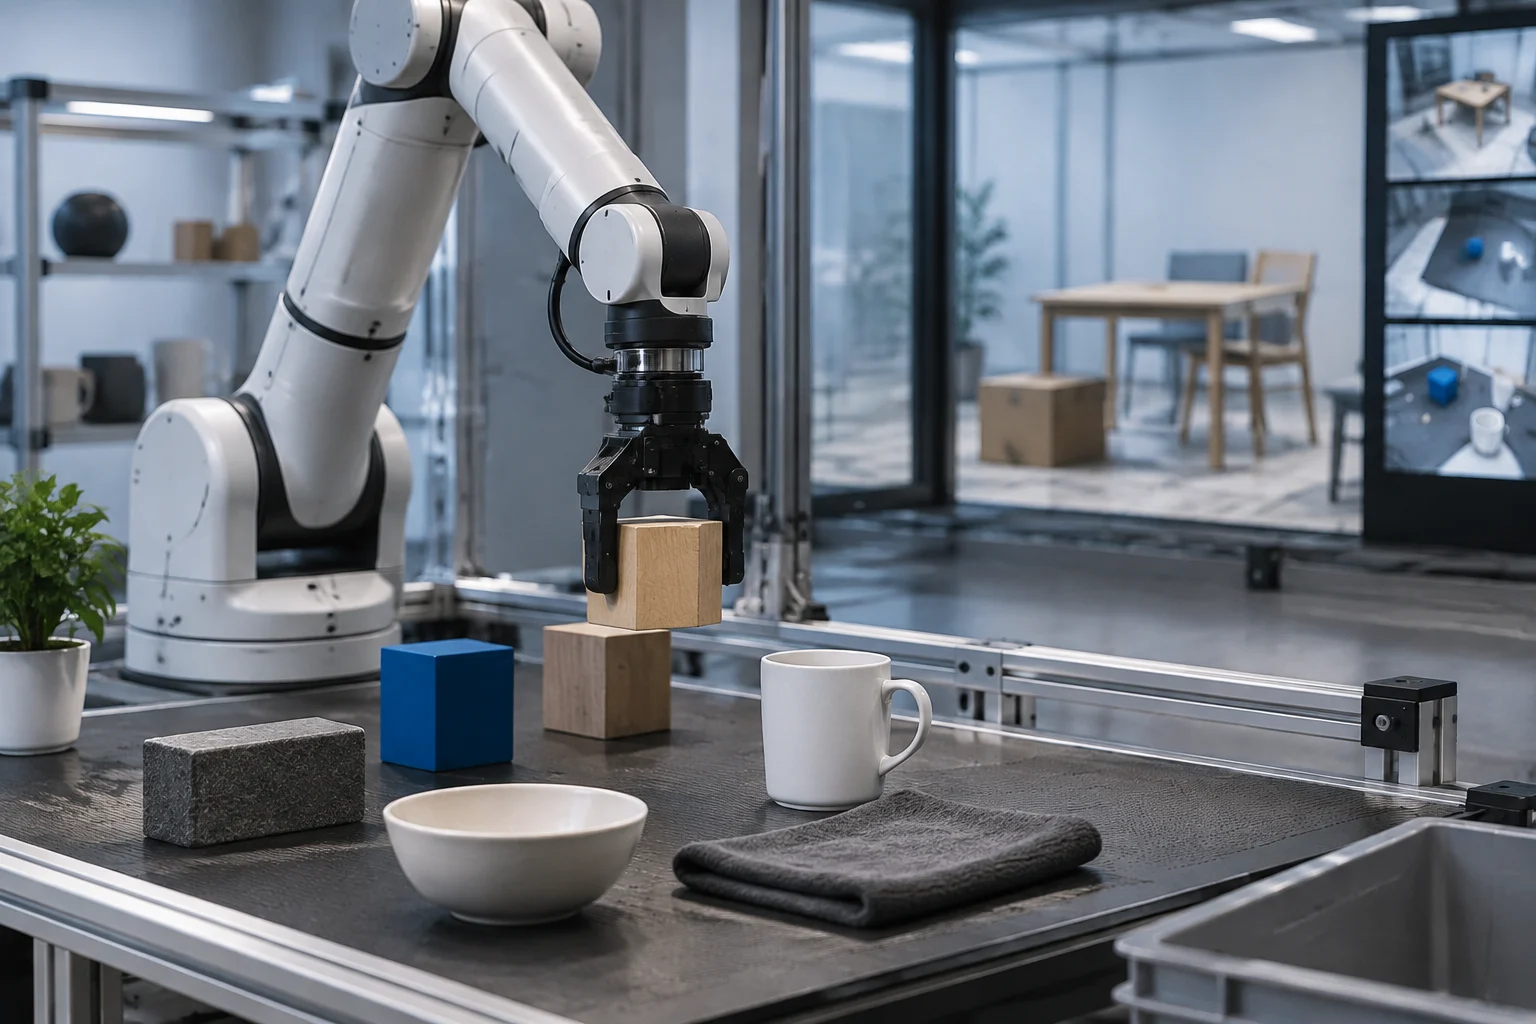
Uma pontuação responde a uma pergunta delimitada
Um benchmark organiza uma avaliação em torno de tarefas e condições definidas. A pontuação descreve o resultado obtido nesse contexto; não é uma medida universal da capacidade de um robô. Antes de interpretar um número, convém descobrir que sistema foi avaliado, o que tinha de fazer e em que condições o teste foi realizado. Também é útil separar aquilo que o relatório mede daquilo que se poderia apenas inferir a partir da medição. A pontuação ganha significado quando é lida em conjunto com o protocolo que a produziu.
Esta cautela é importante quando os resultados são apresentados como “melhores” ou “mais bem-sucedidos”. Uma diferença entre pontuações pode refletir diferenças entre sistemas, mas também entre tarefas, objetos, sensores, critérios de sucesso ou procedimentos. Se as avaliações não partilharem condições suficientes, uma tabela ordenada não permite atribuir com segurança a diferença a uma única causa. Ainda pode ser útil descrever cada resultado separadamente; o que fica limitado é a comparação direta. Um número pode parecer preciso e, ainda assim, deixar por esclarecer exatamente o que foi comparado. Por isso, comparar exige olhar para além da ordem da tabela e verificar que elementos permaneceram constantes.
Um artigo de investigação intitulado “Real-Time Systems Evaluation for Robotics Using the Hart-ROS Benchmark” aborda a avaliação de sistemas em tempo real para robótica por meio do Hart-ROS. O título identifica o tema, mas não basta para atribuir ao trabalho resultados sobre manipulação, generalização ou desempenho fora do laboratório; para sustentar essas afirmações seria necessário analisar os métodos e os resultados. Outro trabalho propõe um protocolo de avaliação da manipulação robótica baseado em puzzles, configurável de acordo com as tarefas e utilizável em diferentes níveis de análise. Leia cada pontuação como resposta a uma pergunta concreta, não como um veredicto sobre o sistema inteiro.
Tarefas e ambientes: meça a distância em relação ao uso previsto
Comece pela tarefa. Identifique as ações que o robô tem de executar, os objetos envolvidos, como começa cada tentativa e que condições contam como sucesso. Verifique também se a avaliação considera uma ação isolada ou uma sequência completa. Uma tarefa pode ter o mesmo nome de uma aplicação real e, ainda assim, diferir na variedade de objetos, nas condições iniciais ou na tolerância a erros. A semelhança deve ser julgada com base no que o protocolo descreve, não apenas no rótulo. Analisar estes elementos permite especificar que parte da aplicação está representada no teste e que parte não está descrita.
Em seguida, verifique que variações estão incluídas no ambiente. Mudam a posição, a aparência ou o tipo de objeto? Variam a iluminação ou a disposição do espaço? São testadas condições diferentes das utilizadas para preparar o sistema? Se a publicação não esclarecer estes pontos, não é possível concluir que o resultado demonstra robustez perante essas variações. Essa ausência limita aquilo que o relatório permite afirmar; não prova que o robô irá falhar. Distinga também as variações que fazem parte da avaliação daquelas que poderiam ocorrer na aplicação: não são equivalentes. A questão é saber que variações foram efetivamente testadas, e não quais se poderiam imaginar a partir de uma descrição geral.
A pergunta útil não é se um teste parece realista em abstrato, mas que aspetos do cenário de interesse reproduz e quais deixa de fora. Uma avaliação controlada pode servir para comparar sistemas numa capacidade delimitada, sem estabelecer como funcionarão perante objetos diferentes ou condições variáveis. Registe essa distância antes de usar uma pontuação para tomar uma decisão prática. Não é necessário desvalorizar um teste por ser controlado: basta delimitar a conclusão que o seu desenho permite sustentar. A semelhança superficial entre um teste e uma aplicação não substitui a comparação das respetivas condições.
Métricas e protocolo: compreenda o que conta como sucesso
Uma métrica resume uma dimensão do resultado, não necessariamente todas as dimensões importantes. Uma taxa de sucesso pode contar quantas tentativas atingiram determinado critério. Por si só, não informa necessariamente sobre o tempo gasto, as intervenções necessárias ou as consequências das falhas. Para avaliar uma aplicação concreta, o critério de sucesso e as medidas adicionais devem estar relacionados com a decisão que se pretende tomar. Se o estudo publicar apenas um número agregado, não lhe peça respostas que esse número não contém. Leia a definição da métrica antes de interpretar o nome com que é apresentada.
Verifique quantas tentativas foram realizadas e como foram preparadas e reiniciadas. É importante saber o que contou como episódio, se os testes foram repetidos e se os resultados variaram entre repetições. Quando faltam esses detalhes, não é possível reconstruir com precisão a estabilidade da estimativa. Uma média resume os dados disponíveis; por si só, não garante que o resultado se repita noutra sessão, com outra equipa ou em condições diferentes. O número de episódios e a forma como foram realizados fazem parte da interpretação, não são meros detalhes do procedimento. Se o relatório incluir informação sobre a variação entre tentativas, leia-a também em conjunto com o valor resumido.
Para comparar sistemas, procure condições partilhadas ou uma explicação clara das diferenças. Verifique se foram aplicadas as mesmas tarefas, instruções e regras para registar sucessos e falhas. Se o protocolo mudou, a comparação ainda pode ser informativa, mas a diferença não pode ser automaticamente atribuída ao robô. Uma classificação ordenada pela pontuação não corrige protocolos incompatíveis. Quando faltarem detalhes, especifique que conclusão fica limitada, em vez de preencher a lacuna com suposições. Assim, a limitação permanece visível e não é confundida com prova de que um sistema é melhor ou pior.
Simulação e hardware: distinga evidência de extrapolação
Um teste em simulação observa o comportamento do sistema nas condições dessa simulação. Por si só, não equivale a uma medição do comportamento de um robô físico. Ao comparar os dois contextos, verifique o que foi avaliado em cada um, que condições foram mantidas e como foi feita a comparação. A questão principal não é apenas saber se foi utilizada uma simulação, mas que evidências o estudo apresenta para relacionar os seus resultados com os obtidos em hardware real. Identifique separadamente o que foi observado em cada contexto, em vez de presumir que uma avaliação substitui a outra. Esta distinção evita apresentar como medição física uma observação feita apenas em simulação.
Entre as fontes identificadas está REALM, cujo título descreve um benchmark validado do real para a simulação destinado a estudar a generalização na manipulação robótica. O título identifica o propósito geral do trabalho, mas não confirma por si só que resultados obteve nem que condições específicas verificou. Do mesmo modo, saber que um projeto aborda uma relação entre simulação e realidade não significa dispor de evidências suficientes para concluir que uma pontuação simula o desempenho físico. Para avaliar um caso concreto, é necessário analisar o protocolo e os resultados.
A documentação disponível para esta análise não permite descrever em detalhe nem validar um protocolo específico de transferência da simulação para o hardware. A cautela diz respeito, portanto, ao alcance das evidências que podemos estabelecer aqui, e não a uma conclusão geral a favor ou contra essa transferência. Ao ler um estudo, separe o método proposto das evidências que apresenta sobre a sua capacidade de antecipar resultados físicos. O objetivo de transferir resultados não é o mesmo que demonstrar que a transferência ocorre.
Generalização: o que uma melhoria permite afirmar
No mínimo, uma melhoria observada num teste permite afirmar que o resultado daquela avaliação mudou nas condições consideradas. Para falar de generalização, são necessários testes que examinem variações relevantes para o uso previsto e informação suficiente para saber quais foram testadas. Para falar de utilidade operacional, além disso, as medidas têm de corresponder aos aspetos importantes desse uso ou ser acompanhadas por evidências pertinentes. São conclusões relacionadas, mas não intercambiáveis. Assim, uma melhoria numa condição específica pode ser informativa sem esclarecer se se mantém quando as condições relevantes mudam.
Ao ler um artigo, registe a tarefa e o critério de sucesso; o robô e os sensores; o ambiente e as variações incluídas; as métricas; o número de episódios e as regras de comparação. Depois, anote o que falta e como isso limita a interpretação. Desta forma, distingue-se a informação ausente de um resultado negativo: o facto de um fator não ser descrito não significa que o sistema tenha falhado nesse aspeto. O registo também facilita a comparação entre artigos sem apagar as diferenças entre protocolos. Se uma característica não for especificada, assinale-a como desconhecida, em vez de a tratar como uma condição que foi avaliada.
As fontes consultadas descrevem diferentes abordagens de benchmark, mas não permitem estabelecer uma regra geral sobre até que ponto os resultados predizem o desempenho fora do laboratório. Por isso, este artigo oferece um método de leitura, não uma classificação de testes nem uma garantia sobre um método concreto. A utilidade do método está em tornar explícitas as perguntas a que uma pontuação não responde por si só. Uma pontuação orienta quando se conhece o seu alcance; para extrapolar, procure evidências correspondentes ao cenário que lhe interessa.