Definição canônica: o que constitui um sistema de IA
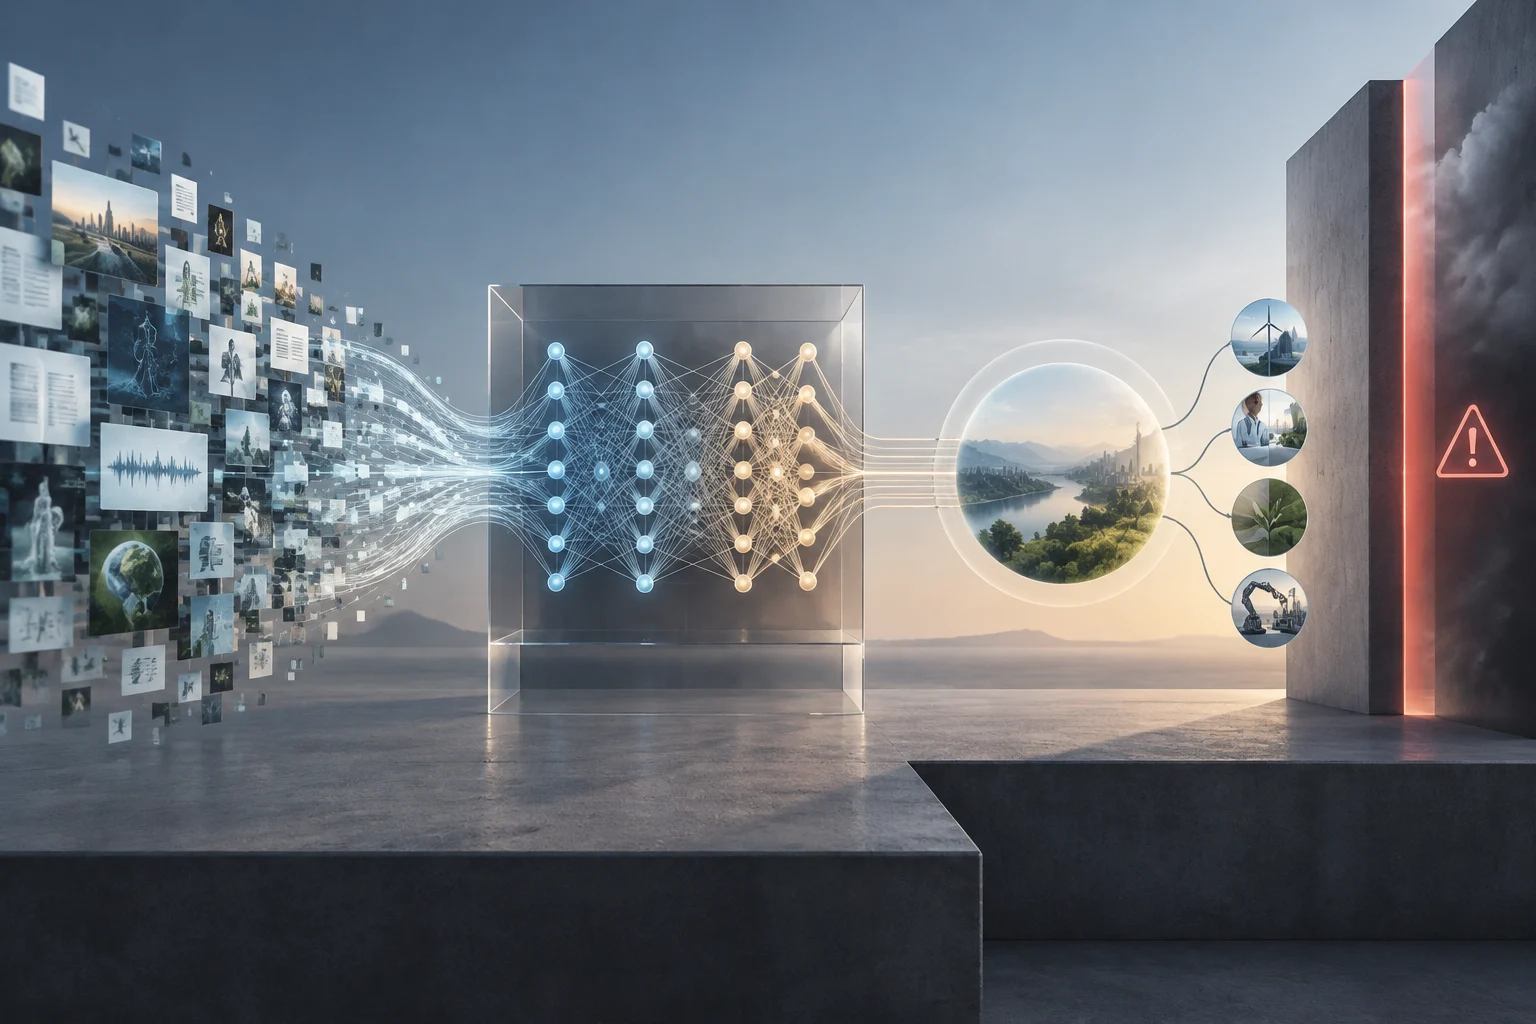
A inteligência artificial é definida como o campo da informática dedicado a criar sistemas capazes de realizar tarefas que tradicionalmente requerem inteligência humana, como a percepção, o raciocínio, o aprendizado e a compreensão da linguagem natural. Esta definição, apoiada por organismos como a União Europeia e empresas de tecnologia, estabelece que não se trata de uma única tecnologia, mas de um conjunto de métodos que permitem às máquinas processar informações e tomar decisões.
O Regulamento Europeu de Inteligência Artificial (AI Act), que entrou em vigor em fevereiro de 2025, oferece um marco legal para classificar esses sistemas de acordo com seu nível de risco. A regulamentação distingue entre sistemas de propósito geral e específicos, estabelecendo obrigações para os fornecedores e usuários. Esta regulamentação busca garantir que o desenvolvimento da IA seja transparente, seguro e respeitoso com os direitos fundamentais, marcando um padrão global para a indústria.
Diferença com a programação tradicional
Ao contrário de um programa tradicional, onde cada regra é pré-programada explicitamente por um desenvolvedor, um sistema de IA aprende padrões a partir de dados. Na programação clássica, se o critério muda, o código deve ser modificado manualmente. Na IA, o sistema ajusta seus parâmetros internos ao ser exposto a novos exemplos, o que lhe permite adaptar-se a situações que não estavam previstas em seu design inicial.
Mecanismos de funcionamento: do dado à decisão
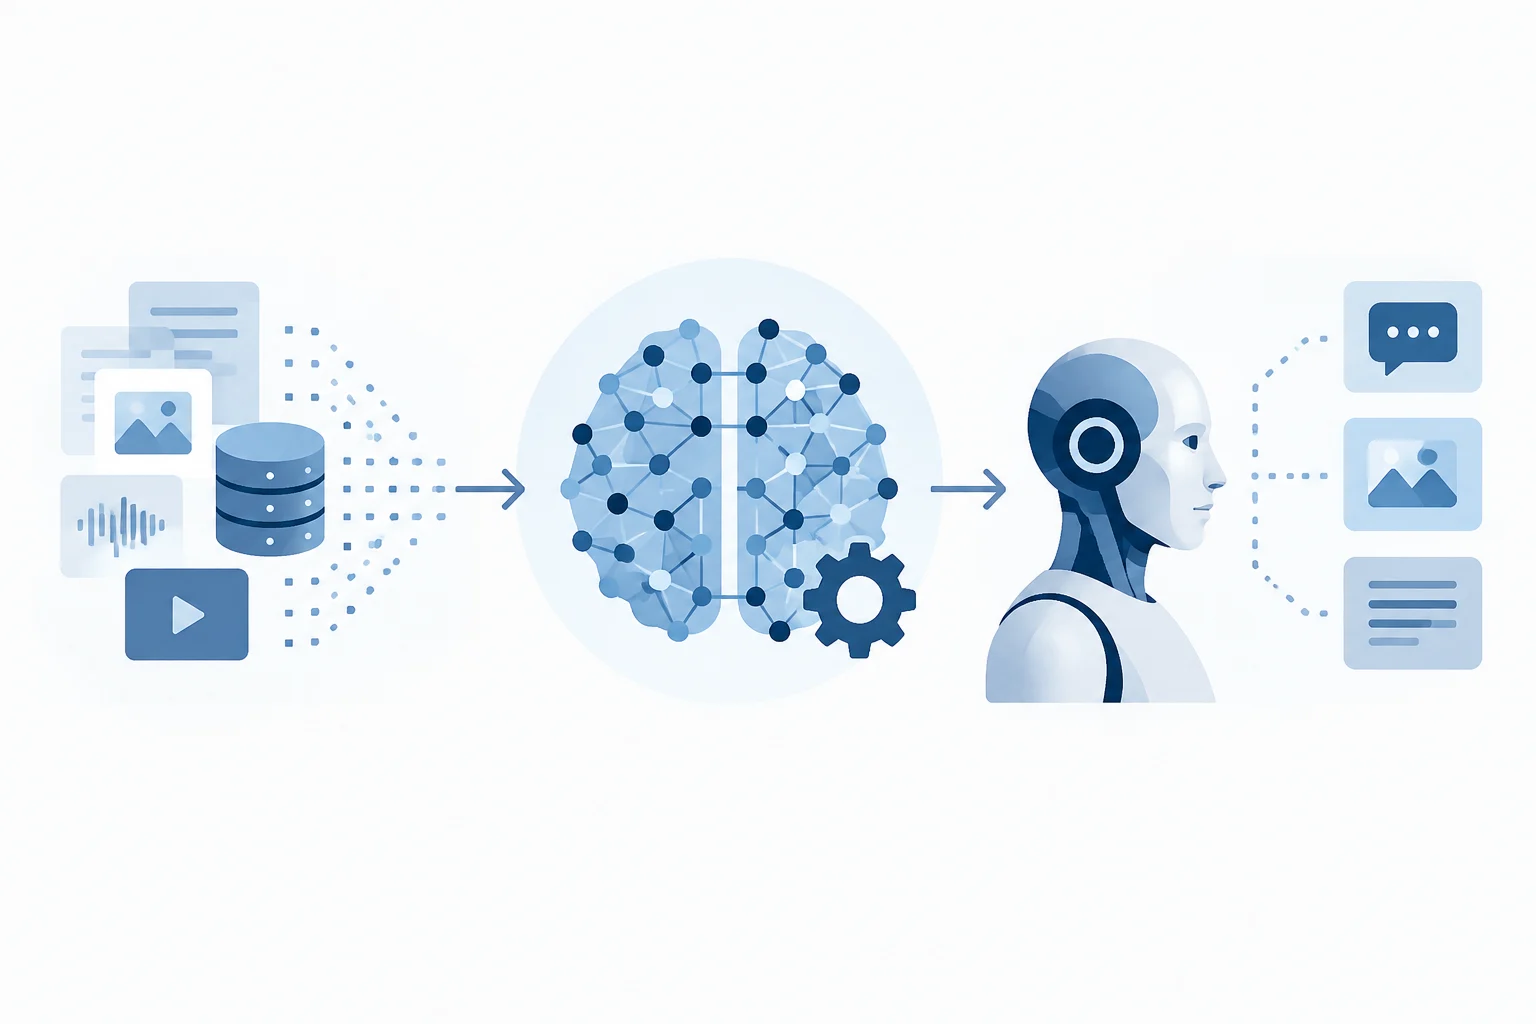
O funcionamento de um sistema de IA baseia-se no aprendizado de máquina (machine learning), um subconjunto da IA onde os sistemas identificam padrões em grandes volumes de dados sem serem programados explicitamente para cada caso. O processo começa com a coleta de dados, que são utilizados para treinar um modelo matemático. Este modelo ajusta seus parâmetros internos até que suas previsões se alinhem com os resultados esperados no conjunto de dados de treinamento.
Uma vez treinado, o modelo entra na fase de inferência, que é o momento em que o sistema aplica os padrões aprendidos a novos dados para gerar uma resposta ou decisão. Por exemplo, um modelo treinado com imagens de animais pode identificar uma raça de cachorro em tempo real, mesmo que nunca tenha visto aquela imagem específica antes. A qualidade da inferência depende diretamente da quantidade e da relevância dos dados utilizados no treinamento.
O ciclo de vida do modelo
O desenvolvimento de um sistema de IA segue um ciclo iterativo que inclui a coleta de dados, o treinamento, a validação, o despliegue e o feedback. A validação é crucial para medir a precisão do modelo em dados que ele não viu durante o treinamento, evitando o overfitting. O feedback permite atualizar o modelo com novos dados, melhorando seu desempenho ao longo do tempo.
Tipos de aprendizado de máquina
Dentro do aprendizado de máquina, existem três abordagens principais que se diferenciam por como os dados são estruturados e como o modelo recebe suas instruções. A escolha do método depende da natureza do problema e da disponibilidade de dados rotulados. Cada abordagem tem aplicações específicas e requisitos distintos em termos de qualidade e volume das informações de entrada.
A tabela a seguir compara os três tipos principais de aprendizado de máquina, destacando suas características, exemplos de aplicação e requisitos de dados:
| Tipo de aprendizado | Descrição | Exemplo de aplicação | Requisitos de dados |
|---|---|---|---|
| Supervisionado | O modelo aprende a partir de dados rotulados com a resposta correta. | Detecção de spam em e-mails. | Dados rotulados (entrada e saída esperada). |
| Não supervisionado | O modelo identifica padrões ou agrupamentos em dados não rotulados. | Segmentação de clientes em marketing. | Dados não rotulados, grandes volumes. |
| Por reforço | O modelo aprende por tentativa e erro, recebendo recompensas ou penalizações. | Robôs de navegação ou jogos de xadrez. | Ambiente simulado ou real com feedback contínuo. |
O aprendizado supervisionado é o mais comum em aplicações comerciais, pois permite avaliar a precisão do modelo de maneira objetiva. O não supervisionado é útil quando a estrutura dos dados é desconhecida ou se busca descobrir relações ocultas. O aprendizado por reforço é empregado em ambientes dinâmicos onde a ação do agente tem consequências imediatas que podem ser medidas.
IA fraca, IA forte e IA generativa
O campo da IA é tradicionalmente dividido em dois ramos: a inteligência artificial fraca (ou estreita) e a inteligência artificial forte (ou geral). A IA fraca é projetada para realizar tarefas específicas, como o reconhecimento de voz em um assistente virtual ou a recomendação de produtos em uma plataforma de comércio eletrônico. A maioria das aplicações atuais pertence a esta categoria, pois são mais fáceis de desenvolver e avaliar.
A IA forte (AGI, em inglês) aspira a emular a inteligência humana em sua totalidade, permitindo à máquina raciocinar, adaptar-se e aprender de maneira semelhante a uma pessoa. Este tipo de IA ainda se encontra em fase de pesquisa e não foi alcançado por nenhum sistema comercial. A distinção é importante para evitar expectativas irreais sobre as capacidades atuais da tecnologia.
IA generativa vs. IA analítica
Nos últimos anos, a IA generativa ganhou protagonismo, um subconjunto da IA que cria conteúdo novo (texto, imagens, código) a partir dos padrões aprendidos. Diferentemente da IA analítica, que classifica ou prevê, a IA generativa produz saídas criativas. Modelos como o GPT-4 da OpenAI são exemplos de IA generativa, utilizados para redigir textos, gerar código ou criar imagens. Esta capacidade ampliou o alcance da IA em setores criativos e de desenvolvimento de software.
Usos práticos e exemplos explicados
A inteligência artificial é aplicada em diversos setores, da saúde à indústria. No âmbito médico, os sistemas de IA ajudam no diagnóstico por imagem, analisando radiografias ou ressonâncias para detectar anomalias que poderiam passar despercebidas pelo olho humano. Estes sistemas não substituem o médico, mas atuam como uma ferramenta de apoio que agiliza o processo e reduz a carga de trabalho.
No setor financeiro, a IA é utilizada para a detecção de fraude, analisando transações em tempo real para identificar padrões suspeitos. No comércio eletrônico, os motores de recomendação sugerem produtos com base no histórico de compras e no comportamento do usuário. Na indústria, a IA otimiza a cadeia de suprimentos, prevê falhas em máquinas e automatiza processos de controle de qualidade.
Exemplo: diagnóstico médico
Um sistema de IA treinado com milhares de imagens de retinas pode detectar sinais de diabetes ou glaucoma com uma precisão comparável à de um especialista. O modelo analisa a imagem e gera uma probabilidade de doença, que o médico revisa e confirma. Esta abordagem permite escalar a capacidade de diagnóstico em zonas com escassez de especialistas, melhorando o acesso à atenção sanitária.
Limites, riscos e a necessidade de supervisão
Apesar de suas vantagens, a IA apresenta riscos significativos que devem ser gerenciados. Um dos mais destacados é a alucinação, fenômeno pelo qual um modelo generativo inventa informações que não existem ou são incorretas, apresentando-as com a mesma confiança que os dados reais. Isso ocorre porque o modelo prevê a próxima palavra ou elemento mais provável, sem verificar a veracidade das informações.
Outro risco importante é o viés nos dados de treinamento. Se os dados utilizados para treinar um modelo não são representativos da população-alvo, as recomendações do sistema podem favorecer ou prejudicar certos grupos. Por exemplo, um modelo de contratação treinado com dados históricos enviesados pode perpetuar a discriminação de gênero ou raça. A supervisão humana é imprescindível para detectar e corrigir esses vieses.
Dependência e desvanecimento do julgamento
A confiança excessiva nos sistemas de IA pode levar à dependência tecnológica, onde os profissionais adotam as sugestões do sistema sem revisá-las criticamente. Isso é especialmente preocupante em setores críticos como a saúde ou a justiça, onde um erro pode ter consequências graves. A formação dos usuários e a implementação de protocolos de verificação são essenciais para mitigar este risco.
Glossário básico de termos-chave
Para compreender a IA, é útil familiarizar-se com alguns termos técnicos. Um modelo é a representação matemática que o sistema utiliza para fazer previsões. Um dataset (conjunto de dados) é a coleção de informações com a qual o modelo é treinado. A inferência é o processo de aplicar o modelo treinado a novos dados para obter uma resposta.
O treinamento é a fase em que o modelo ajusta seus parâmetros para minimizar o erro nos dados de treinamento. A validação é o processo de avaliar o modelo com dados que ele não viu durante o treinamento, para medir sua capacidade de generalização. O overfitting ocorre quando o modelo memoriza os dados de treinamento em vez de aprender padrões gerais, o que reduz seu desempenho em dados novos.
Importância da qualidade dos dados
A qualidade dos dados é determinante para o sucesso de um sistema de IA. Dados incompletos, ruidosos ou enviesados podem levar a modelos imprecisos ou injustos. A governança de dados implica estabelecer processos para garantir a qualidade, a privacidade e a segurança das informações utilizadas no treinamento e na inferência. Sem uma base de dados sólida, mesmo o algoritmo mais avançado não poderá funcionar corretamente.