Was lokale Inferenz bedeutet
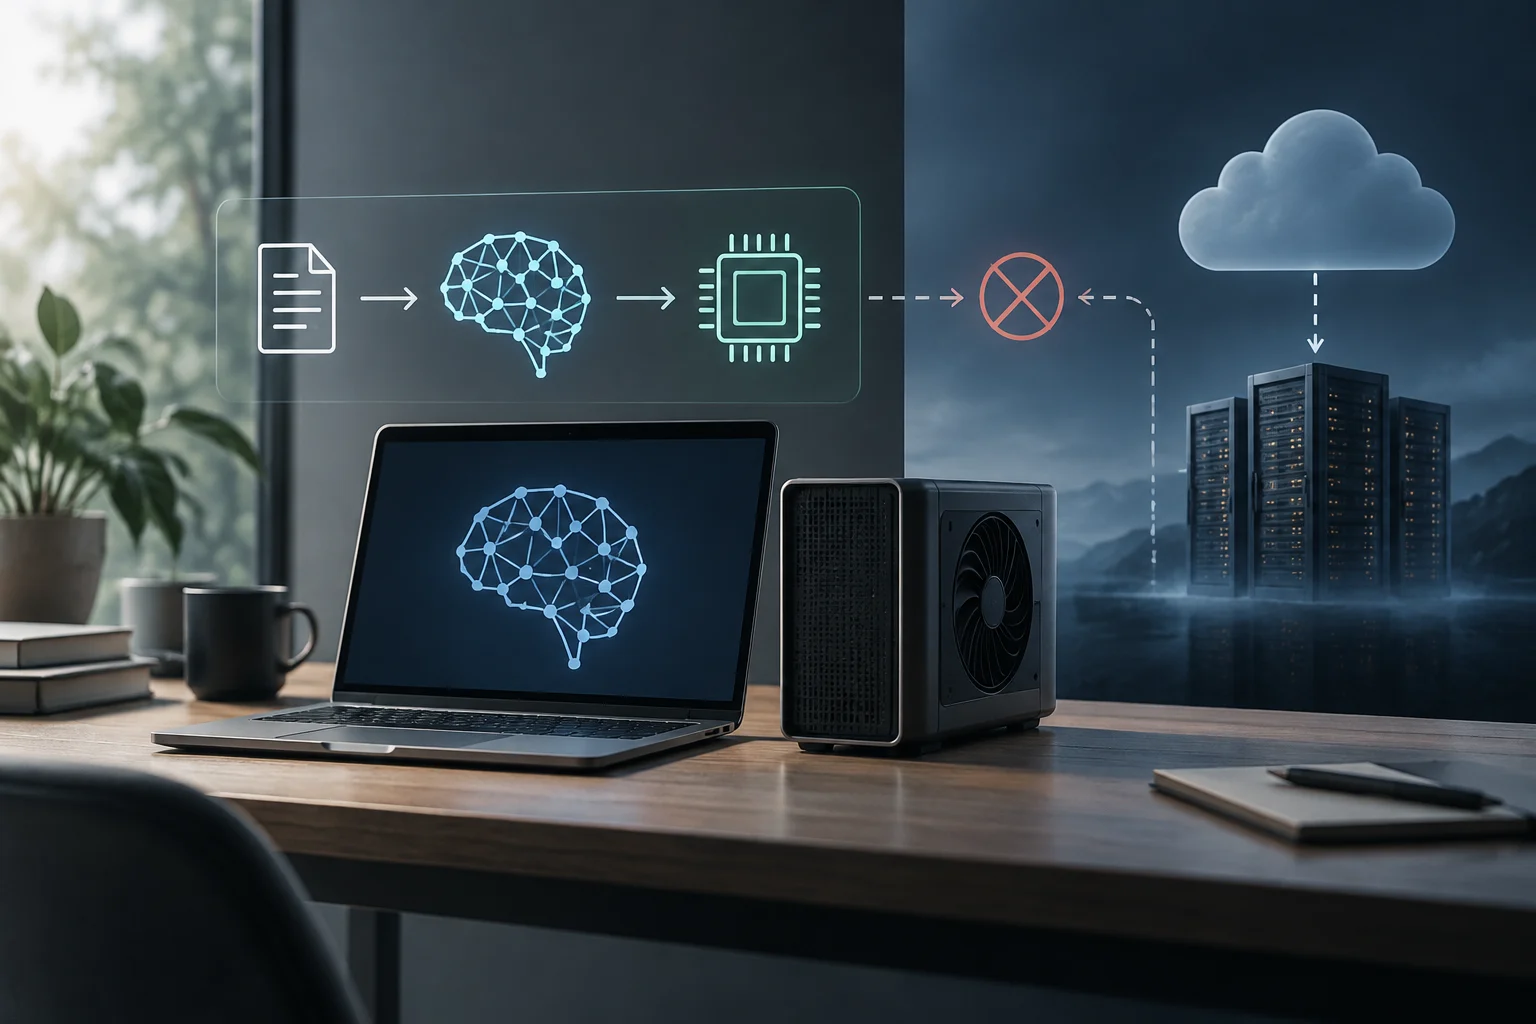
Lokale Inferenz bezeichnet die Ausführung eines Modells für künstliche Intelligenz auf dem Gerät eines Nutzers oder auf einer Infrastruktur, die dessen Organisation kontrolliert. Das Modell wurde bereits trainiert: Es erhält eine Eingabe, berechnet eine Antwort und gibt sie zurück. Ein Textassistent kann beispielsweise einen Text fortsetzen, eine Kamera ein Bild klassifizieren.
Das Wort lokal beschreibt den Ort der Berechnung, nicht, wer das Modell erstellt oder wie es bezogen wurde. Ein Modell mit offenen Gewichten, das aus einem Repository heruntergeladen wurde, kann auf einem eigenen Computer laufen; ebenso ein von einem Anbieter bereitgestelltes Modell. Entscheidend ist, dass die Anfrage auf dem Gerät oder in der lokalen Umgebung verarbeitet wird, statt zur Antworterzeugung an einen entfernten Dienst zu gehen.
Inferenz ist nicht mit Training gleichzusetzen. Beim Training werden Modellparameter anhand von Daten angepasst; bei der Inferenz erzeugt ein bereits vorbereitetes Modell eine Ausgabe für eine neue Eingabe. Zur Inferenz können weitere Vorgänge gehören, etwa das Abrufen von Dokumenten oder der Aufruf eines Werkzeugs. Am grundlegenden Begriff ändert das nichts.
Der Ablauf einer Anfrage
In einer lokalen Anwendung wird zunächst ein kompatibles Modell ausgewählt und werden seine Dateien in den erforderlichen Speicher geladen. Die Anwendung bereitet die Eingabe vor – etwa indem sie ein Bild in die von einem Bildverarbeitungsmodell erwartete Darstellung umwandelt oder Text in Tokens zerlegt – und die Laufzeitumgebung verteilt die Berechnung auf verfügbare CPU, GPU oder andere Beschleuniger. Anschließend wandelt die Anwendung die interne Ausgabe in Text, Kennzeichnungen, Bewertungen oder ein anderes nutzbares Ergebnis um.
Von den Daten zur Antwort
Bei einem Sprachmodell wird Text in Tokens zerlegt und zusammen mit dem relevanten Kontext verarbeitet. Das Modell berechnet eine Verteilung möglicher nächster Tokens; das Generierungsverfahren wählt eines davon aus. Das Ergebnis hängt nicht nur von den Gewichten, sondern auch von Konfiguration, Kontext und Generierungsstrategie ab. Die Inferenz-Engine ersetzt das Modell nicht: Sie stellt die Umgebung bereit, die dessen Operationen lädt und ausführt.
Bei der Bildverarbeitung kann der Ablauf mit einem von einer Kamera aufgenommenen Bild beginnen. Das Programm passt es an die erforderliche Eingabegröße und das Format an, führt das Modell aus und wandelt dessen Ausgabetensoren in erkannte Objekte, Kategorien oder Koordinaten um. In Edge-Systemen wie Kameras oder Industrieanlagen kann das Gerät anschließend eine Warnung oder Zusammenfassung senden, statt die Originaldaten fortlaufend zu übertragen. Das kann Bandbreite sparen; ob das gelingt, hängt jedoch vom Aufbau der Anwendung und weiteren Übertragungswegen ab.
GPU, VRAM und RAM: Was die Modellausführung begrenzt
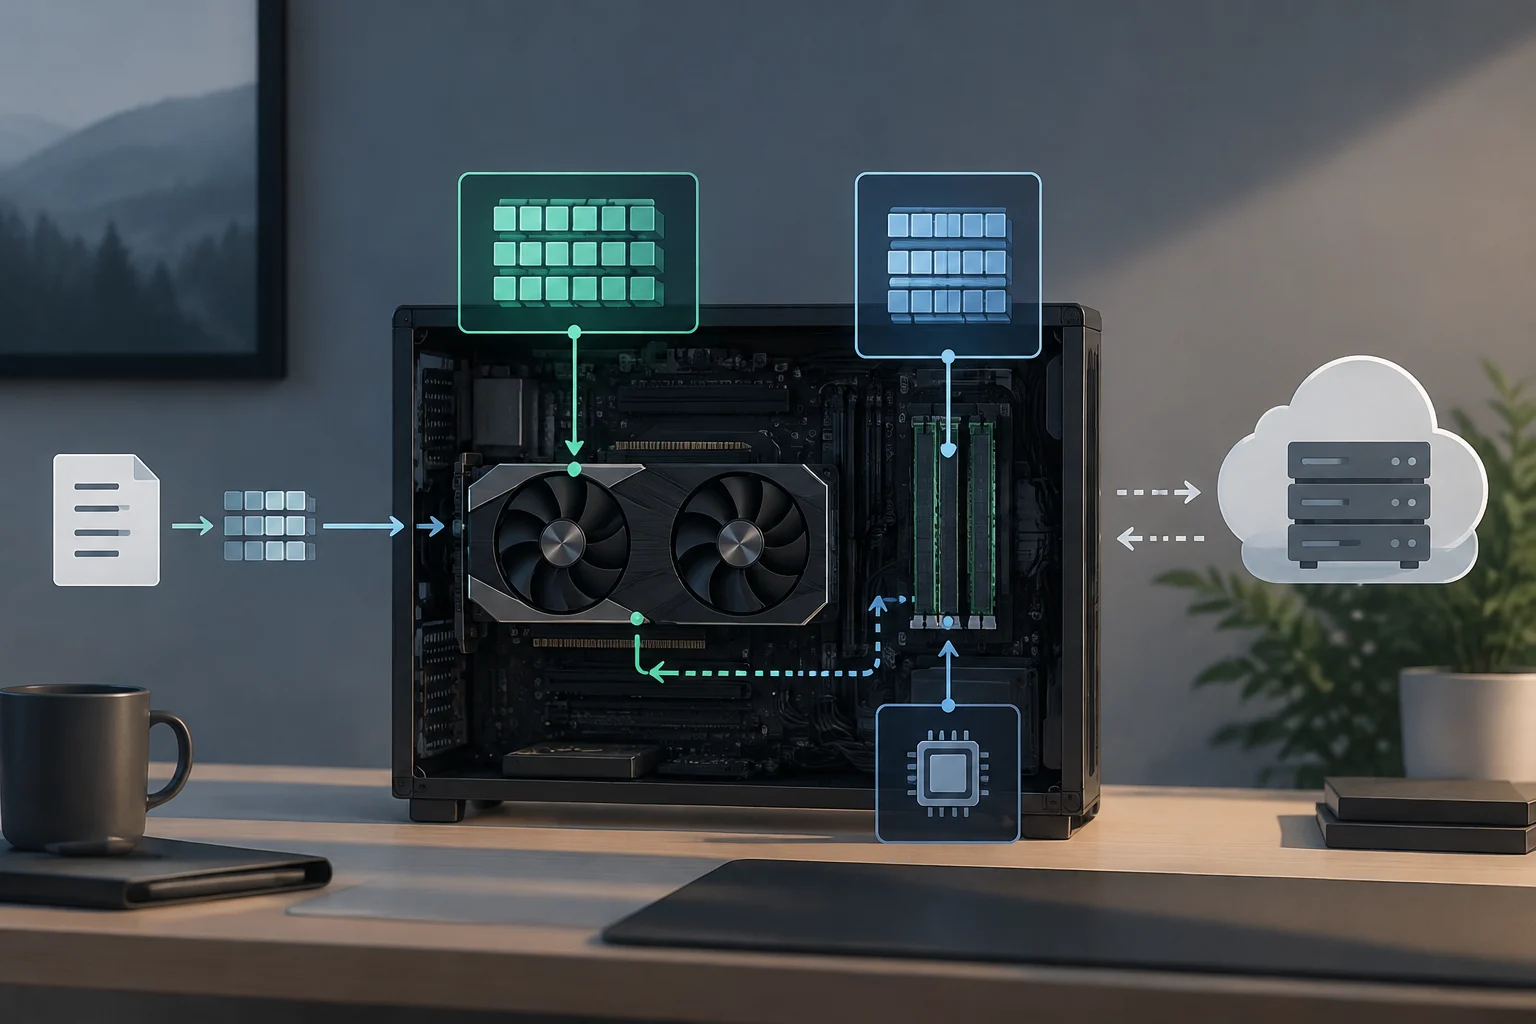
Ob ein Modell praktikabel ist, hängt davon ab, ob Modell und Arbeitsdaten in den verfügbaren Speicher passen und ob das Gerät die Berechnungen schnell genug durchführen kann. Bei einer dedizierten GPU speichert der VRAM die Gewichte und weitere Daten, die der Beschleuniger benötigt. Der System-RAM hält den Prozess, kann Teile des Modells enthalten und ermöglicht die Ausführung über die CPU oder unterstützt Konfigurationen, bei denen das Modell nicht vollständig in den GPU-Speicher passt. Die Ressourcen sind nicht ohne Kosten austauschbar: Datenverschiebungen zwischen Speichern können die Leistung mindern.
Eine GPU kann parallele Operationen beschleunigen, wie sie in neuronalen Netzen häufig vorkommen, ist aber nicht grundsätzlich erforderlich. Ein Modell kann auf einer CPU laufen, sofern Software und Format dies zulassen; meist ist das langsamer, aber nicht unbedingt unmöglich. Manche Geräte verfügen außerdem über eine NPU oder andere Beschleuniger, die nur dann genutzt werden können, wenn Laufzeitumgebung und Modell sie unterstützen. Die Kompatibilität des gesamten Systems ist ebenso wichtig wie die Bezeichnung einzelner Komponenten: Betriebssystem, Treiber, Modellformat und Laufzeit müssen zusammenarbeiten.
Die Dateigröße des Modells liefert einen ersten Anhaltspunkt, bildet aber nicht den gesamten Speicherbedarf während der Inferenz ab. Auch die Genauigkeit oder Quantisierung der Gewichte, die Kontextlänge, die Batch-Größe und während der Ausführung entstehender temporärer Speicher spielen eine Rolle. Bei einem Sprachmodell kann ein längerer Kontext den Speicherbedarf erhöhen. Es ist deshalb sinnvoller, Spielraum einzuplanen, als das Gerät exakt auf die Downloadgröße auszulegen.
Ein Hardwareleitfaden von PromptQuorum nennt eine Faustregel für bestimmte quantisierte Sprachmodelle: etwa 4–5 GB für ein Modell mit 7 Milliarden Parametern in Q4_K_M und etwa 40 GB für eines mit 70 Milliarden Parametern in dieser Quantisierung. Das sind Schätzungen für eine bestimmte Konfiguration, keine allgemeingültigen Anforderungen und keine Geschwindigkeitsgarantie. Format, Kontext und Laufzeitumgebung können den tatsächlichen Bedarf verändern. Prüfen Sie bei der Gerätewahl die Modellangaben und messen Sie die Leistung mit der vorgesehenen Arbeitslast.
Lokal oder Cloud: Unterschiede für die Entscheidung
Bei einer entfernten Inferenz sendet die Anwendung eine Anfrage über eine API an einen Server und erhält die Antwort über das Netzwerk zurück. Der Anbieter verwaltet die Hardware des Dienstes; Nutzer müssen das Modell dort nicht selbst installieren und warten, sollten aber Verbindung, Nutzungsbedingungen und Umgang mit übertragenen Daten berücksichtigen. Bei lokaler Inferenz übernimmt die Organisation Download, Bereitstellung, Kompatibilität und Wartung. Die Berechnung kann ohne externe Verbindung weiterlaufen, sofern die Anwendung nicht von anderen Diensten abhängt.
| Kriterium | Lokale Inferenz | Cloud- oder API-Inferenz |
|---|---|---|
| Ort der Berechnung | Gerät oder lokale Infrastruktur | Entfernte Server des Anbieters oder Betreibers |
| Verbindung während der Anfrage | Kann ohne Internet funktionieren, wenn Modell und Anwendung lokal verfügbar sind | Die Anfrage benötigt eine Verbindung zum Dienst |
| Eingabedaten | Können in der lokalen Umgebung bleiben; weitere Teile der Anwendung sind ebenfalls zu prüfen | Werden je nach Konfiguration zur Verarbeitung an den Dienst übertragen |
| Ressourcen und Betrieb | Eigene Hardware begrenzt Speicher und Kapazität; Nutzer verwalten Modelle und Aktualisierungen | Der Anbieter stellt Kapazität bereit und verwaltet einen Teil der Infrastruktur |
| Kosten | Hardware, Strom, Speicher und Wartung; also nicht gleichbedeutend mit kostenlos | Je nach Dienst Abrechnung nach Nutzung oder Kapazität möglich |
Die Tabelle fasst Architekturunterschiede zusammen und garantiert weder Datenschutz noch Geschwindigkeit oder Preis eines bestimmten Dienstes. Die Übertragung einer Anfrage an die Cloud legt nicht fest, wie lange sie gespeichert wird oder wer darauf zugreifen kann: Das hängt vom Anbieter, der Konfiguration und dem Vertrag ab.
Bei der Latenz gibt es keinen automatischen Sieger. Lokale Verarbeitung vermeidet den Netzwerkweg zum Server und kann interaktive Anwendungen oder Geräte mit unzuverlässiger Verbindung begünstigen. Eine leistungsstarke entfernte GPU kann jedoch schneller rechnen als ein schwaches lokales Gerät, während ein großes lokales Modell für den vorgesehenen Einsatz zu lange brauchen kann. Kommunikationszeit und Rechenzeit sollten getrennt betrachtet und der gesamte Ablauf bewertet werden.
Bei den Kosten gilt eine ähnliche Logik. Ein Modell auf vorhandener Hardware auszuführen, vermeidet eine Gebühr pro Anfrage, wenn kein kostenpflichtiger Dienst genutzt wird; Anschaffung, Energie, Support, Ersatz und Wartung bleiben jedoch Kostenfaktoren. In der Cloud können die Ausgaben mit der Nutzung steigen; dafür sind Ressourcen verfügbar, die nicht auf jedem Gerät installiert sind. Sinnvoll ist der Vergleich der Gesamtkosten für eine festgelegte Arbeitslast und einen bestimmten Zeitraum – nicht die Gleichsetzung von „lokal“ mit kostenlos oder „Cloud“ mit teurer.
Datenschutz, Sicherheit und praktische Grenzen
Durch lokale Verarbeitung kann es weniger nötig sein, den Inhalt einer Anfrage an einen entfernten Anbieter zu senden. Das verringert einen möglichen Expositionsweg, garantiert aber für sich genommen keinen Datenschutz. Eine Anwendung könnte Protokolle synchronisieren, einen externen Dienst abfragen oder Telemetriedaten senden. Auch Systemberechtigungen, der Zugriff anderer Nutzer und der Schutz des Geräts bleiben relevant.
Lokale Ausführung überträgt Verantwortung auf das Team, das Gerät oder Dienst betreibt. Modell und Software müssen aktuell gehalten, der Zugriff auf den lokalen Dienst kontrolliert und Herkunft sowie Nutzungsbedingungen der Modelle geprüft werden. Auch die Installation auf eigenen Organisationsservern isoliert Daten nicht automatisch: Netzwerk, Zugangsdaten, Protokolle, Sicherungskopien und die Konfiguration jeder Komponente spielen eine Rolle.
Die lokale Hardware setzt der Größe und Komplexität eines Modells, dem verarbeitbaren Kontext und der Zahl gleichzeitiger Anfragen meist praktische Grenzen. Ein kleineres Modell kann für eine klar abgegrenzte Aufgabe gut geeignet sein, muss aber nicht bei allen Aufgaben mit einem leistungsfähigeren entfernten System mithalten. Die Qualität hängt vom Modell und Anwendungsfall ab, nicht allein davon, wo es ausgeführt wird.
Hinzu kommen Betriebskosten, die nicht auf einer Rechnung pro Token erscheinen: die Umgebung vorbereiten, Dateien herunterladen, Kompatibilitätsprobleme lösen, Ressourcen überwachen und Aktualisierungen verteilen. Auf einem einzelnen Gerät kann die Wartung einfach sein; in einem unternehmensweiten Gerätebestand wird sie zur Aufgabe für Bereitstellung und Support. Lokale Inferenz gibt Kontrolle über die Umgebung, bringt aber technische Arbeit mit sich.
Laufzeitumgebungen und Werkzeuge
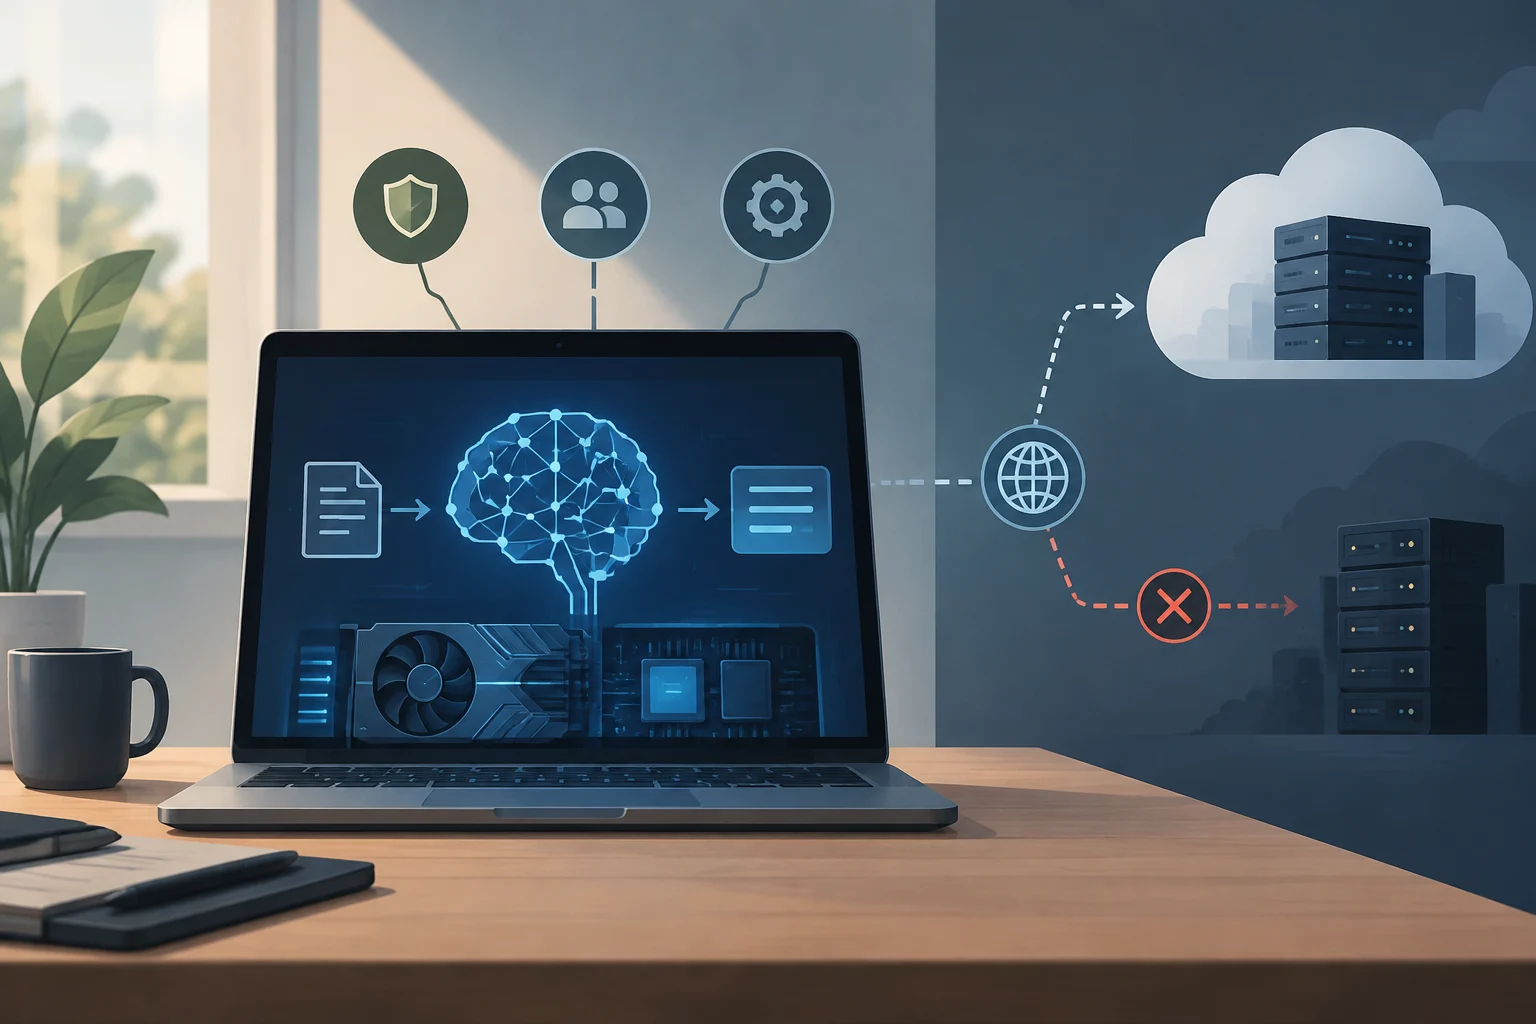
Lokale Werkzeuge übernehmen unterschiedliche Aufgaben. Eine Inferenz-Engine führt Modelloperationen aus; eine Desktop-Anwendung kann Katalog, Chat und Steuerungsmöglichkeiten ergänzen; ein lokaler Server stellt eine Schnittstelle bereit, über die andere Anwendungen Anfragen senden können. Vor der Auswahl sollten diese Funktionen unterschieden und die unterstützten Formate, Beschleuniger und Betriebssysteme geprüft werden.
Microsoft beschreibt Foundry Local als Werkzeug, mit dem kompatible Modelle auf Windows-Geräten unter Nutzung der verfügbaren Hardwarebeschleunigung heruntergeladen und ausgeführt werden können. Für die Integration in Anwendungen stehen Befehlszeilenwerkzeuge und SDKs zur Verfügung. Die Azure-Local-Dokumentation beschreibt im Kontext einer Kubernetes-Bereitstellung die Verwaltung des Modelllebenszyklus und von Endpunkten. Eine universelle Einheitskonfiguration gibt es nicht: Anforderungen und Verwaltung hängen vom Produkt und der Umgebung ab.
Bevor Ollama oder LM Studio in einem Projekt eingesetzt wird, sollte die offizielle Dokumentation des jeweiligen Werkzeugs auf unterstützte Betriebssysteme, Modellformate, Beschleuniger, lokale Schnittstellen und einschlägige Lizenzbedingungen geprüft werden. Die Kompatibilität hängt vom konkreten Werkzeug, Modell und Umfeld ab.
Eine erste Erprobung kann in klaren Schritten erfolgen:
- Aufgabe und Eingabedaten des Modells festlegen.
- Ein Modell auswählen, dessen Lizenz und Fähigkeiten zum Einsatz passen.
- Veröffentlichte Angaben zu Größe, Format und Speicherbedarf prüfen.
- Eine Laufzeitumgebung installieren, die mit System und Hardware kompatibel ist.
- Qualität, Geschwindigkeit, Ressourcenverbrauch und Stabilität mit repräsentativen Eingaben bewerten.
- Festlegen, wie Zugriffspunkt, Protokolle und Aktualisierungen geschützt werden.
Eine generierte Antwort allein belegt nicht, dass eine Bereitstellung geeignet ist: Auch Fehler, Datenschutz und Wartung müssen bewertet werden.
Wann lokale Inferenz und wann ein hybrider Ansatz sinnvoll sind
Lokale Inferenz eignet sich, wenn die Verbindung nicht garantiert ist, Daten nahe ihrem Entstehungsort verarbeitet werden sollen oder die Organisationsrichtlinien bestimmte Inhalte in einer kontrollierten Umgebung halten müssen. Eine Kamera, die eine Anomalie erkennt und nur eine Warnung sendet, ist ein Beispiel für Verarbeitung nahe der Datenquelle. Auch eine Zusammenfassung interner Dokumente kann geeignet sein, sofern Anwendung, Modell und Speicher innerhalb der von der Organisation festgelegten Grenzen bleiben.
Die Cloud kann sinnvoller sein, wenn ein benötigtes Modell oder eine erforderliche Kapazität die Möglichkeiten der eigenen Hardware übersteigt, die Nachfrage schwankt oder dem Team die Zeit für den Betrieb von Modellen fehlt. Bei einer Anwendung auf vielen Geräten kann sie außerdem die zentrale Bereitstellung vereinfachen, bringt aber Abhängigkeit vom Netzwerk, Anbieterbedingungen und die Verwaltung übertragener Daten mit sich.
Ein hybrider Ansatz verteilt Aufgaben nach Verfügbarkeit, Sensibilität oder Komplexität: Zunächst wird ein lokales Modell genutzt, bei Bedarf folgt ein entfernter Dienst. Google dokumentiert für Android Routing-Modi, die das Gerät oder die Cloud bevorzugen oder den Betrieb auf eine der beiden Umgebungen beschränken können. Der Rückfallmechanismus sollte ausdrücklich festgelegt sein: Kann eine sensible Anfrage das Gerät verlassen, sollte die Anwendung den Nutzer informieren und die geltenden Richtlinien einhalten.
Für die Entscheidung helfen folgende Fragen:
- Welche Daten werden eingegeben, und dürfen sie die lokale Umgebung verlassen?
- Welche Qualität und Reaktionszeit verlangt die Aufgabe?
- Passt das Modell mit ausreichendem Spielraum in den verfügbaren Speicher?
- Wer wartet Software, Modelle und Zugriffskontrollen?
- Wie verändern sich die Kosten mit der Nutzung und vorhandener Hardware?
- Was soll geschehen, wenn das lokale Modell nicht verfügbar ist?
Die Antwort kann je nach Aufgabe unterschiedlich ausfallen: Nicht jede Funktion braucht dieselbe Architektur. Ein lokales Modell kann Routineaufgaben oder sensible Verarbeitung übernehmen, während eine entfernte API Anfragen bearbeitet, die seine Kapazität übersteigen – sofern Nutzer und Richtlinien diese Übertragung zulassen.