Die physikalische Grenze der Rechenintensität
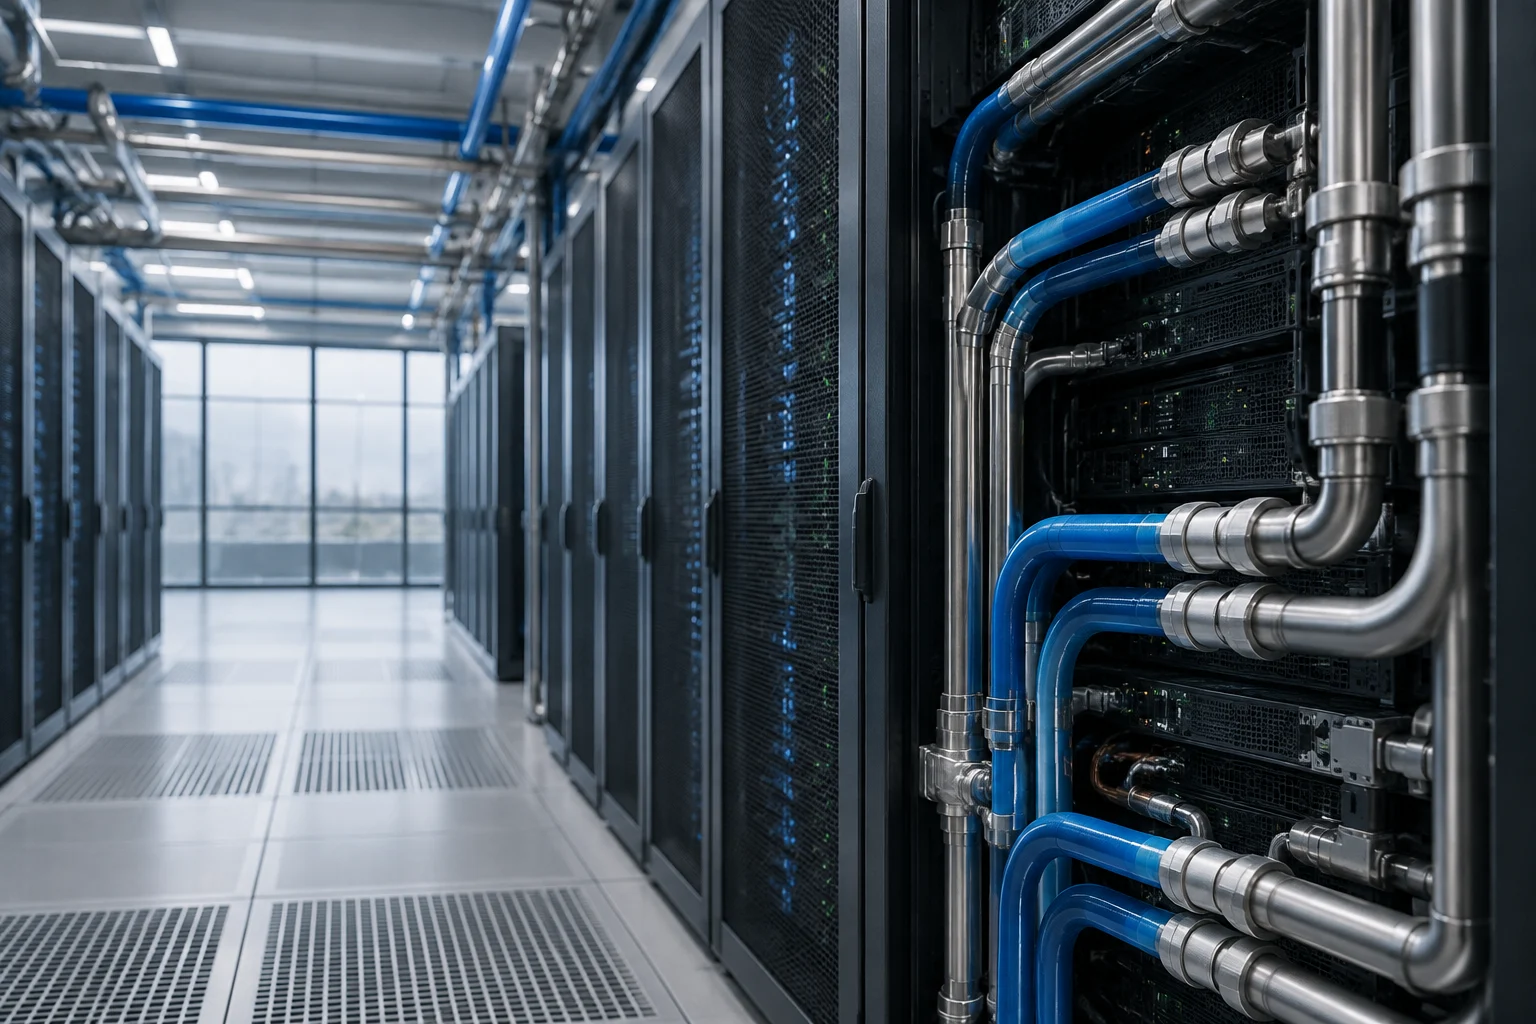
Die Verbreitung von KI-Beschleunigern mit hoher Dichte hat das thermische Engineering von Rechenzentren radikal verändert. Moderne Systeme wie das NVIDIA GB200 NVL72 überschreiten die thermischen Schwellenwerte, die herkömmliche Luftkühlung effizient bewältigen kann, bei Weitem. Diese Realität erzwingt einen strukturellen Übergang zur Verwendung von Fluiden und markiert einen Paradigmenwechsel in der Verwaltung der pro Rack dissipierten Energie.
Laut Aussagen von David Brown, VP für Compute und Machine Learning bei AWS, stellt die Einführung der Blackwell-Plattform den ersten großflächigen Einsatz von Hardware mit Flüssigkühlung in der Infrastruktur des Unternehmens dar. Diese strategische Entscheidung wurde nach der Bewertung getroffen, dass bestehende Lösungen von Drittanbietern entweder den Bau von Rechenzentren von Grund auf erforderten oder nicht angemessen auf die neuen Dichteanforderungen skalierbar waren.
Die Auswirkungen dieser technischen Einschränkung sind in Bezug auf die operative Machbarkeit erheblich. Die früheren Optionen implizierten Implementierungszeiträume von Jahren und eine ineffiziente Nutzung des Bodenraums, einer Ressource, die an bevorzugten Standorten für KI-Infrastrukturen immer knapper und teurer wird. Daher hört die Integration der Flüssigkühlung auf, eine technische Option zu sein, und wird zu einer grundlegenden Voraussetzung für Skalierbarkeit.
Umfang der NVIDIA-Zertifizierung
NVIDIA hat einen strengen technischen Validierungsprozess für seine Infrastrukturpartner etabliert, der darauf ausgelegt ist, die Leistung in den sogenannten AI Factories zu standardisieren. Kürzlich erhielt LG Electronics die offizielle Zertifizierung für seine 600-kW-Kühlmittelverteilungseinheit (CDU) und übertraf mehr als 100 technische Bewertungskriterien. Dieser Prozess ist kein allgemeines Qualitätssiegel, sondern eine tiefgehende Überprüfung, ob die Ausrüstung innerhalb der von GPU-Systemen der neuesten Generation geforderten thermischen und Zuverlässigkeitsparameter betrieben werden kann.
Die Zertifizierung validiert spezifisch das thermische Management, die Zuverlässigkeit und die Fehlertoleranz der Ausrüstung. Für Betreiber bedeutet dies, dass die CDU so konzipiert ist, dass sie intensive KI-Workloads unterstützt, ohne die Leistung der Beschleuniger zu beeinträchtigen oder thermisches Throttling zu verursachen. Es ist jedoch entscheidend zu verstehen, dass sich diese Validierung auf die technische Kompatibilität mit der NVIDIA-Plattform konzentriert und nicht auf die globale wirtschaftliche Optimierung des Rechenzentrums.
Dieser technische Ansatz zielt darauf ab, die Unsicherheit bei der Integration kritischer Hardware zu reduzieren. Indem sichergestellt wird, dass die CDU korrekt mit der NVIDIA-Architektur funktioniert, werden Inkompatibilitätsrisiken minimiert, die den Betrieb von Hochdichte-Clustern lahmlegen könnten. Dennoch umfasst die Zertifizierung keine logistischen oder finanziellen Aspekte, die für die langfristige Rentabilität der Infrastruktur entscheidend sind.
Validierte Metriken gegenüber Einschränkungen
Es ist grundlegend, zwischen dem zu unterscheiden, was die Zertifizierung garantiert, und dem, was außerhalb ihres Umfangs liegt. Im Folgenden werden der technische Umfang der Validierung im Detail dargestellt, wobei die verifizierten Metriken klar von den Variablen getrennt werden, die der Käufer zu tragen hat:
- Thermische Kompatibilität: Überprüfung, ob die CDU die Temperaturen der Komponenten innerhalb der sicheren Grenzen der GPU halten kann, um Überhitzungen zu vermeiden, die die Lebensdauer der Hardware beeinträchtigen.
- Betriebliche Zuverlässigkeit: Belastungstests und Fehlertoleranz, um die Dienstkontinuität unter Bedingungen maximaler und anhaltender Last sicherzustellen.
- Leistungsstandards: Strikte Einhaltung der von der NVIDIA-Architektur erforderlichen Durchflüsse und Drücke, um eine gleichmäßige Dissipation zu gewährleisten.
- Was NICHT validiert wird: Installationskosten, Integration mit bestehenden Kühlsystemen, langfristige Wartung oder die globale Energieeffizienz (PUE) des gesamten Gebäudes.
Vergleich der Kühlungstechnologien
Flüssigkühlung ist keine einzelne Lösung, sondern ein Spektrum von Technologien mit unterschiedlichen Komplexitäts- und Effizienzniveaus. Die Direktkühlung am Chip (wie in zertifizierten CDUs verwendet) bietet die höchste thermische Effizienz, erfordert jedoch eine komplexe Infrastruktur und eine detaillierte Planung der Fluidverteilung. Luftkühlung bleibt für Dichten unter 40 kW pro Rack machbar, während Tauchkühlung und Mikrofluidik zukünftige Stufen höherer Integration darstellen.
Mikrofluidik schlägt beispielsweise vor, das Kühlmittel in den Siliziumchip selbst zu bringen, eine Technologie, die sich noch in der Forschungs- und Entwicklungsphase befindet. Im Gegensatz dazu zielen In-Row-Wärmetauscher-Lösungen (IRHX), wie die von AWS entwickelte, darauf ab, den Raum und die Wassernutzung in bestehenden Anlagen zu optimieren. Die Wahl hängt von der Ziel-Rechenintensität und der Investitionskapazität in die physische Infrastruktur ab.
Jede Technologie bietet ein anderes Gleichgewicht zwischen Anfangskosten, Installationskomplexität und langfristiger Energieeffizienz. Fortgeschrittenere Lösungen ermöglichen höhere Dichten, erfordern jedoch größere Investitionen in Ingenieurwesen und spezialisierte Wartung. Infrastrukturmanager müssen nicht nur die thermische Kapazität, sondern auch die Reife der Technologie und ihre Auswirkungen auf den täglichen Betrieb des Rechenzentrums bewerten.
Auswirkungen auf den Infrastrukturkauf
Für Infrastrukturmanager ist die NVIDIA-Zertifizierung ein Ausgangspunkt, keine endgültige Garantie. Bei der Bewertung einer Lösung ist es erforderlich, die tatsächliche Kompatibilität mit der Datenarchitektur zu überprüfen, einschließlich der Integration mit Stromversorgungssystemen und der Kapazität des Wasserverteilungsnetzes. Ein zertifiziertes Gerät ist möglicherweise nicht die wirtschaftlichste Option, wenn es erhebliche strukturelle Änderungen am Gebäude oder an bestehenden Anlagen erfordert.
Die praktische Entscheidung muss auf einer Total Cost of Ownership (TCO)-Analyse basieren, die nicht nur den Gerätepreis, sondern auch die Installationskosten, den Wasserverbrauch und die Energie zum Pumpen des Kühlmittels umfasst. Die Zertifizierung stellt sicher, dass das Gerät mit NVIDIA-GPUs funktioniert, aber die wirtschaftliche und operative Machbarkeit hängt von der spezifischen Integration in jedem Rechenzentrum ab.
Darüber hinaus ist es wichtig, die Wartungskosten und die langfristige Verfügbarkeit von Ersatzteilen zu berücksichtigen. Die technische Zertifizierung garantiert nicht die Verfügbarkeit lokaler Unterstützung oder die einfache Reparatur im Falle von Ausfällen. Daher muss eine vollständige Bewertung die Überprüfung von Serviceverträgen, die Schulung des technischen Personals und die Planung der technologischen Obsoleszenz umfassen, um die Nachhaltigkeit der Investition sicherzustellen.