Die Herausforderung, Ergebnisse in der Robotik zu vergleichen
In der Robotikforschung kommen unterschiedliche Arme, Kameras, Endeffektoren und Software-Stacks zum Einsatz. Diese Heterogenität erschwert Vergleiche zwischen Laboren: Unterschiede können auf den Algorithmus, aber ebenso auf die Hardware oder das Versuchsprotokoll zurückgehen. Eine Studie zu Puzzle-Benchmarks schlägt ein reproduzierbares physisches Verfahren vor, um räumlich-zeitliches Denken bei der robotischen Manipulation zu untersuchen.
Ein physisches Benchmark mit Puzzles
Das Verfahren nutzt Puzzleteile, um ein an unterschiedliche Aufgaben anpassbares Manipulationsprotokoll zu strukturieren. Es soll Vergleiche auf funktionaler Ebene sowie auf Aufgaben- und Systemebene erleichtern und eine empirische Bezugsgröße für lernbasierte robotische Manipulation schaffen.
Die minimale Roboterzelle DeepClaw
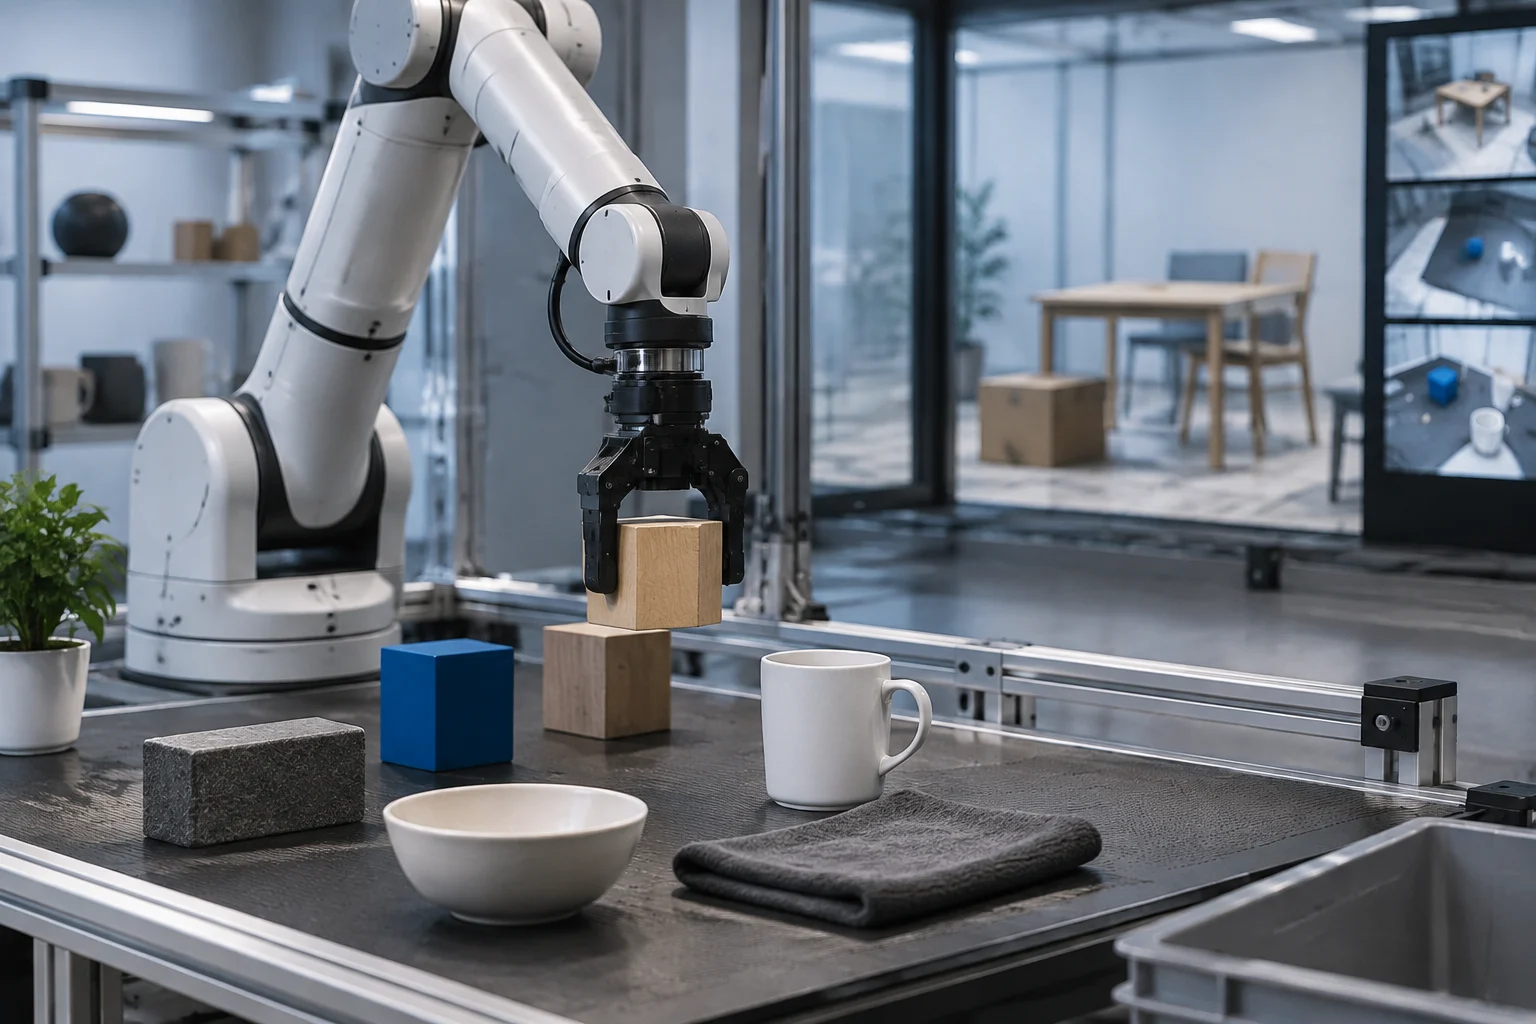
Um die Reproduzierbarkeit zu unterstützen, schlagen die Autoren DeepClaw vor: eine minimale Roboterzelle, die als physisches Gegenstück zu einer standardisierten Softwareumgebung gedacht ist. Sie umfasst fünf Elemente, die für lernbasierte Manipulation benötigt werden:
- Manipulator: ein Roboterarm; UR5, UR10e und Panda dienen als Beispiele.
- Sensor: meist eine Kamera, etwa eine Intel RealSense.
- Endeffektor: In den beschriebenen Experimenten wird ein Sauggreifer verwendet.
- Zielobjekte: die Puzzleteile.
- Arbeitsbereich: der Tisch und die physische Umgebung.
Die Autoren schlagen vor, dass Labore trotz unterschiedlicher Ausrüstung dasselbe Protokoll verwenden. Das ermöglicht Vergleiche zwischen Konfigurationen, bedeutet aber nicht, dass sich Leistungen zwischen allen Plattformen austauschen lassen.
Anpassbare Aufgaben beschreiben
Puzzles wurden gewählt, weil sie leicht zugänglich und variierbar sind. Der sechsdimensionale Code der Studie beschreibt Merkmale jeder Aufgabe:
- Base Frame (BF): ob eine Grundplatte vorhanden ist.
- Piece Placement (PP): ob die Teile flach angeordnet oder verstreut sind.
- Jigsaw Sets (JS): ob ein oder mehrere Puzzlesätze verwendet werden.
- Texture (TX): Standard- oder benutzerdefinierte Texturen.
- Geometry (GO): Standard- oder benutzerdefinierte Formen.
- Material (MA): das physische Material, etwa Holz, Kunststoff oder Metall.
Diese Parameter bilden unterschiedliche Schwierigkeitsgrade ab: von einfachen Pick-and-Place-Abläufen bis zu Montageaufgaben, die präzisere physische Interaktionen erfordern.
Arbeitsschritte und Kennzahlen
Das Protokoll unterteilt die Manipulation in vier funktionale Schritte und ordnet jedem eine Kennzahl zu:
- Segmentierung: Die Pixel identifizieren, die zu jedem Teil gehören. Kennzahl: Intersection over Union (IoU).
- Erkennung: Das betrachtete Teil bestimmen. Kennzahl: Average Precision (AP).
- Greifplanung: Koordinaten für das Greifen oder Ansaugen des Teils bestimmen. Kennzahl: Erfolgsrate.
- Bewegungsplanung: Eine kollisionsfreie Bahn berechnen. Kennzahl: Dauer.
Bei der Aufgabe „Mosaic“ müssen die Teile ohne Grundplatte ineinandergreifen. Die Studie definiert eine zweidimensionale Flächenkennzahl für die Anordnung. Ein Wert näher an 1 steht bei dieser Kennzahl für eine präzisere Montage. Die Messung beschreibt die resultierende Form, nicht sämtliche Aspekte der Manipulationsqualität.
Beschriebene Experimente mit mehreren Robotern
Die Studie berichtet über Experimente mit drei Plattformen: UR5, UR10e und Franka Emika Panda. Für den Vergleich der getesteten Konfigurationen verwendeten die Forschenden Single Shot Detection für die visuelle Erkennung und AlexNet für die Greifplanung.
Vergleich von UR5 und UR10e
Bei UR5 und UR10e wichen funktionale Kennzahlen wie IoU und AP um weniger als fünf Prozent voneinander ab. Auch die Gesamtergebnisse der Aufgaben waren in den beschriebenen Versuchen vergleichbar. Diese Resultate gelten für die untersuchten Konfigurationen und belegen nicht, dass sich die Leistung auf andere Arme oder Aufgaben überträgt.
Kamera und Roboterkonfiguration
Die Panda-Konfiguration verwendete eine RealSense D435i, die UR-Konfigurationen eine D435. Die Studie berichtet für den Panda niedrigere Kennzahlen bei der visuellen Erkennung und bringt das mit neuronalen Netzen in Verbindung, die mit Daten der D435 trainiert wurden. Der Vergleich zeigt, warum Unterschiede bei Sensoren und Trainingsdaten für die Interpretation eines Benchmarks wichtig sind.
Der Panda mit sieben Achsen war beim Vergleich der Bewegungsplanung schneller als die UR-Arme mit sechs Achsen. Dieses Ergebnis stammt aus den getesteten Konfigurationen; für sich genommen bestimmt es nicht, wodurch der Geschwindigkeitsunterschied verursacht wurde.
Montage und Fehlerausgleich
Bei der Aufgabe „Assembly“ müssen Teile mit einer Toleranz von weniger als 0,6 mm auf einer Grundplatte platziert werden. Die Studie berichtet von kumulierten Fehlern im Bereich mehrerer Millimeter, die unter anderem mit Kameratiefe, Sauggreiferausrichtung und Armgenauigkeit zusammenhingen.
Die Forschenden verglichen eine einfache Montage, bei der Teile direkt aufgenommen und abgelegt werden, mit einer Montage durch Manipulation, die einen programmierten Feinschritt ergänzt: Das Teil wird in die richtige Position geschoben. In den beschriebenen Versuchen scheiterte die einfache Methode häufig, während der manipulative Ansatz die Erfolgsrate verbesserte. Die Interaktionsstrategie glich in dieser Konfiguration einen Teil der Ungenauigkeiten aus; daraus folgt nicht, dass sie Hardwarefehler allgemein beseitigt.
Simulation mit SimplerEnv
SimplerEnv (SIMPLER) ist ein Open-Source-Framework, das für die reale Welt entwickelte Manipulationsrichtlinien in einer Simulation bewertet. Ziel ist es, Richtlinien wie RT-1, RT-1-X und Octo skalierbar zu prüfen, ohne für jede Bewertung einen physischen Versuch durchzuführen.
SimplerEnv basiert auf SAPIEN und ManiSkill2 und bietet simulierte Umgebungen für die Konfigurationen Google Robot und WidowX. Das Framework beschreibt zwei Bewertungsmethoden:
- Visual Matching: Reale Bilder werden als Hintergründe in die Simulation eingebunden; Texturen werden angepasst, um visuelle Unterschiede zu verringern.
- Variant Aggregation: Richtlinien werden in mehreren Umgebungsvarianten geprüft, unter anderem mit unterschiedlichen Hintergründen, Beleuchtungen und Ablenkungsobjekten.
Das Projekt berichtet von einer Validierung mit etwa 1.500 Evaluierungsepisoden und einer starken Korrelation zwischen simulierten Ergebnissen und der Leistung der Richtlinien in der realen Welt. SimplerEnv wurde von Forschenden der UC San Diego, Stanford, UC Berkeley und Google DeepMind entwickelt. Es umfasst eine Gym-API, Code zur Inferenz von Richtlinien und Evaluierungsskripte. Eine GPU-beschleunigte Version mit ManiSkill3 wird als zehn- bis fünfzehnmal schneller beschrieben.
Was die beiden Ansätze messen
Das Puzzle-Protokoll bewertet Manipulation anhand physischer Aufgaben und funktionaler sowie aufgabenbezogener Kennzahlen. SimplerEnv prüft Richtlinien in einer Simulation und berichtet über den beobachteten Zusammenhang zwischen Simulationsergebnissen und realer Leistung. Die Ansätze beantworten unterschiedliche Fragen: Ihre Ergebnisse hängen von den untersuchten Protokollen, Plattformen und Versuchen ab und garantieren allein keine Übertragbarkeit auf andere Roboter, Umgebungen oder Aufgaben.