O desafio de comparar resultados em robótica
Pesquisas em robótica usam diferentes braços, câmeras, efetores e pilhas de software. Essa heterogeneidade dificulta comparações entre laboratórios: uma diferença de resultado pode decorrer do algoritmo, mas também do hardware ou do protocolo experimental. Um estudo sobre benchmarks com quebra-cabeças propõe um protocolo físico reproduzível para examinar o raciocínio espaço-temporal na manipulação robótica.
Um benchmark físico com quebra-cabeças
O método usa peças de quebra-cabeça para estruturar um protocolo de manipulação adaptável a diferentes especificações de tarefa. A proposta busca facilitar comparações nos níveis funcional, da tarefa e do sistema, oferecendo uma referência empírica para a manipulação robótica baseada em aprendizagem.
A célula mínima DeepClaw
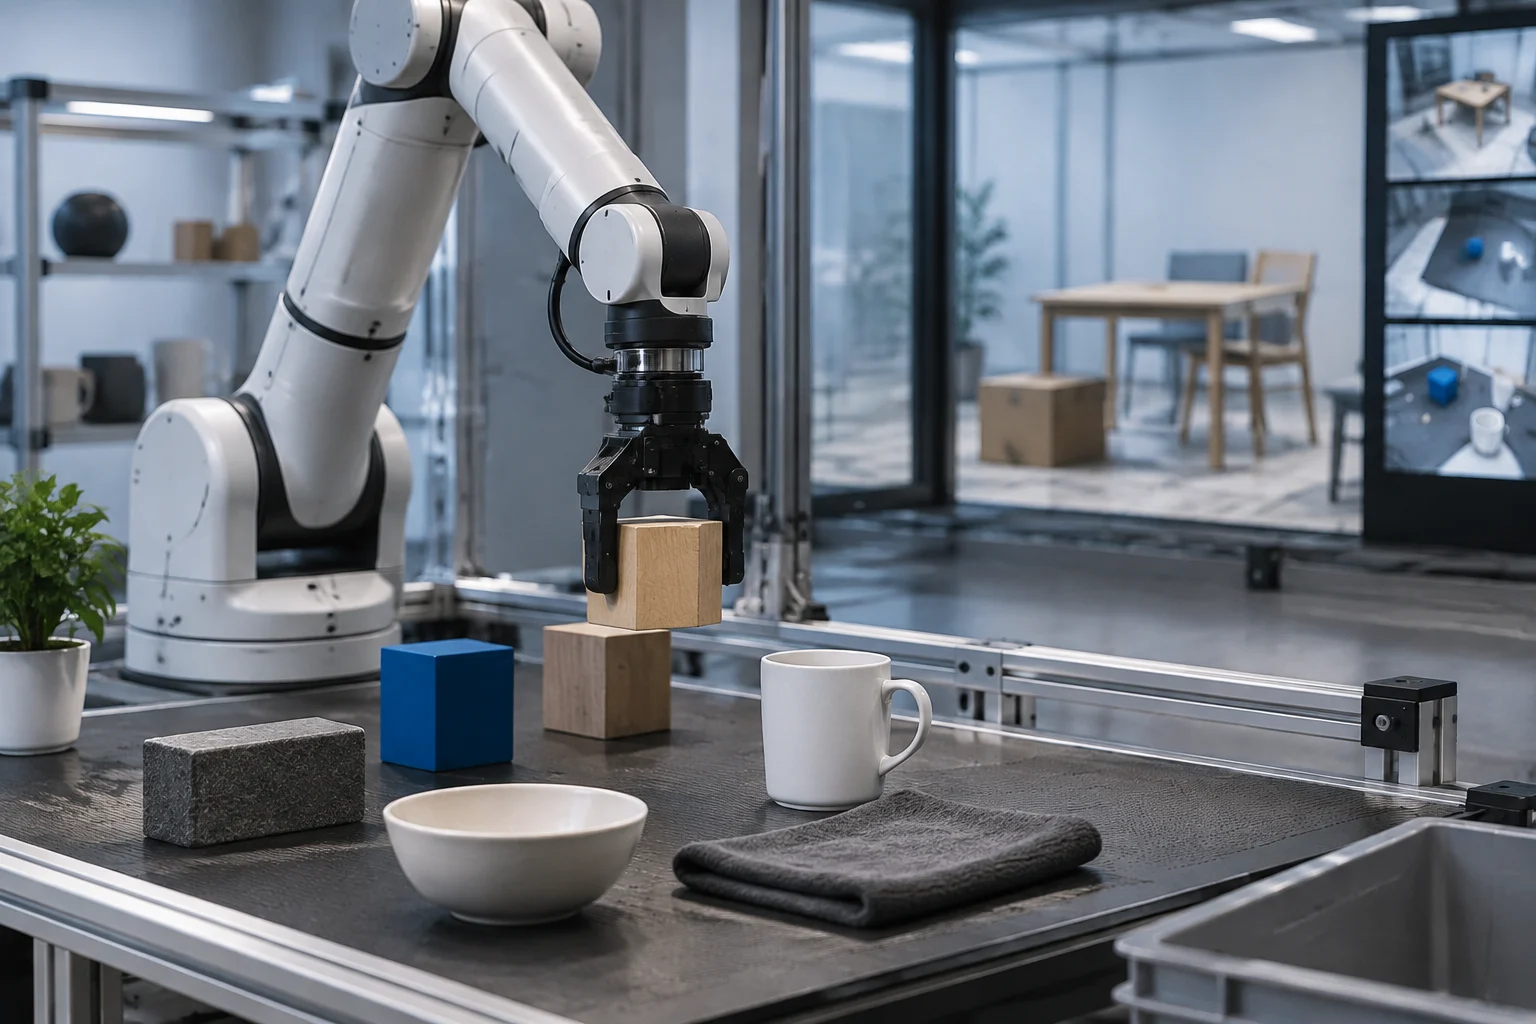
Para favorecer a reprodutibilidade, o estudo propõe a DeepClaw, uma célula robótica mínima concebida como equivalente físico de um ambiente de software padronizado. Ela distingue cinco elementos necessários à manipulação baseada em aprendizagem:
- Manipulador: um braço robótico; UR5, UR10e e Panda são exemplos.
- Sensor: geralmente uma câmera, como uma Intel RealSense.
- Efetor: os experimentos descritos usam uma ventosa.
- Objetos-alvo: as peças do quebra-cabeça.
- Espaço de trabalho: a mesa e o ambiente físico ao redor.
Os autores propõem que laboratórios sigam o mesmo protocolo mesmo usando equipamentos diferentes. Isso permite comparar configurações, mas não significa que o desempenho seja intercambiável entre todas as plataformas.
Descrever tarefas personalizáveis
Os quebra-cabeças foram escolhidos por serem acessíveis e fáceis de variar. O código de seis dimensões do estudo descreve características de cada tarefa:
- Base Frame (BF): presença ou ausência de uma base.
- Piece Placement (PP): peças dispostas na horizontal ou espalhadas.
- Jigsaw Sets (JS): um conjunto ou vários conjuntos.
- Texture (TX): padrões padrão ou personalizados.
- Geometry (GO): formas padrão ou personalizadas.
- Material (MA): material físico, como madeira, plástico ou metal.
Esses parâmetros representam diferentes graus de dificuldade, de uma tarefa simples de pick-and-place a uma montagem que exige interações físicas mais precisas.
Etapas e métricas
O protocolo divide a manipulação em quatro etapas funcionais, cada uma associada a uma medida:
- Segmentação: localizar os pixels pertencentes a cada peça. Métrica: interseção sobre união (Intersection over Union, IoU).
- Reconhecimento: identificar a peça observada. Métrica: precisão média (Average Precision, AP).
- Planejamento da preensão: escolher as coordenadas para agarrar ou aspirar a peça. Métrica: taxa de sucesso.
- Planejamento do movimento: calcular uma trajetória sem colisões. Métrica: duração.
Na tarefa Mosaic, as peças devem se encaixar sem uma base. O estudo define uma razão de área bidimensional para avaliar a disposição final; segundo essa medida, um valor mais próximo de 1 corresponde a uma montagem mais precisa. A medida descreve a forma resultante, não todas as dimensões da qualidade da manipulação.
Experimentos descritos com vários robôs
O estudo apresenta experimentos em três plataformas: UR5, UR10e e Franka Emika Panda. Para comparar as configurações testadas, os pesquisadores usaram Single Shot Detection para visão e AlexNet para planejamento da preensão.
Comparação entre UR5 e UR10e
Para UR5 e UR10e, as métricas funcionais — incluindo IoU e AP — diferiram em menos de 5%. Os resultados gerais das tarefas também foram comparáveis nos ensaios descritos. Esses resultados se referem às configurações estudadas e não demonstram que o desempenho se transfira para outros braços ou tarefas.
A câmera e a configuração do robô
A configuração do Panda usava uma RealSense D435i, enquanto as configurações UR usavam uma D435. O estudo relata métricas de visão inferiores para o Panda e relaciona o resultado a redes treinadas com dados da D435. A comparação mostra por que diferenças de sensor e de dados de treinamento importam na interpretação de um benchmark.
O Panda, um robô de sete eixos, foi mais rápido que os braços UR de seis eixos na comparação de planejamento de movimento apresentada no estudo. Esse resultado foi obtido nas configurações testadas; isoladamente, não permite determinar a causa da diferença de velocidade.
Montagem e compensação de erros
Na tarefa Assembly, as peças precisam ser colocadas sobre uma base com tolerância inferior a 0,6 mm. O estudo relata erros acumulados de vários milímetros, relacionados, entre outros fatores, à profundidade da câmera, ao alinhamento da ventosa e à precisão do braço.
Os pesquisadores compararam a montagem simples — agarrar e depositar as peças diretamente — com a montagem por manipulação, que acrescenta uma etapa programada de ajuste fino para empurrar a peça até a posição correta. Nos ensaios descritos, o método simples falhava com frequência, enquanto a abordagem por manipulação melhorava a taxa de sucesso. A estratégia de interação compensou parte das imprecisões nessa configuração; isso não significa que ela elimine erros de hardware em geral.
Etapas funcionais e métricas do protocolo de benchmarking
A tabela lista as quatro etapas do protocolo de manipulação robótica e a métrica funcional associada a cada uma, conforme descrito no estudo.
| Segmentação | Intersection over Union (IoU) |
|---|---|
| Reconhecimento | Average Precision (AP) |
| Planejamento da preensão | Taxa de sucesso |
| Planejamento do movimento | Duração |
As métricas são específicas para o protocolo descrito no estudo e podem variar em outras configurações.
Fontes e referências1
Avaliação em simulação com SimplerEnv
O protocolo com quebra-cabeças exige hardware robótico para cada avaliação. SimplerEnv (SIMPLER) é um framework de código aberto que avalia em simulação políticas de manipulação destinadas ao mundo real. Seu objetivo declarado é permitir a avaliação em escala de políticas como RT-1, RT-1-X e Octo sem realizar um teste físico a cada avaliação.
Construído sobre SAPIEN e ManiSkill2, o SimplerEnv oferece ambientes simulados para as configurações Google Robot e WidowX. O framework apresenta dois métodos de avaliação:
- Visual Matching: usa imagens reais como fundos na simulação e ajusta as texturas para reduzir diferenças visuais.
- Variant Aggregation: avalia políticas em várias versões do ambiente, variando o fundo, a iluminação e os elementos que causam distração.
O projeto relata validação em cerca de 1.500 episódios de avaliação e forte correlação entre o desempenho simulado e o desempenho real das políticas. O SimplerEnv foi desenvolvido por pesquisadores da UC San Diego, Stanford, UC Berkeley e Google DeepMind. Inclui uma API Gym, código de inferência de políticas e scripts de avaliação. Uma versão acelerada por GPU que usa ManiSkill3 é descrita como 10 a 15 vezes mais rápida.
O que as duas abordagens medem
O protocolo com quebra-cabeças avalia a manipulação por meio de tarefas físicas e métricas funcionais e ligadas às tarefas. O SimplerEnv avalia políticas em simulação e relata a relação observada entre os resultados simulados e o desempenho real. As abordagens respondem a perguntas diferentes: seus resultados dependem dos protocolos, das plataformas e dos ensaios estudados, e não garantem, por si só, generalização para outros robôs, ambientes ou tarefas.