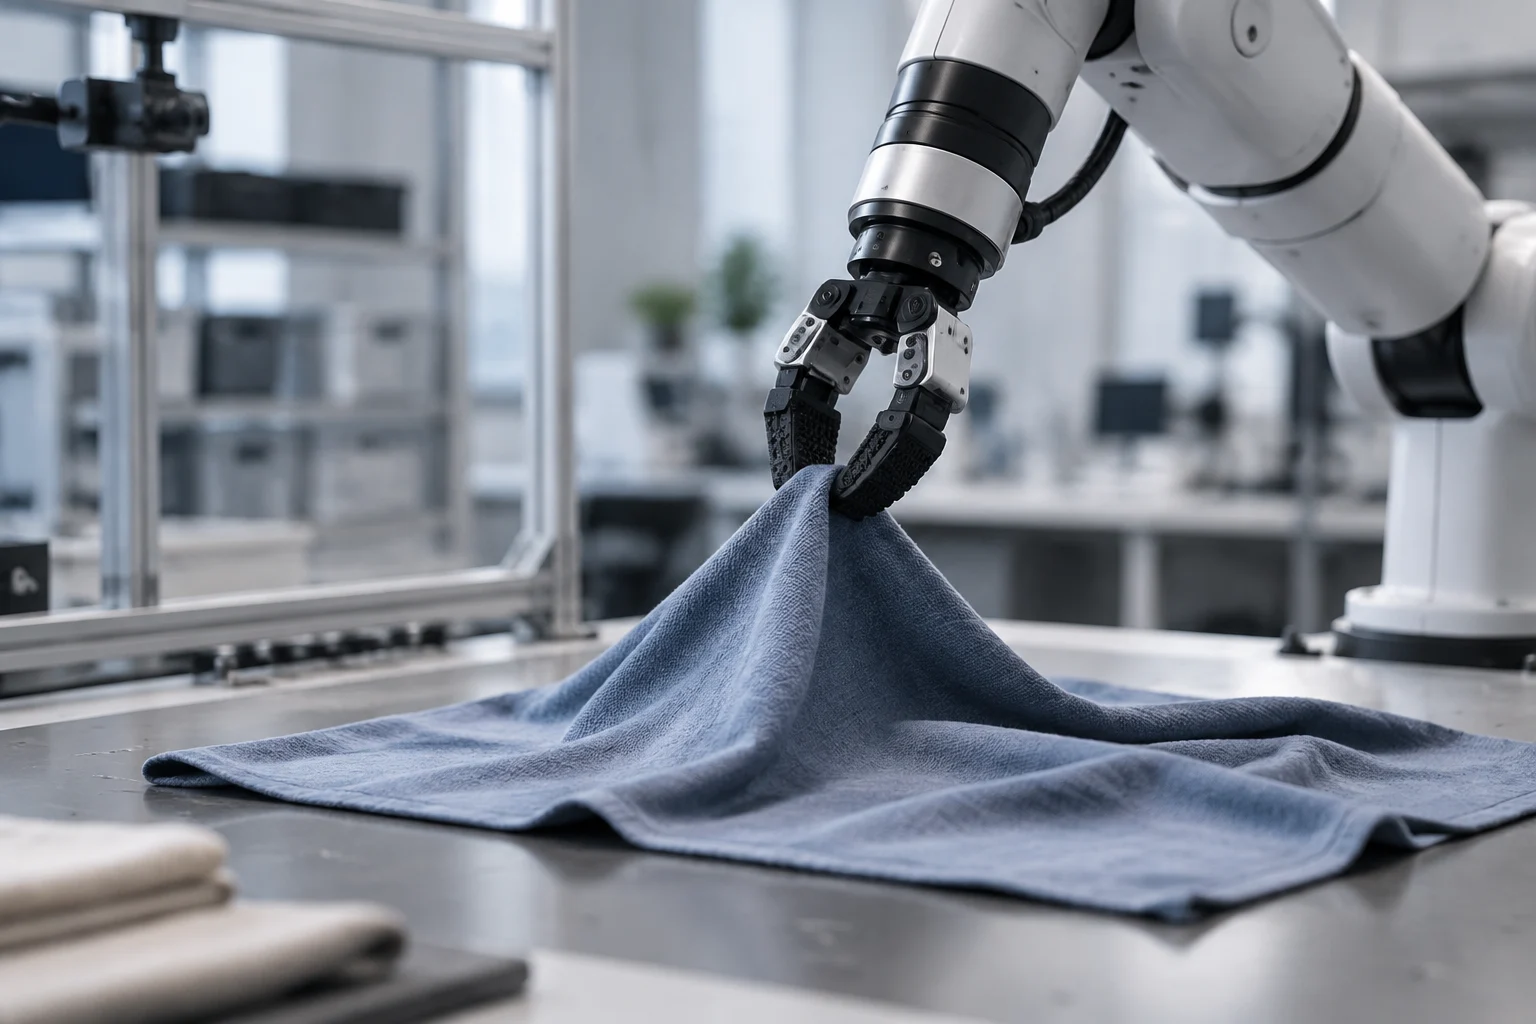
L’écart entre comprendre une consigne et déplacer un objet
Un robot peut recevoir une consigne compréhensible — par exemple, placer une pièce dans un bac — et pourtant échouer à effectuer les mouvements nécessaires. Il doit interpréter ce que montre une caméra, estimer la position des objets, anticiper leurs interactions et choisir une action suffisamment précise. La différence entre décider quelle tâche effectuer et raisonner sur la manière d’exécuter un mouvement concret est le problème abordé par ManipBench. L’étude a été publiée dans les actes de la Conference on Robot Learning de 2025 et évalue le raisonnement de modèles de vision-langage pour la manipulation robotique de bas niveau. (PMLR)
Cette distinction est importante, car une réponse verbale convaincante ne prouve pas qu’un modèle maîtrise le contrôle d’un bras robotique. ManipBench propose une évaluation commune de capacités de raisonnement liées à la manipulation, notamment la compréhension des interactions entre objets et la manipulation d’objets déformables. Il s’agit d’examiner des compétences utiles au contrôle, et non de démontrer entièrement qu’un modèle peut recevoir une consigne ouverte, planifier une longue séquence et l’exécuter physiquement sans aide. Le benchmark mesure le raisonnement lié aux mouvements ; il ne constitue pas, à lui seul, une certification d’autonomie.
Il convient également de distinguer la compréhension d’une tâche de son exécution dans la durée. Dans une évaluation du raisonnement, un modèle peut montrer qu’il sait identifier l’objet à déplacer ou l’action qui serait appropriée. Dans le monde physique, il doit aussi convertir cette réponse en instructions que le robot peut exécuter. Cette transition impose d’autres exigences, comme maintenir la précision au fil de plusieurs étapes et réagir aux changements de la scène. ManipBench permet d’examiner une partie de cette chaîne, mais ne remplace pas l’évaluation de toutes ses étapes.
Contenu de l’évaluation
ManipBench évalue plusieurs dimensions du raisonnement en manipulation, dont les interactions entre objets et la manipulation d’objets déformables. L’article présente le benchmark comme un moyen d’étudier le raisonnement de bas niveau associé à des mouvements précis. (PMLR)
Cette diversité permet d’examiner plusieurs capacités, mais ne revient pas à reproduire toutes les conditions d’un espace physique réel. L’étude se concentre sur le raisonnement de bas niveau défini par ses auteurs et ne démontre pas, à elle seule, comment un système réagirait à n’importe quelle variation de l’environnement. Une évaluation par benchmark ne vaut pas des milliers d’essais indépendants avec des robots.
La structure commune permet de comparer des modèles dans le périmètre défini par l’étude. En même temps, les résultats doivent être interprétés en tenant compte des questions et des tâches retenues par les chercheurs. L’existence d’un score comparable ne signifie pas que toutes les variations d’objets, de scènes ou de conditions d’exécution susceptibles de survenir hors de l’évaluation sont représentées.
Ce que montrent les résultats publiés
Le résumé des auteurs souligne que les performances des modèles de vision-langage varient considérablement selon les tâches. Il fait également état d’une forte corrélation entre les performances sur ManipBench et les tendances observées dans des tâches de manipulation réelles, et indique qu’un écart important par rapport à la compréhension humaine subsiste. Ces résultats sont rapportés par l’étude elle-même et décrivent ses expériences ; ils ne constituent pas une mesure universelle de tous les robots ou modèles existants. (arXiv)
Cette corrélation mérite attention, car elle suggère que certains tests de raisonnement liés à la manipulation peuvent fournir des indications pertinentes sur les performances physiques. Mais une corrélation ne démontre pas que le score au benchmark entraîne un meilleur contrôle ni qu’il permet de prédire précisément le résultat d’un nouveau déploiement. Elle ne transforme pas non plus automatiquement une réponse correcte en action correctement exécutée. La conclusion utile est limitée : le benchmark fournit des indications, pas une garantie opérationnelle.
Les différences entre tâches invitent à ne pas résumer les performances par une seule impression générale. Un modèle peut obtenir des résultats différents selon le type de raisonnement évalué ; un chiffre global risque donc de masquer des écarts importants. Pour interpréter les capacités et les limites, il est utile de conserver le lien entre chaque résultat et la tâche qui l’a produit, sans extrapoler au-delà des conditions expérimentales.
Ce que ManipBench ne démontre pas
La principale limite tient à l’écart entre raisonner sur une scène et contrôler un système physique dans la durée. Une évaluation par benchmark ne reproduit pas, à elle seule, les erreurs de perception, les glissements, les changements d’éclairage, les occultations, la latence, le calibrage ou l’usure de l’équipement. Dans un robot réel, un petit écart peut modifier le contact avec un objet et changer le résultat d’une séquence. Par conséquent, un bon résultat dans une évaluation délimitée ne permet pas de conclure que le système accomplira du début à la fin des tâches domestiques ou industrielles, en toute sécurité et de manière fiable.
Il ne faut pas non plus confondre la corrélation décrite par les auteurs avec une généralisation garantie à d’autres robots, caméras, outils ou environnements. La portée de toute conclusion dépend des tâches et des conditions évaluées. Cette limite méthodologique ne remet pas en cause l’étude : elle indique que l’évaluation doit être complétée par des essais physiques répétables, menés dans des conditions transparentes.
La fiabilité physique dépend aussi de la capacité du système à maintenir le résultat lorsque les conditions d’exécution changent. Une réponse au sujet d’une scène ne révèle pas, à elle seule, comment le robot réagira si un objet se déplace, devient invisible ou ne produit pas le contact attendu. Ces situations exigent d’observer et de corriger l’action pendant son déroulement, ce qui diffère de la démonstration d’un raisonnement dans une évaluation délimitée.
Comment interpréter une démonstration de robot doté d’IA
Face à une démonstration de manipulation, la question pratique n’est pas seulement de savoir si le robot a réalisé quelque chose d’impressionnant, mais quelle tâche exacte il a effectuée et combien de fois. Il convient de distinguer une action isolée d’une longue séquence, de vérifier si le résultat dépend d’une scène préparée et de savoir si une personne est intervenue pour corriger des erreurs. Une vidéo convaincante peut montrer une capacité réelle, mais ne révèle pas, à elle seule, le taux de réussite, les tentatives infructueuses ni l’ampleur des variations de performance lorsque la position des objets change.
Il importe également de distinguer les étapes du système. Un modèle peut interpréter la consigne, un autre module planifier et un contrôleur exécuter les mouvements ; attribuer l’ensemble du résultat à un seul modèle simplifie excessivement l’architecture. Pour comparer les évaluations, il est utile de connaître le matériel, l’environnement, les tâches, le nombre d’essais, les critères de réussite et les interventions humaines. ManipBench fournit un cadre de discussion du raisonnement en manipulation, mais ne remplace pas ces questions sur l’exécution physique.
Répéter une démonstration est important, car une seule exécution réussie ne permet pas de savoir si le résultat est habituel ou exceptionnel. Indiquer le nombre d’essais réalisés et la définition de la réussite aide à replacer ce qui a été observé dans son contexte. Cela permet aussi de distinguer les cas où le robot accomplit la tâche sans aide de ceux où une personne intervient ou prépare soigneusement les conditions.
Un outil de mesure, pas une promesse de déploiement
ManipBench permet de mettre en évidence que la compétence d’un modèle n’est pas uniforme : elle dépend de la tâche et du raisonnement demandé. Ses auteurs signalent des différences entre les tâches et un lien entre les résultats du benchmark et les tendances observées en manipulation réelle. Ces observations peuvent orienter des évaluations ultérieures, à condition de rester rattachées au périmètre de l’étude. (arXiv)
L’interprétation la plus rigoureuse évite les deux extrêmes. Il serait erroné de considérer le benchmark comme la preuve que les modèles savent déjà manipuler des objets de manière générale, tout comme de le rejeter parce qu’il ne couvre pas l’ensemble du monde physique. Il s’agit d’une évaluation délimitée, qui organise des questions importantes et met en évidence des différences entre tâches ; ses conclusions doivent conserver cette portée. Pour apprécier les progrès futurs, il est utile de combiner des évaluations structurées et des essais sur matériel, répétés dans des conditions variées et clairement documentés. D’ici là, c’est un outil pour mesurer et formuler de meilleures questions, pas une garantie de performances au quotidien.
Le benchmark peut aider à déterminer les recherches à mener ensuite : quels types de raisonnement restent difficiles et quels résultats gagneraient à être vérifiés sur du matériel robotique. Cette fonction diffère de la certification d’un produit ou de la prédiction de son comportement dans n’importe quel environnement. Une évaluation délimitée est utile lorsque ses conditions restent visibles et qu’un indice de capacité n’est pas confondu avec une promesse de déploiement.