Kanонische Definition: Was ein KI-System ausmacht
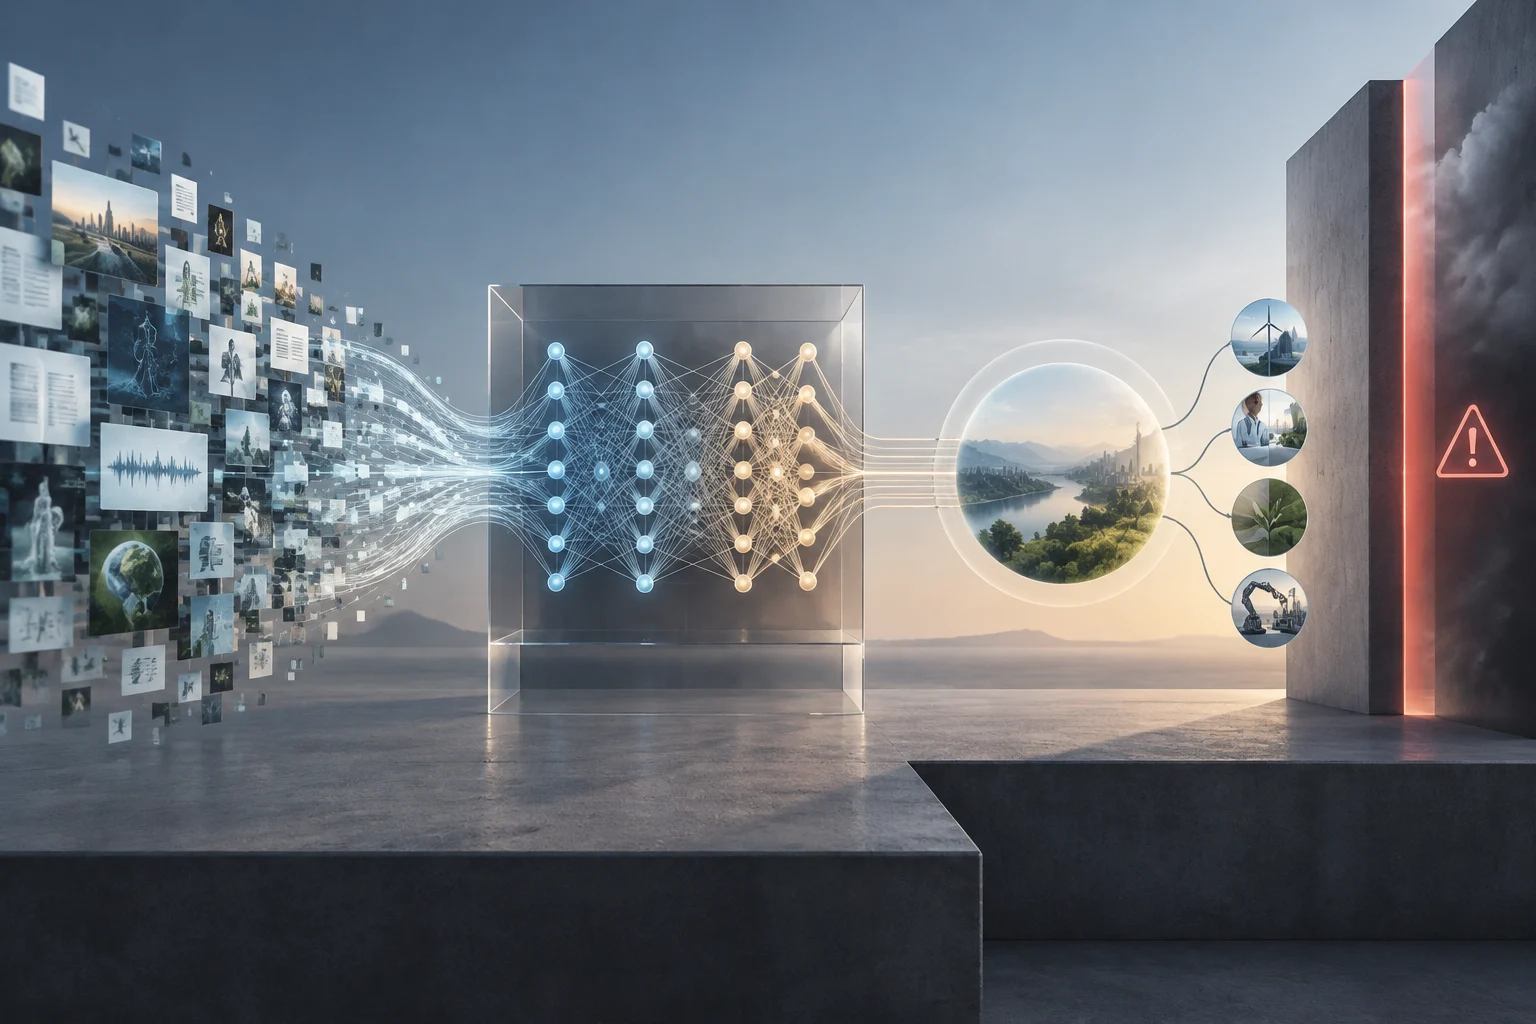
Künstliche Intelligenz wird als das Feld der Informatik definiert, das sich mit der Erstellung von Systemen befasst, die in der Lage sind, Aufgaben auszuführen, die traditionell menschliche Intelligenz erfordern, wie Wahrnehmung, Schlussfolgerung, Lernen und das Verständnis natürlicher Sprache. Diese Definition, die von Organisationen wie der Europäischen Union und Technologieunternehmen unterstützt wird, stellt fest, dass es sich nicht um eine einzelne Technologie handelt, sondern um eine Reihe von Methoden, die es Maschinen ermöglichen, Informationen zu verarbeiten und Entscheidungen zu treffen.
Die Europäische KI-Verordnung (AI Act), die im Februar 2025 in Kraft getreten ist, bietet einen rechtlichen Rahmen zur Klassifizierung dieser Systeme nach ihrem Risikograd. Die Rechtsvorschrift unterscheidet zwischen Systemen mit allgemeinem und spezifischem Zweck und legt Pflichten für Anbieter und Nutzer fest. Diese Regulierung soll sicherstellen, dass die Entwicklung der KI transparent, sicher und respektvoll gegenüber den Grundrechten ist und einen globalen Standard für die Industrie setzt.
Unterschied zur traditionellen Programmierung
Im Gegensatz zu einem traditionellen Programm, bei dem jede Regel von einem Entwickler explizit vorprogrammiert wird, lernt ein KI-System Muster aus Daten. In der klassischen Programmierung muss der Code manuell geändert werden, wenn sich das Kriterium ändert. In der KI passt das System seine internen Parameter an, wenn es neuen Beispielen ausgesetzt wird, was es ihm ermöglicht, sich an Situationen anzupassen, die in seinem ursprünglichen Design nicht vorgesehen waren.
Funktionsmechanismen: Von der Daten zur Entscheidung
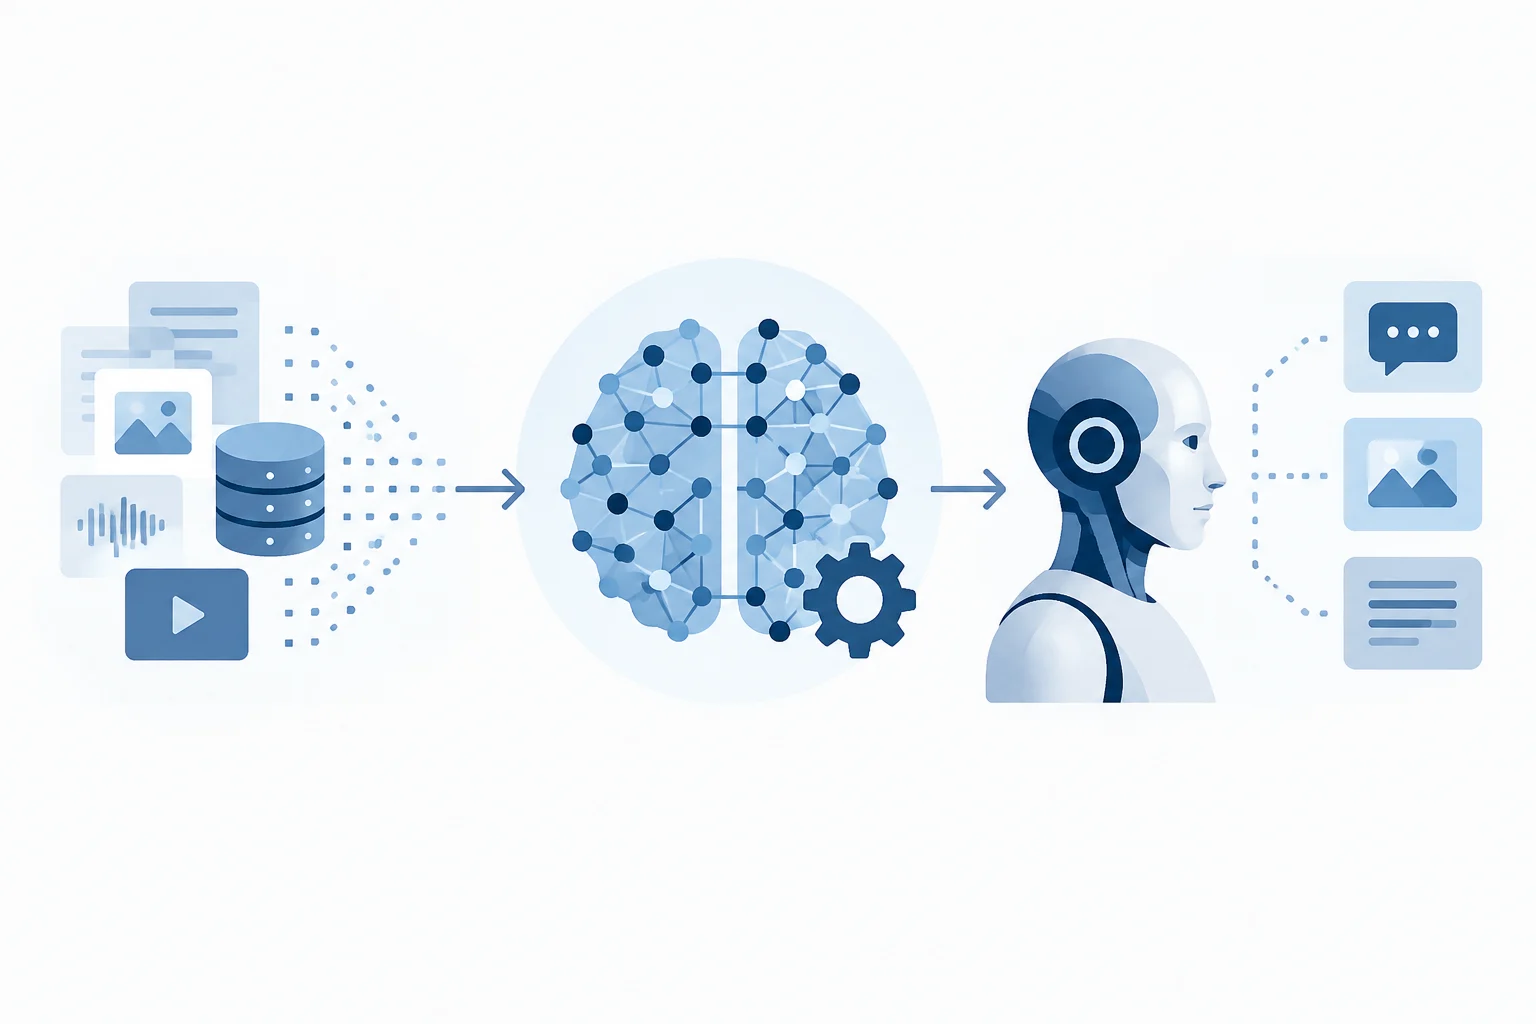
Die Funktionsweise eines KI-Systems basiert auf dem maschinellen Lernen (Machine Learning), einem Teilbereich der KI, in dem Systeme Muster in großen Datenmengen identifizieren, ohne für jeden Fall explizit programmiert zu werden. Der Prozess beginnt mit der Datenerfassung, die zur Schulung eines mathematischen Modells verwendet wird. Dieses Modell passt seine internen Parameter an, bis seine Vorhersagen mit den erwarteten Ergebnissen im Trainingsdatensatz übereinstimmen.
Nach der Schulung tritt das Modell in die Phase der Inferenz ein, in der das System die erlernten Muster auf neue Daten anwendet, um eine Antwort oder Entscheidung zu generieren. Ein mit Tierbildern trainiertes Modell kann beispielsweise in Echtzeit eine Hunderasse identifizieren, auch wenn es dieses bestimmte Bild noch nie zuvor gesehen hat. Die Qualität der Inferenz hängt direkt von der Menge und Relevanz der für das Training verwendeten Daten ab.
Der Lebenszyklus des Modells
Die Entwicklung eines KI-Systems folgt einem iterativen Zyklus, der Datenerfassung, Training, Validierung, Deployment und Feedback umfasst. Die Validierung ist entscheidend, um die Genauigkeit des Modells auf Daten zu messen, die es während des Trainings nicht gesehen hat, und Overfitting zu vermeiden. Das Feedback ermöglicht es, das Modell mit neuen Daten zu aktualisieren und seine Leistung im Laufe der Zeit zu verbessern.
Typen des maschinellen Lernens
Innerhalb des maschinellen Lernens gibt es drei Hauptansätze, die sich dadurch unterscheiden, wie die Daten strukturiert sind und wie das Modell seine Anweisungen erhält. Die Wahl der Methode hängt von der Natur des Problems und der Verfügbarkeit von gelabelten Daten ab. Jeder Ansatz hat spezifische Anwendungen und unterschiedliche Anforderungen an die Qualität und das Volumen der Eingabedaten.
Die folgende Tabelle vergleicht die drei Haupttypen des maschinellen Lernens und hebt ihre Merkmale, Anwendungsbeispiele und Datenanforderungen hervor:
| Lerntyp | Beschreibung | Anwendungsbeispiel | Datenanforderungen |
|---|---|---|---|
| Überwacht | Das Modell lernt aus Daten, die mit der richtigen Antwort gelabelt sind. | Spam-Erkennung in E-Mails. | Gelabelte Daten (Eingabe und erwartete Ausgabe). |
| Unüberwacht | Das Modell identifiziert Muster oder Gruppierungen in ungelabelten Daten. | Kundensegmentierung im Marketing. | Ungelabelte Daten, große Volumina. |
| Per Verstärkung | Das Modell lernt durch Trial-and-Error und erhält Belohnungen oder Strafen. | Navigationsroboter oder Schachspiele. | Simulierte oder reale Umgebung mit kontinuierlichem Feedback. |
Überwachtes Lernen ist in kommerziellen Anwendungen am häufigsten, da es eine objektive Bewertung der Modellgenauigkeit ermöglicht. Unüberwachtes Lernen ist nützlich, wenn die Struktur der Daten unbekannt ist oder verborgene Beziehungen entdeckt werden sollen. Lernen per Verstärkung wird in dynamischen Umgebungen eingesetzt, in denen die Aktion des Agenten unmittelbare, messbare Konsequenzen hat.
Schwache KI, starke KI und generative KI
Das Feld der KI wird traditionell in zwei Zweige unterteilt: schwache künstliche Intelligenz (oder enge) und starke künstliche Intelligenz (oder allgemeine). Schwache KI ist für die Ausführung spezifischer Aufgaben konzipiert, wie die Spracherkennung in einem virtuellen Assistenten oder die Produktempfehlung auf einer E-Commerce-Plattform. Die meisten aktuellen Anwendungen gehören zu dieser Kategorie, da sie leichter zu entwickeln und zu bewerten sind.
Starke KI (AGI, englische Abkürzung) strebt an, die menschliche Intelligenz in ihrer Gesamtheit nachzuahmen und der Maschine zu ermöglichen, ähnlich wie ein Mensch zu schlussfolgern, sich anzupassen und zu lernen. Diese Art von KI befindet sich noch in der Forschungsphase und wurde von keinem kommerziellen System erreicht. Die Unterscheidung ist wichtig, um unrealistische Erwartungen an die aktuellen Fähigkeiten der Technologie zu vermeiden.
Generative KI vs. analytische KI
In den letzten Jahren hat die generative KI an Bedeutung gewonnen, ein Teilbereich der KI, der neuen Inhalt (Text, Bilder, Code) aus erlernten Mustern erstellt. Im Gegensatz zur analytischen KI, die klassifiziert oder vorhersagt, erzeugt die generative KI kreative Ausgaben. Modelle wie GPT-4 von OpenAI sind Beispiele für generative KI, die zum Verfassen von Texten, Generieren von Code oder Erstellen von Bildern verwendet werden. Diese Fähigkeit hat die Reichweite der KI in kreativen Sektoren und der Softwareentwicklung erweitert.
Praktische Anwendungen und erklärte Beispiele
Künstliche Intelligenz wird in verschiedenen Sektoren angewendet, von der Gesundheit bis zur Industrie. Im medizinischen Bereich helfen KI-Systeme bei der Bildgebungsdagnostik, indem sie Röntgenaufnahmen oder MRTs analysieren, um Anomalien zu erkennen, die dem menschlichen Auge entgehen könnten. Diese Systeme ersetzen den Arzt nicht, sondern dienen als Unterstützungswerkzeug, das den Prozess beschleunigt und die Arbeitslast reduziert.
Im Finanzsektor wird KI zur Betrugserkennung verwendet, um Transaktionen in Echtzeit zu analysieren und verdächtige Muster zu identifizieren. Im E-Commerce empfehlen Empfehlungsmotoren Produkte auf der Grundlage des Kaufverlaufs und des Nutzerverhaltens. In der Industrie optimiert KI die Lieferkette, sagt Maschinenausfälle voraus und automatisiert Qualitätskontrollprozesse.
Beispiel: Medizinische Diagnose
Ein KI-System, das mit Tausenden von Netzhautbildern trainiert wurde, kann Anzeichen von Diabetes oder Glaukom mit einer Genauigkeit erkennen, die der eines Spezialisten vergleichbar ist. Das Modell analysiert das Bild und erzeugt eine Wahrscheinlichkeit für eine Krankheit, die der Arzt überprüft und bestätigt. Dieser Ansatz ermöglicht es, die diagnostische Kapazität in Gebieten mit Mangel an Spezialisten zu skalieren und den Zugang zur Gesundheitsversorgung zu verbessern.
Grenzen, Risiken und die Notwendigkeit der Aufsicht
Trotz ihrer Vorteile birgt die KI erhebliche Risiken, die gemanagt werden müssen. Eines der bemerkenswertesten ist die Halluzination, ein Phänomen, bei dem ein generatives Modell Informationen erfindet, die nicht existieren oder falsch sind, und sie mit demselben Vertrauen wie echte Daten präsentiert. Dies geschieht, weil das Modell das nächste wahrscheinlichste Wort oder Element vorhersagt, ohne die Wahrheit der Informationen zu überprüfen.
Ein weiteres wichtiges Risiko ist die Verzerrung in den Trainingsdaten. Wenn die für das Training eines Modells verwendeten Daten nicht repräsentativ für die Zielbevölkerung sind, können die Empfehlungen des Systems bestimmte Gruppen bevorzugen oder benachteiligen. Ein mit verzerrten historischen Daten trainiertes Einstellungsmodell kann beispielsweise die Diskriminierung nach Geschlecht oder Rasse perpetuieren. Menschliche Aufsicht ist unerlässlich, um diese Verzerrungen zu erkennen und zu korrigieren.
Abhängigkeit und Verblasen des Urteils
Übermäßiges Vertrauen in KI-Systeme kann zu technischer Abhängigkeit führen, bei der Fachleute die Vorschläge des Systems ohne kritische Überprüfung übernehmen. Dies ist besonders besorgniserregend in kritischen Sektoren wie Gesundheit oder Justiz, wo ein Fehler schwerwiegende Konsequenzen haben kann. Die Schulung der Benutzer und die Implementierung von Verifizierungsprotokollen sind wesentlich, um dieses Risiko zu mindern.
Grundlegendes Glossar wichtiger Begriffe
Um KI zu verstehen, ist es nützlich, sich mit einigen technischen Begriffen vertraut zu machen. Ein Modell ist die mathematische Darstellung, die das System verwendet, um Vorhersagen zu treffen. Ein Dataset (Datensatz) ist die Sammlung von Informationen, mit der das Modell trainiert wird. Die Inferenz ist der Prozess, das trainierte Modell auf neue Daten anzuwenden, um eine Antwort zu erhalten.
Das Training ist die Phase, in der das Modell seine Parameter anpasst, um den Fehler in den Trainingsdaten zu minimieren. Die Validierung ist der Prozess, das Modell mit Daten zu bewerten, die es während des Trainings nicht gesehen hat, um seine Generalisierungsfähigkeit zu messen. Overfitting tritt auf, wenn das Modell die Trainingsdaten auswendig lernt, anstatt allgemeine Muster zu lernen, was seine Leistung auf neuen Daten reduziert.
Bedeutung der Datenqualität
Die Datenqualität ist entscheidend für den Erfolg eines KI-Systems. Unvollständige, verrauschte oder verzerrte Daten können zu ungenauen oder ungerechten Modellen führen. Die Datenverwaltung (Data Governance) umfasst die Einrichtung von Prozessen, um die Qualität, Privatsphäre und Sicherheit der für Training und Inferenz verwendeten Informationen zu gewährleisten. Ohne eine solide Datenbank wird selbst der fortschrittlichste Algorithmus nicht korrekt funktionieren.