El fin de la separación CPU-GPU en el escritorio
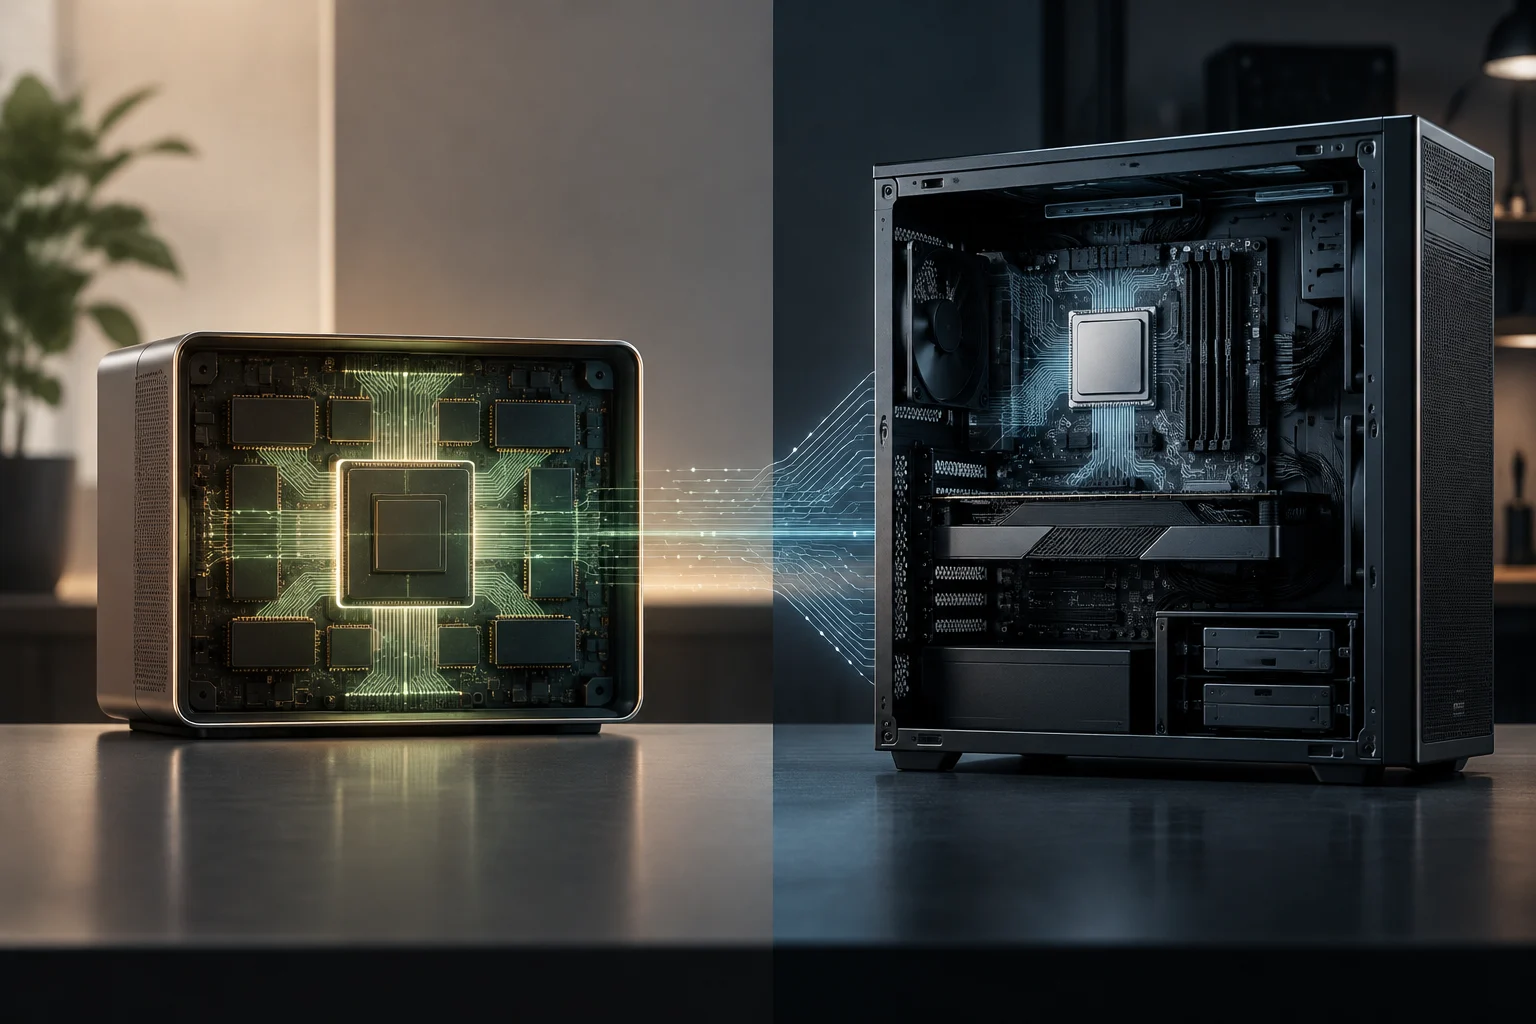
Durante décadas, el diseño de un PC de sobremesa se basó en la separación estricta entre CPU y GPU, conectadas mediante buses PCI Express. Esta arquitectura permitía escalar cada componente de forma independiente, pero imponía un cuello de botella en la transferencia de datos. NVIDIA RTX Spark, anunciado en mayo de 2026, propone una ruptura radical al integrar ambos procesadores en un único superchip con memoria unificada, eliminando la barrera física entre el cálculo general y el gráfico.
Este cambio no es meramente incremental; representa una redefinición del flujo de datos. En un sistema tradicional, mover un modelo de IA de la RAM a la VRAM requiere copias costosas. En RTX Spark, la CPU Grace y la GPU Blackwell comparten el mismo espacio de direcciones, lo que permite que los datos permanezcan en la memoria LPDDR5X sin penalización de latencia adicional por transferencia. Esta es la base técnica que permite ejecutar modelos de gran escala localmente sin depender de la nube.
Anatomía del superchip GB10 Grace Blackwell
El corazón de la plataforma es el superchip GB10, que combina una CPU de 20 núcleos Arm (arquitectura Grace) con una GPU Blackwell de 6144 núcleos CUDA en su variante de sobremesa. La especificación clave es la memoria unificada de hasta 128 GB LPDDR5X, con un ancho de banda de 273 GB/s. A diferencia de la VRAM GDDR6X de las GPUs dedicadas, que ofrece anchos de banda superiores (a menudo >1000 GB/s), la memoria unificada prioriza la capacidad y la eficiencia energética sobre la velocidad bruta de transferencia.
En términos de rendimiento de IA, NVIDIA declara 1 petaFLOP de rendimiento en FP4 para la variante de sobremesa. Esta cifra se logra gracias a los Tensor Cores de quinta generación y la arquitectura Blackwell, optimizada para inferencia con precisión reducida. La eficiencia energética es otro pilar: el TDP de la plataforma de sobremesa se sitúa en 140 W, una fracción del consumo de una configuración x86 con GPU de gama alta equivalente, que suele superar los 300 W bajo carga máxima.
Especificaciones técnicas clave
| Componente | RTX Spark (Sobremesa) | PC Tradicional (Referencia) |
|---|---|---|
| CPU | 20 núcleos Arm (Grace) | x86 (ej. Ryzen 9 / Core i9) |
| GPU | 6144 núcleos Blackwell | GPU dedicada (ej. RTX 4080) |
| Memoria | 128 GB LPDDR5X Unificada | 32-64 GB DDR5 + 16-24 GB VRAM |
| Ancho de banda | 273 GB/s | ~700-1000 GB/s (VRAM) |
| TDP | 140 W | 300-450 W (sistema completo) |
Ventajas en inferencia de IA local
La principal ventaja de la arquitectura unificada se manifiesta en la ejecución de modelos de lenguaje grandes (LLM). Con 128 GB de memoria unificada, RTX Spark puede cargar modelos de hasta 120.000 millones de parámetros en precisión FP4 o modelos más pequeños en FP16, algo imposible en un PC tradicional con 24 GB de VRAM. Esto permite a desarrolladores y profesionales ejecutar inferencia local con contextos de hasta 1 millón de tokens, manteniendo la privacidad de los datos y eliminando la latencia de red asociada a las APIs en la nube.
Sin embargo, el ancho de banda de 273 GB/s es una limitación real para la velocidad de inferencia (tokens por segundo). En cargas de trabajo donde la velocidad de generación es crítica, una GPU dedicada con VRAM GDDR6X de mayor ancho de banda puede superar a RTX Spark en tokens por segundo, siempre que el modelo quepa en la VRAM. La memoria unificada gana en capacidad y flexibilidad, pero no necesariamente en velocidad bruta de procesamiento para modelos pequeños que caben en VRAM.
Creatividad y renderizado: el papel de la memoria unificada
Para creadores de contenido, la memoria unificada permite manejar escenas 3D de más de 90 GB y editar vídeo en 12K 4:2:2 sin fragmentar los datos entre RAM y VRAM. Adobe ha rearquitecturado Photoshop y Premiere Express para aprovechar esta arquitectura, prometiendo un rendimiento 2 veces superior en tareas de IA y gráficos. Esto significa que flujos de trabajo complejos, como la composición de vídeo con múltiples capas de IA, pueden ejecutarse de forma más fluida al eliminar las copias de memoria.
En renderizado 3D, la arquitectura Blackwell con núcleos de trazado de rayos de cuarta generación ofrece un rendimiento competitivo. No obstante, para cargas de trabajo puramente de renderizado offline donde la velocidad es el único factor, una GPU dedicada de gama alta sigue siendo más rápida debido a su mayor ancho de banda de memoria y mayor número de núcleos CUDA en modelos tope de gama. RTX Spark ofrece un equilibrio superior entre capacidad de memoria y rendimiento, ideal para iteraciones rápidas en tiempo real.
Limitaciones de compatibilidad y software
La transición a una arquitectura Arm en Windows introduce desafíos de compatibilidad. Aunque más de 100 proveedores de software, incluyendo Adobe, Blender y desarrolladores de juegos como Riot Games, han lanzado versiones nativas para Arm, no todo el software está optimizado. Las aplicaciones x86 pueden ejecutarse mediante emulación, pero con una penalización de rendimiento que varía según la carga de trabajo. Para usuarios que dependen de software de nicho o drivers específicos de hardware, la falta de soporte nativo puede ser un obstáculo significativo.
Además, la plataforma es menos modular que un PC tradicional. La memoria unificada no es ampliable, y la GPU no puede sustituirse por una más potente. Esto contrasta con la arquitectura x86, donde el usuario puede actualizar la RAM, la GPU o el almacenamiento de forma independiente. La decisión de adoptar RTX Spark implica aceptar un sistema cerrado a cambio de una integración más profunda entre CPU, GPU y memoria, optimizada para cargas de trabajo de IA y creatividad.
Disponibilidad, precio y propuesta de valor
NVIDIA RTX Spark está disponible en portátiles y sobremesas de integradores como ASUS, Dell, HP, Lenovo, Microsoft Surface y MSI, con modelos de Acer y GIGABYTE previstos. El precio de entrada para las sobremesas se sitúa en torno a los 3.999-4.699 dólares, una cifra comparable a una build tradicional de gama alta. La propuesta de valor no es el precio por rendimiento bruto, sino la eficiencia energética y la capacidad de memoria unificada para cargas de trabajo de IA local.
Para un usuario que necesita ejecutar modelos de IA grandes localmente o trabajar con archivos de vídeo de alta resolución, RTX Spark ofrece una ventaja clara. Para un jugador que prioriza la máxima tasa de refresco en juegos AAA o un profesional que necesita la máxima velocidad de renderizado offline, una configuración x86 con GPU dedicada sigue siendo la opción más versátil y, en muchos casos, más económica a largo plazo debido a la posibilidad de actualización de componentes.
Conclusión: ¿Para quién tiene sentido la transición?
NVIDIA RTX Spark no busca reemplazar a todos los PCs de sobremesa, sino definir una nueva categoría para usuarios que priorizan la IA local y la creatividad avanzada. Es la elección ideal para desarrolladores de IA, científicos de datos y creadores de contenido que necesitan capacidad de memoria masiva y eficiencia energética. Para el resto de usuarios, la arquitectura separada x86 + GPU dedicada sigue siendo la opción más madura, versátil y económica, con un ecosistema de software más amplio y la posibilidad de personalización y actualización a largo plazo.
La decisión final depende del perfil de uso: si la carga de trabajo principal es la inferencia de modelos grandes o la edición de vídeo de alta resolución, RTX Spark ofrece una ventaja arquitectónica significativa. Si la prioridad es la máxima velocidad en juegos o renderizado offline, o la necesidad de actualizar componentes individualmente, el PC tradicional sigue siendo la opción más práctica. La arquitectura unificada es el futuro para la IA personal, pero no es la solución universal para todas las cargas de trabajo de escritorio.