Una estación de IA de escritorio, no un PC convencional
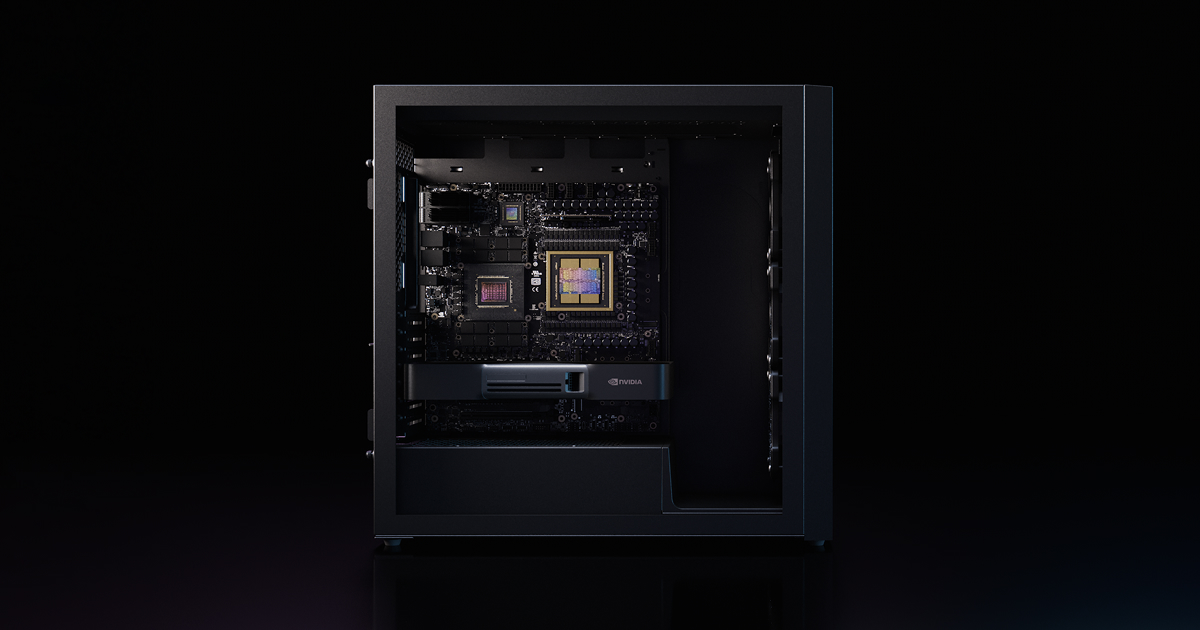
NVIDIA DGX Station es una estación de trabajo de sobremesa construida alrededor del superchip GB300 Grace Blackwell Ultra. NVIDIA la presentó en 2025. La plataforma combina CPU y GPU, memoria coherente de gran capacidad y herramientas de IA de NVIDIA.
DGX Station está diseñada para desarrollar y ejecutar cargas de IA localmente. NVIDIA la dirige a desarrolladores, investigadores y científicos de datos que trabajan con modelos y agentes de IA; su ficha también describe el uso de la estación para inferencia, ajuste fino y ciencia de datos.
El anuncio inicial de DGX Station y el de la versión para Windows son hitos distintos. La ficha de NVIDIA presenta la estación general con Ubuntu y herramientas de desarrollo de IA; la variante para Windows se anuncia con el sistema operativo de Microsoft y disponibilidad prevista para el cuarto trimestre. Por eso, Windows no describe todas las configuraciones de DGX Station ni garantiza por sí solo la compatibilidad de cualquier aplicación o modelo.
GB300 y memoria coherente: la especificación que cambia la escala
El GB300 combina una GPU NVIDIA Blackwell Ultra con una CPU NVIDIA Grace de 72 núcleos basada en Neoverse V2. La ficha técnica de NVIDIA especifica hasta 748 GB de memoria coherente: 252 GB de HBM3e asociados a la GPU y 496 GB de LPDDR5X para la CPU. No se trata de una única memoria homogénea con idéntico ancho de banda: la ficha indica 7,1 TB/s para la HBM3e y 396 GB/s para la LPDDR5X.
La conexión entre CPU y GPU usa NVLink-C2C, que permite un espacio de memoria coherente compartido. Esta arquitectura permite trabajar con modelos grandes dentro de un mismo espacio de memoria. La capacidad total ayuda a alojar modelos de mayor tamaño, pero no significa que todos los datos accedan a la velocidad de la HBM3e ni que cada aplicación aproveche la memoria de la misma forma.
NVIDIA declara hasta 20 PFLOPS de cómputo Tensor FP4, con sparsity, y hasta 15 PFLOPS sin esa condición. También publica cifras diferentes para otras precisiones, como 10 PFLOPS FP8/FP6 y 5 PFLOPS FP16/BF16. Esas métricas describen tasas máximas de operaciones bajo precisiones y condiciones concretas; no equivalen a una medida universal de velocidad para inferencia, ajuste fino o entrenamiento. El rendimiento real depende del modelo, la precisión, el software y el tamaño de lote.
| Recurso | Especificación publicada | Qué conviene tener en cuenta |
|---|---|---|
| Memoria HBM3e de GPU | 252 GB; 7,1 TB/s | Memoria de alto ancho de banda para el acelerador |
| Memoria LPDDR5X de CPU | 496 GB; 396 GB/s | Amplía el espacio coherente, con ancho de banda distinto |
| Memoria coherente total | Hasta 748 GB | Capacidad compartida; no es toda HBM3e |
| Rendimiento Tensor FP4 | Hasta 20 PFLOPS con sparsity | Métrica máxima condicionada por precisión y sparsity |
| Potencia total del sistema | 1.600 W | Requiere considerar circuito eléctrico, calor y refrigeración |
Windows amplía la integración, pero no elimina las diferencias de software
La edición DGX Station for Windows está planteada para conectar el cómputo local con aplicaciones y flujos corporativos que ya funcionan en Windows. NVIDIA indica soporte de la pila de software de IA de la compañía y acceso a herramientas Linux mediante Windows Subsystem for Linux (WSL).
La opción no convierte los programas de IA en software independiente del sistema operativo. La compatibilidad depende de las herramientas y el entorno elegidos: NVIDIA indica que DGX Station for Windows admite su pila de software de IA y herramientas de Linux mediante Windows Subsystem for Linux (WSL).
NVIDIA presenta DGX Station con Ubuntu y herramientas de desarrollo de IA. La variante para Windows se anuncia con acceso a herramientas Linux mediante Windows Subsystem for Linux (WSL), pero su disponibilidad está prevista para el cuarto trimestre. La elección del sistema operativo depende de las aplicaciones y herramientas que vaya a utilizar el equipo y de su entorno de despliegue.
La edición para Windows añade además un enfoque de gestión empresarial, con telemetría fuera de banda mediante BMC y funciones de administración. NVIDIA también describe el uso de WSL para cargas Linux. Esas capacidades pueden facilitar el despliegue en una flota corporativa, aunque la seguridad efectiva dependerá de las políticas configuradas, las actualizaciones y la administración de cada organización; no se deduce únicamente de la presencia de Windows.
Qué trabajos pueden beneficiarse de una máquina local de esta escala
La combinación de mucha memoria y cómputo Tensor puede ser útil para inferencia de modelos grandes, experimentación con agentes, análisis de datos y ajuste fino, siempre que el software y la precisión elegidos se ajusten al hardware. NVIDIA plantea ejecutar localmente modelos de hasta un billón de parámetros; es una capacidad declarada por el fabricante, no una garantía de que cualquier modelo de ese tamaño funcione con una velocidad, contexto o calidad determinados.
Para los equipos que trabajan con datos confidenciales, el procesamiento local permite mantener los datos dentro de su propia infraestructura si la aplicación y la configuración no los envían a servicios externos. Esto puede ayudar a reducir la dependencia de una API remota y a controlar el acceso a los datos, pero el hardware por sí solo no garantiza privacidad: hay que revisar telemetría, conexiones, herramientas de terceros, almacenamiento y políticas de los agentes.
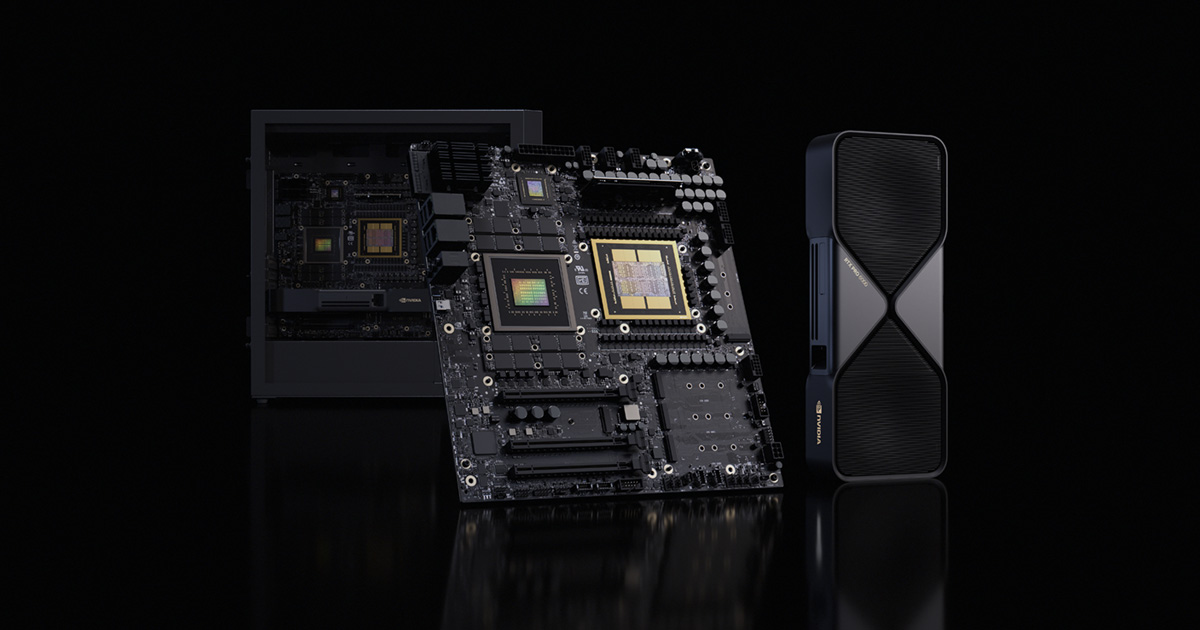
La estación también puede combinarse con una GPU NVIDIA RTX PRO Blackwell adicional para visualización trazada por rayos y simulación, según la configuración admitida. Esa posibilidad es relevante para trabajos que juntan IA y gráficos profesionales, como visualización técnica o aplicaciones de IA física. No debe confundirse con la capacidad de la GPU integrada: la tarjeta adicional es una configuración distinta y su disponibilidad depende del fabricante del sistema.
En cambio, tareas generales de escritorio, juegos o cargas que usan poco acelerador no justifican por sí solas una estación de esta categoría. Para inferencia ligera, modelos pequeños o uso ocasional, un PC con GPU dedicada, una estación de trabajo menos costosa o un servicio en la nube podrían ser alternativas más proporcionadas. La pregunta práctica no es si DGX Station puede ejecutar IA, sino si la memoria, el rendimiento y el control local resuelven una necesidad recurrente que otras opciones no cubren.
Consumo, despliegue y coste: los límites que deben entrar en el cálculo
NVIDIA publica una potencia total del sistema de 1.600 W y señala que requiere un circuito de 20 A. Eso cambia la evaluación de una máquina de escritorio: además del espacio físico, hay que considerar la instalación eléctrica, la disipación térmica y el ruido en el lugar de trabajo.
La potencia nominal no permite calcular por sí sola el coste eléctrico real: el consumo depende de la carga, el tiempo de uso, la configuración y el precio local de la energía. Tampoco permite comparar rendimiento por vatio con una GPU de sobremesa sin pruebas equivalentes de la misma tarea, precisión y software. Una cifra máxima de PFLOPS y otra de potencia máxima no sustituyen mediciones comparables.
NVIDIA presenta DGX Station como un producto de fabricantes asociados e invita a contactar con ellos para pedir el sistema. Antes de comprar, conviene solicitar una cotización completa que detalle impuestos, plazo, garantía, servicio y los componentes incluidos.
Al comparar una estación de trabajo, conviene considerar más que el precio de una GPU: también importan la capacidad de memoria, la configuración del sistema, las opciones de ampliación y el presupuesto. DGX Station integra una gran capacidad de memoria coherente en una plataforma de sobremesa. La decisión depende de las necesidades concretas del proyecto.
Para quién tiene sentido y qué comprobar antes de decidir
NVIDIA describe DGX Station para desarrollar y ejecutar IA localmente y plantea su uso con modelos grandes, inferencia, ajuste fino y agentes de IA. La plataforma también permite desarrollar en local y escalar o desplegar cargas en centros de datos o en la nube de NVIDIA.
Para un desarrollador individual, conviene evaluar la compra según las cargas de trabajo previstas y la configuración necesaria. El tamaño del modelo no basta para decidir: también importan la longitud del contexto, la cuantización, la concurrencia, la latencia aceptable y el rendimiento que exige el proyecto.
Antes de decidir, conviene comprobar estos puntos:
- Que los modelos y marcos de trabajo necesarios soporten la configuración y el sistema operativo elegidos.
- Cuánta memoria requiere la carga real, separando capacidad de memoria de ancho de banda.
- Si basta con inferencia y prototipado o si el proyecto exige entrenamiento a gran escala.
- Que la instalación eléctrica y la refrigeración del espacio admitan un sistema de 1.600 W.
- Qué precio, componentes, garantía y plazo ofrece el fabricante asociado en el mercado correspondiente.
La ficha de NVIDIA especifica hasta 748 GB de memoria coherente y un sistema de 1.600 W. Al comparar opciones, considera esos requisitos junto con las cargas de trabajo y la configuración necesarias.