La frontera crítica: privacidad local frente a nube
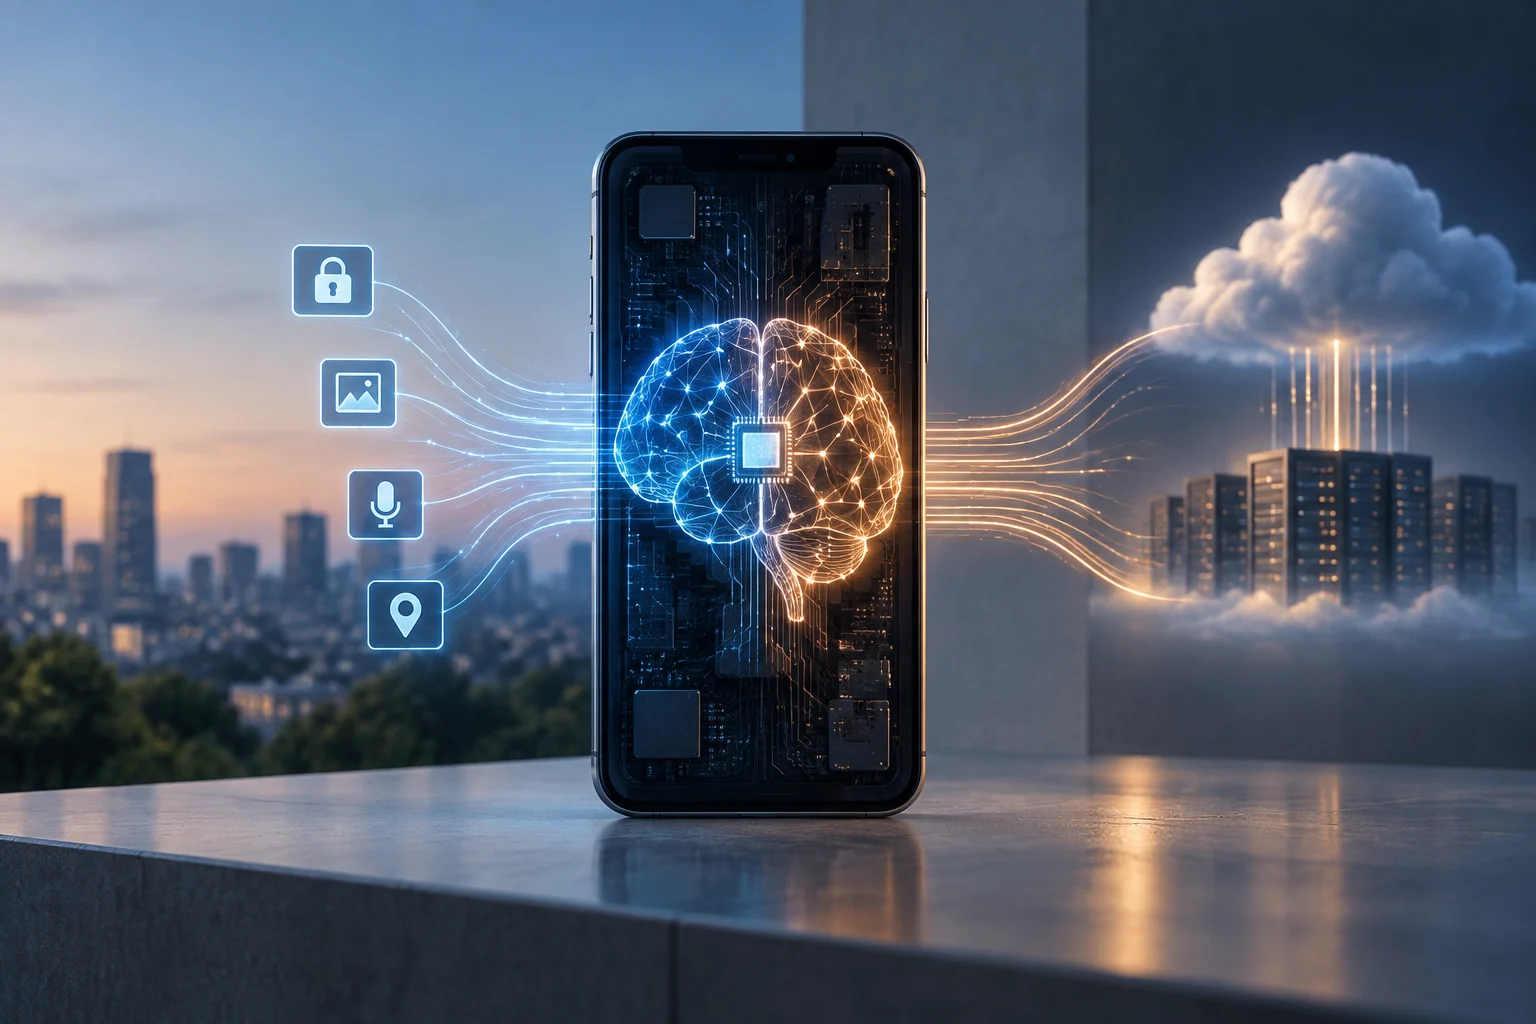
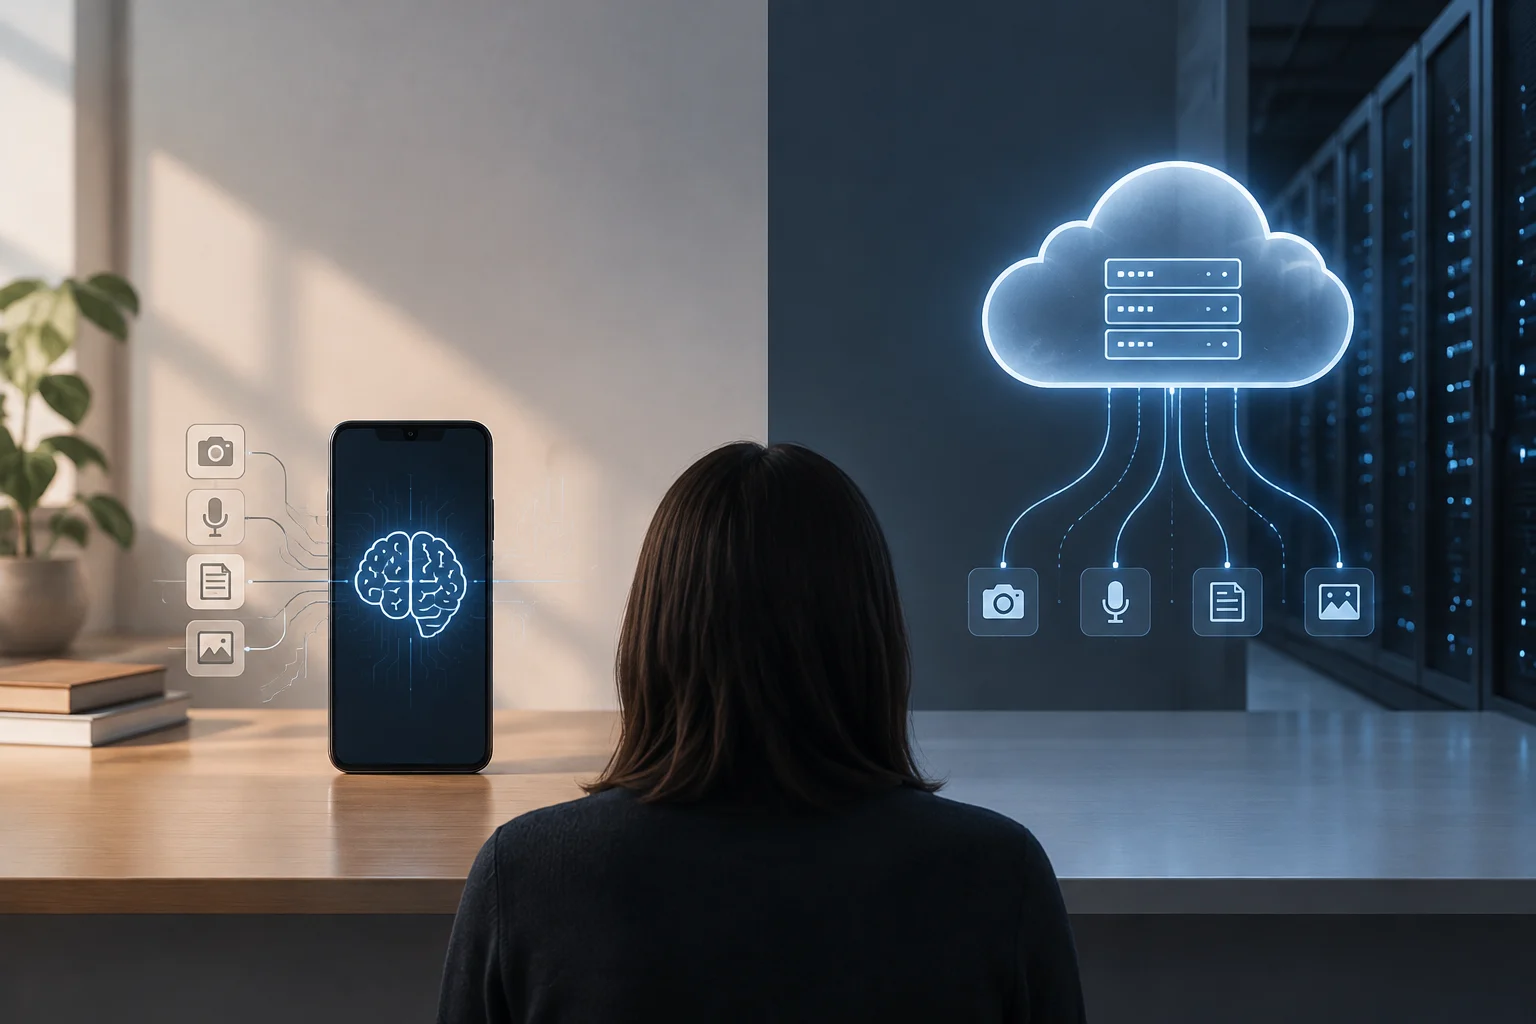
La distinción fundamental entre una aplicación de IA local y una basada en la nube radica en dónde se ejecuta el modelo. En el procesamiento local, la inferencia ocurre dentro de tu hardware, lo que significa que los datos no salen del dispositivo. En cambio, las soluciones en la nube envían cada consulta a servidores remotos, donde se procesa y se devuelve la respuesta.
Esta diferencia no es solo técnica, sino de soberanía de datos. Según fuentes especializadas, la IA local permite mantener la información sensible dentro de la máquina, reduciendo la exposición a terceros. Sin embargo, es crucial entender que "local" no siempre significa "sin conexión": funciones como sincronización, facturación o actualizaciones pueden requerir red incluso en apps locales.
Para el usuario promedio, esta distinción determina el nivel de riesgo. Si manejas datos corporativos, médicos o financieros, la verificación del modelo de procesamiento es un paso de seguridad obligatorio antes de adoptar cualquier herramienta de IA generativa.
Paso 1: Auditar la documentación oficial de la aplicación
El primer paso para verificar el origen del procesamiento es consultar la documentación técnica oficial del desarrollador. Busca secciones específicas sobre "arquitectura", "requisitos de sistema" o "privacidad de datos". Las apps que ejecutan modelos localmente suelen especificar el tamaño de los modelos descargables y los requisitos de VRAM o RAM.
En el caso de herramientas como Ollama, LM Studio o PocketPal AI, la documentación indica claramente que los modelos se descargan y ejecutan en el dispositivo. Por el contrario, aplicaciones como ChatGPT o Gemini especifican que el procesamiento ocurre en la infraestructura de la nube del proveedor, utilizando servicios como Microsoft Azure o Google Cloud.
Un indicador clave es la presencia de modelos de código abierto (como Llama, Qwen o Gemma) en la lista de compatibilidad. Si la app permite cargar pesos de modelos locales, es muy probable que ofrezca una opción de inferencia local, aunque a menudo coexista con una opción de nube para modelos más potentes.
Paso 2: Analizar permisos de red y almacenamiento
Los permisos solicitados por la aplicación en tu sistema operativo son una pista técnica directa. Una app de IA puramente local necesita permisos de almacenamiento masivo para guardar los pesos del modelo (que pueden ocupar varios gigabytes) y permisos de acceso a la GPU o NPU para la inferencia.
En cuanto a la red, una app local idealmente solo debería requerir conexión para la descarga inicial del modelo y las actualizaciones. Si la aplicación solicita permisos de red constantes y no permite el modo sin conexión, es probable que esté enviando datos a la nube. Puedes usar herramientas de monitorización de red para ver si hay tráfico saliente constante durante la inferencia.
Es importante distinguir entre telemetría y procesamiento de datos. Muchas apps locales envían métricas de rendimiento o errores a sus servidores, pero no el contenido de tus prompts. La documentación de privacidad debe aclarar explícitamente qué datos se transmiten y con qué finalidad.
Paso 3: Verificar la capacidad del hardware del dispositivo
No todo hardware puede ejecutar IA local de forma eficiente. La capacidad de inferencia local depende críticamente de la VRAM (memoria de video) y la RAM del sistema. Para modelos de lenguaje medianos, se recomiendan al menos 8-16 GB de VRAM, mientras que para modelos pequeños, 4-8 GB pueden ser suficientes.
Si tu dispositivo no cuenta con una GPU dedicada potente o suficiente RAM, es técnicamente improbable que la app esté ejecutando el modelo localmente, a menos que sea un modelo muy pequeño y destilado. En móviles, la presencia de una NPU (Unidad de Procesamiento Neural) es un indicador de que el fabricante optimiza para IA local, como se ve en dispositivos de ASUS, HP o Lenovo.
Puedes verificar tus especificaciones en el administrador de tareas (Windows) o en la información del sistema (macOS). Si la app consume recursos de GPU significativos al responder, es una señal fuerte de procesamiento local. Si la CPU y GPU permanecen inactivas mientras la app responde, el trabajo se está haciendo en la nube.
Paso 4: Interpretar la política de privacidad
La política de privacidad es el documento legal que define qué hace la empresa con tus datos. Busca cláusulas que mencionen "entrenamiento de modelos" con datos de usuarios. Si la política indica que tus prompts se utilizan para mejorar el servicio, tus datos están saliendo de tu dispositivo y siendo procesados por terceros.
En las apps locales, la política de privacidad suele ser más breve y específica: indica que los datos se procesan en el dispositivo del usuario y que no se almacenan en servidores centrales. Sin embargo, debe aclarar si se recopilan metadatos de uso o si hay funciones de sincronización que podrían enviar datos a la nube.
Un matiz importante: algunas apps "híbridas" permiten elegir entre local y nube. En estos casos, la política de privacidad debe detallar las condiciones de cada modo. Si no hay claridad, asume que el modo por defecto es el de mayor riesgo, es decir, la nube.
Decisiones prácticas para la privacidad de datos
Basado en la verificación, puedes tomar decisiones informadas. Si la privacidad es tu prioridad máxima, elige apps que ofrezcan inferencia 100% local y verifica que tu hardware sea capaz de soportar los modelos que necesitas. Herramientas como Ollama o LM Studio son estándar en este ámbito.
Si necesitas capacidades avanzadas que tu hardware no soporta, considera usar la nube, pero activa las opciones de privacidad reforzada si el proveedor las ofrece (como la desactivación del entrenamiento con tus datos). En entornos corporativos, herramientas como Sophos Protected Browser permiten restringir la carga de archivos en apps de IA para prevenir fugas de datos.
La clave es la transparencia técnica. No confíes solo en el marketing de "privacidad"; verifica los permisos, el hardware y la documentación. Un usuario informado puede equilibrar la conveniencia de la nube con la seguridad del procesamiento local según la sensibilidad de cada tarea.