A fronteira crítica: privacidade local frente à nuvem
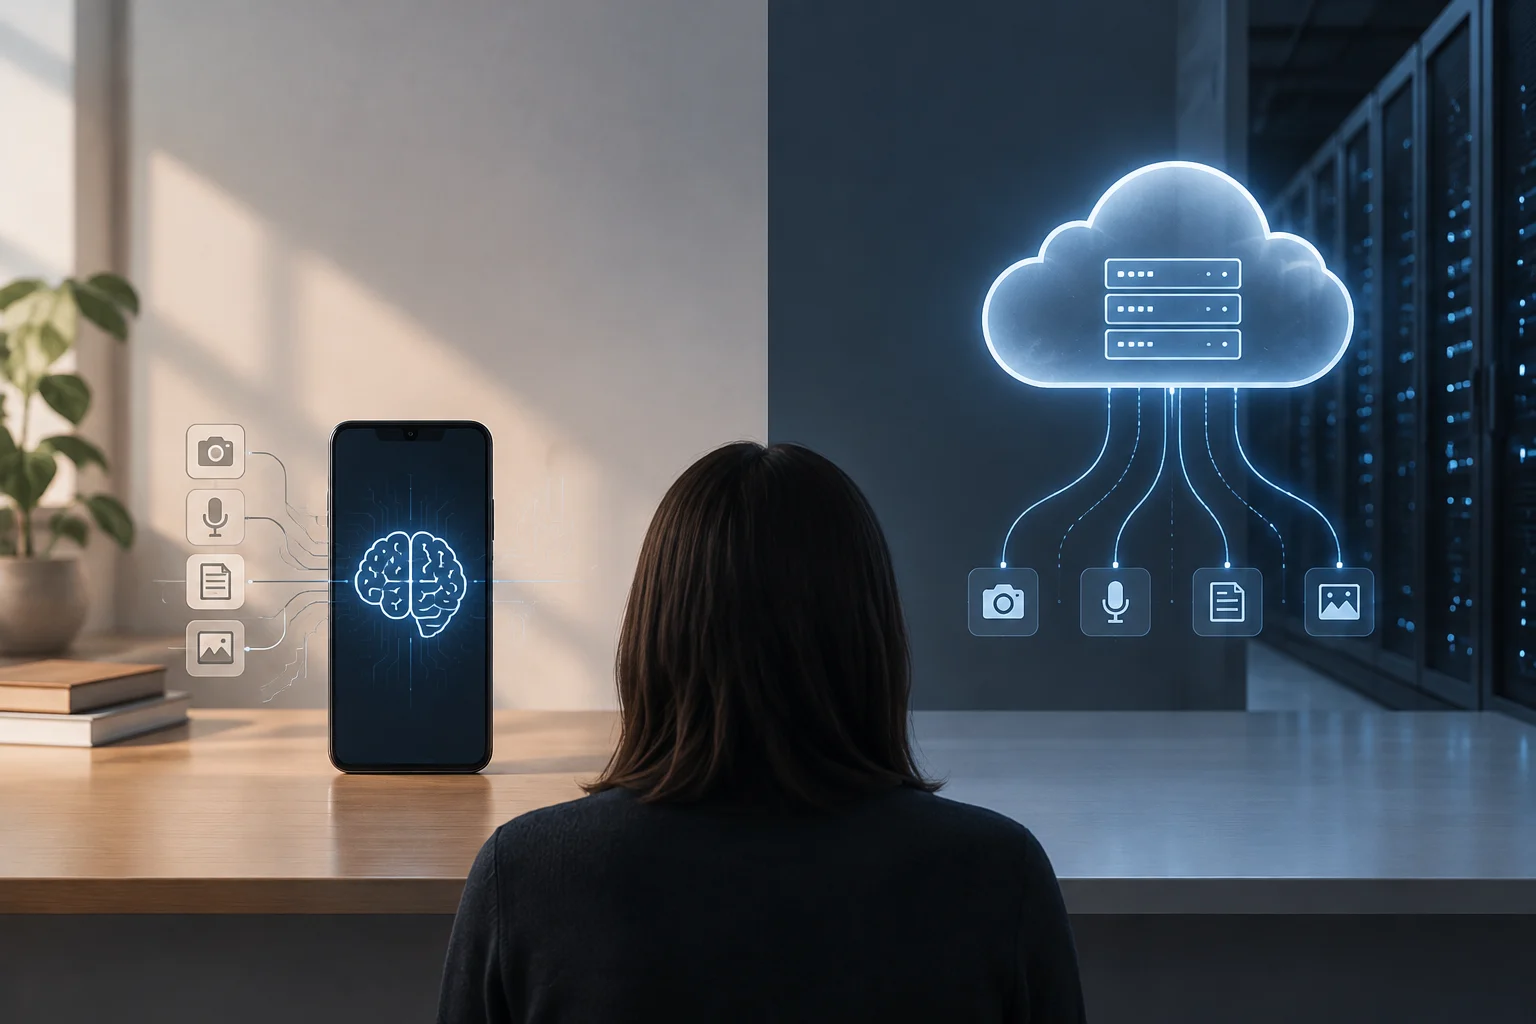
A distinção fundamental entre uma aplicação de IA local e uma baseada na nuvem reside em onde o modelo é executado. No processamento local, a inferência ocorre dentro do seu hardware, o que significa que os dados não saem do dispositivo. Em contraste, as soluções na nuvem enviam cada consulta a servidores remotos, onde é processada e a resposta é devolvida.
Esta diferença não é apenas técnica, mas de soberania de dados. Segundo fontes especializadas, a IA local permite manter informações sensíveis dentro da máquina, reduzindo a exposição a terceiros. No entanto, é crucial entender que "local" nem sempre significa "offline": funções como sincronização, faturamento ou atualizações podem requerer rede mesmo em apps locais.
Para o usuário médio, esta distinção determina o nível de risco. Se você lida com dados corporativos, médicos ou financeiros, a verificação do modelo de processamento é um passo de segurança obrigatório antes de adotar qualquer ferramenta de IA generativa.
Passo 1: Auditar a documentação oficial da aplicação
O primeiro passo para verificar a origem do processamento é consultar a documentação técnica oficial do desenvolvedor. Procure seções específicas sobre "arquitetura", "requisitos de sistema" ou "privacidade de dados". Apps que executam modelos localmente geralmente especificam o tamanho dos modelos baixáveis e os requisitos de VRAM ou RAM.
No caso de ferramentas como Ollama, LM Studio ou PocketPal AI, a documentação indica claramente que os modelos são baixados e executados no dispositivo. Em contraste, aplicações como ChatGPT ou Gemini especificam que o processamento ocorre na infraestrutura de nuvem do provedor, utilizando serviços como Microsoft Azure ou Google Cloud.
Um indicador chave é a presença de modelos de código aberto (como Llama, Qwen ou Gemma) na lista de compatibilidade. Se o app permite carregar pesos de modelos locais, é muito provável que ofereça uma opção de inferência local, embora muitas vezes coexista com uma opção de nuvem para modelos mais potentes.
Passo 2: Analisar permissões de rede e armazenamento
As permissões solicitadas pela aplicação no seu sistema operacional são uma pista técnica direta. Um app de IA puramente local precisa de permissões de armazenamento massivo para guardar os pesos do modelo (que podem ocupar vários gigabytes) e permissões de acesso à GPU ou NPU para a inferência.
Quanto à rede, um app local idealmente só deveria requerer conexão para o download inicial do modelo e as atualizações. Se a aplicação solicita permissões de rede constantes e não permite o modo offline, é provável que esteja enviando dados para a nuvem. Você pode usar ferramentas de monitoramento de rede para ver se há tráfego de saída constante durante a inferência.
É importante distinguir entre telemetria e processamento de dados. Muitos apps locais enviam métricas de desempenho ou erros para seus servidores, mas não o conteúdo dos seus prompts. A documentação de privacidade deve esclarecer explicitamente quais dados são transmitidos e com qual finalidade.
Passo 3: Verificar a capacidade do hardware do dispositivo
Nem todo hardware pode executar IA local de forma eficiente. A capacidade de inferência local depende criticamente da VRAM (memória de vídeo) e da RAM do sistema. Para modelos de linguagem médios, recomendam-se pelo menos 8-16 GB de VRAM, enquanto para modelos pequenos, 4-8 GB podem ser suficientes.
Se o seu dispositivo não possui uma GPU dedicada potente ou RAM suficiente, é tecnicamente improvável que o app esteja executando o modelo localmente, a menos que seja um modelo muito pequeno e destilado. Em móveis, a presença de uma NPU (Unidade de Processamento Neural) é um indicador de que o fabricante otimiza para IA local, como visto em dispositivos da ASUS, HP ou Lenovo.
Você pode verificar suas especificações no Gerenciador de Tarefas (Windows) ou nas Informações do Sistema (macOS). Se o app consome recursos de GPU significativos ao responder, é um sinal forte de processamento local. Se a CPU e a GPU permanecem inativas enquanto o app responde, o trabalho está sendo feito na nuvem.
Passo 4: Interpretar a política de privacidade
A política de privacidade é o documento legal que define o que a empresa faz com seus dados. Procure cláusulas que mencionem "treinamento de modelos" com dados de usuários. Se a política indica que seus prompts são usados para melhorar o serviço, seus dados estão saindo do seu dispositivo e sendo processados por terceiros.
Nos apps locais, a política de privacidade costuma ser mais breve e específica: indica que os dados são processados no dispositivo do usuário e não armazenados em servidores centrais. No entanto, deve esclarecer se são coletados metadados de uso ou se há funções de sincronização que podem enviar dados para a nuvem.
Um matiz importante: alguns apps "híbridos" permitem escolher entre local e nuvem. Nesses casos, a política de privacidade deve detalhar as condições de cada modo. Se não houver clareza, assuma que o modo padrão é o de maior risco, ou seja, a nuvem.
Decisões práticas para a privacidade de dados
Baseado na verificação, você pode tomar decisões informadas. Se a privacidade é sua prioridade máxima, escolha apps que ofereçam inferência 100% local e verifique se seu hardware é capaz de suportar os modelos de que você precisa. Ferramentas como Ollama ou LM Studio são padrão nesta área.
Se você precisa de capacidades avançadas que seu hardware não suporta, considere usar a nuvem, mas ative as opções de privacidade reforçada se o provedor as oferecer (como a desativação do treinamento com seus dados). Em ambientes corporativos, ferramentas como Sophos Protected Browser permitem restringir o upload de arquivos em apps de IA para prevenir vazamentos de dados.
A chave é a transparência técnica. Não confie apenas no marketing de "privacidade"; verifique as permissões, o hardware e a documentação. Um usuário informado pode equilibrar a conveniência da nuvem com a segurança do processamento local de acordo com a sensibilidade de cada tarefa.