La frontière critique : confidentialité locale vs cloud
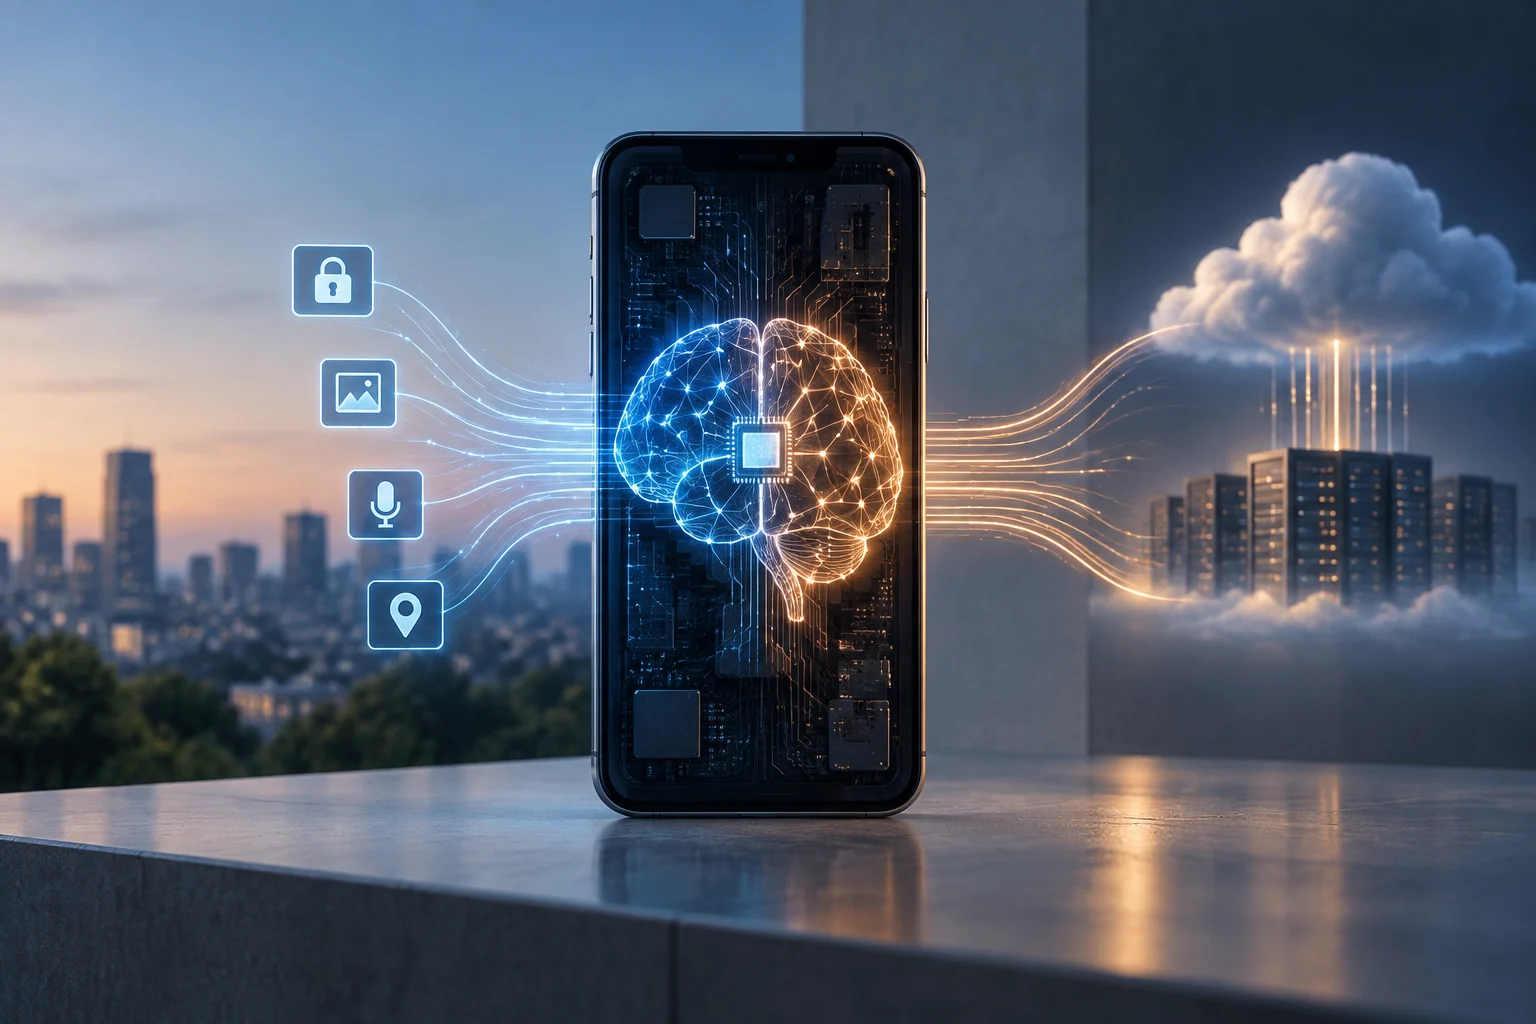
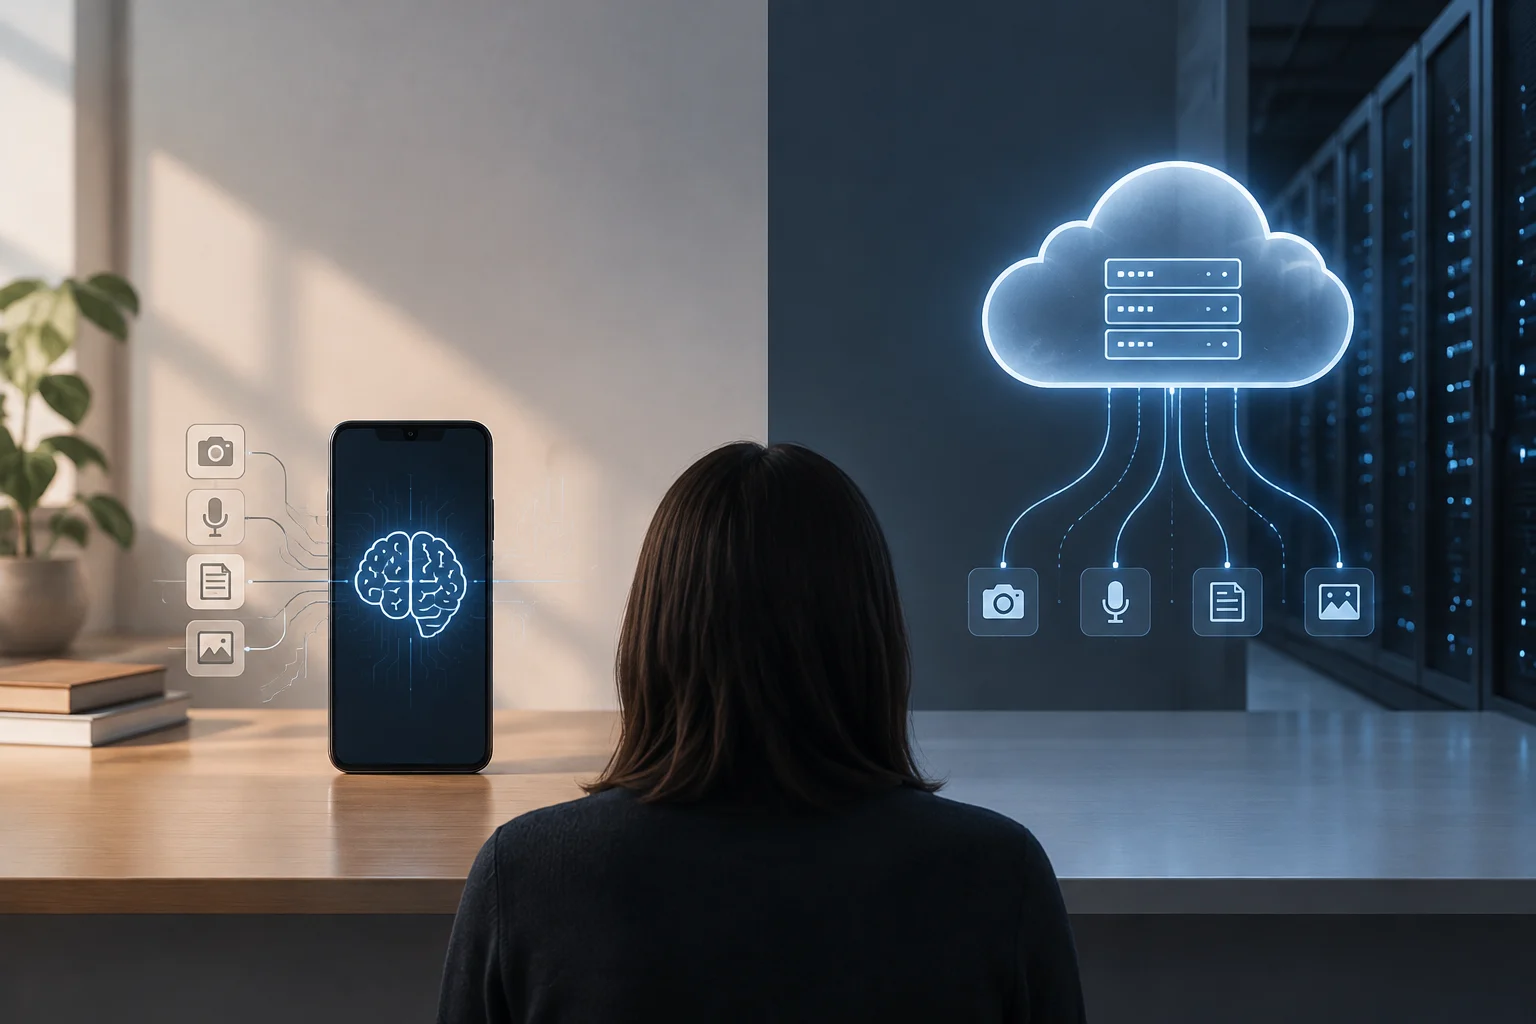
La distinction fondamentale entre une application d'IA locale et une basée sur le cloud réside dans l'endroit où le modèle s'exécute. Dans le traitement local, l'inférence se produit dans votre matériel, ce qui signifie que les données ne quittent pas l'appareil. En revanche, les solutions cloud envoient chaque requête à des serveurs distants, où elle est traitée et la réponse renvoyée.
Cette différence n'est pas seulement technique, mais concerne la souveraineté des données. Selon des sources spécialisées, l'IA locale permet de maintenir les informations sensibles dans la machine, réduisant l'exposition à des tiers. Cependant, il est crucial de comprendre que « local » ne signifie pas toujours « hors ligne » : des fonctions comme la synchronisation, la facturation ou les mises à jour peuvent nécessiter un réseau même dans les apps locales.
Pour l'utilisateur moyen, cette distinction détermine le niveau de risque. Si vous manipulez des données corporatives, médicales ou financières, la vérification du modèle de traitement est une étape de sécurité obligatoire avant d'adopter tout outil d'IA générative.
Étape 1 : Auditer la documentation officielle de l'application
La première étape pour vérifier l'origine du traitement est de consulter la documentation technique officielle du développeur. Cherchez des sections spécifiques sur « architecture », « exigences système » ou « confidentialité des données ». Les apps qui exécutent des modèles localement spécifient généralement la taille des modèles téléchargeables et les exigences de VRAM ou RAM.
Dans le cas d'outils comme Ollama, LM Studio ou PocketPal AI, la documentation indique clairement que les modèles sont téléchargés et exécutés sur l'appareil. En revanche, des applications comme ChatGPT ou Gemini précisent que le traitement se produit dans l'infrastructure cloud du fournisseur, utilisant des services comme Microsoft Azure ou Google Cloud.
Un indicateur clé est la présence de modèles open source (comme Llama, Qwen ou Gemma) dans la liste de compatibilité. Si l'app permet de charger des poids de modèles locaux, il est très probable qu'elle offre une option d'inférence locale, bien qu'elle coexiste souvent avec une option cloud pour des modèles plus puissants.
Étape 2 : Analyser les permissions réseau et stockage
Les permissions demandées par l'application sur votre système d'exploitation sont un indice technique direct. Une app d'IA purement locale a besoin de permissions de stockage massif pour sauvegarder les poids du modèle (qui peuvent occuper plusieurs gigaoctets) et d'accès à la GPU ou NPU pour l'inférence.
Concernant le réseau, une app locale devrait idéalement ne nécessiter une connexion que pour le téléchargement initial du modèle et les mises à jour. Si l'application demande des permissions réseau constantes et n'autorise pas le mode hors ligne, elle envoie probablement des données au cloud. Vous pouvez utiliser des outils de surveillance réseau pour voir s'il y a un trafic sortant constant pendant l'inférence.
Il est important de distinguer entre télémétrie et traitement des données. Beaucoup d'apps locales envoient des métriques de performance ou des erreurs à leurs serveurs, mais pas le contenu de vos prompts. La documentation de confidentialité doit clarifier explicitement quelles données sont transmises et à quelles fins.
Étape 3 : Vérifier la capacité matérielle de l'appareil
Tout le matériel ne peut pas exécuter efficacement l'IA locale. La capacité d'inférence locale dépend critique de la VRAM (mémoire vidéo) et de la RAM système. Pour les modèles de langage de taille moyenne, au moins 8-16 Go de VRAM sont recommandés, tandis que pour les petits modèles, 4-8 Go peuvent suffire.
Si votre appareil ne dispose pas d'une GPU dédiée puissante ou de RAM suffisante, il est techniquement improbable que l'app exécute le modèle localement, sauf s'il s'agit d'un modèle très petit et distillé. Sur mobile, la présence d'une NPU (Unité de Traitement Neuronal) indique que le fabricant optimise pour l'IA locale, comme on le voit dans les appareils ASUS, HP ou Lenovo.
Vous pouvez vérifier vos spécifications dans le Gestionnaire des tâches (Windows) ou les Informations système (macOS). Si l'app consomme des ressources GPU significatives lors de la réponse, c'est un signal fort de traitement local. Si le CPU et la GPU restent inactifs pendant que l'app répond, le travail est fait dans le cloud.
Étape 4 : Interpréter la politique de confidentialité
La politique de confidentialité est le document juridique qui définit ce que l'entreprise fait de vos données. Cherchez des clauses mentionnant le « entraînement de modèles » avec des données d'utilisateurs. Si la politique indique que vos prompts sont utilisés pour améliorer le service, vos données quittent votre appareil et sont traitées par des tiers.
Dans les apps locales, la politique de confidentialité est généralement plus courte et spécifique : elle indique que les données sont traitées sur l'appareil de l'utilisateur et non stockées sur des serveurs centraux. Cependant, elle doit clarifier si des métadonnées d'utilisation sont collectées ou s'il y a des fonctions de synchronisation pouvant envoyer des données au cloud.
Une nuance importante : certaines apps « hybrides » permettent de choisir entre local et cloud. Dans ces cas, la politique de confidentialité doit détailler les conditions de chaque mode. S'il n'y a pas de clarté, supposez que le mode par défaut est le plus risqué, c'est-à-dire le cloud.
Décisions pratiques pour la confidentialité des données
Basé sur la vérification, vous pouvez prendre des décisions éclairées. Si la confidentialité est votre priorité absolue, choisissez des apps offrant une inférence 100 % locale et vérifiez que votre matériel peut supporter les modèles dont vous avez besoin. Des outils comme Ollama ou LM Studio sont standards dans ce domaine.
Si vous avez besoin de capacités avancées que votre matériel ne supporte pas, envisagez d'utiliser le cloud, mais activez les options de confidentialité renforcée si le fournisseur les offre (comme la désactivation de l'entraînement avec vos données). Dans les environnements corporatifs, des outils comme Sophos Protected Browser permettent de restreindre le téléversement de fichiers dans les apps d'IA pour prévenir les fuites de données.
La clé est la transparence technique. Ne vous fiez pas uniquement au marketing de la « confidentialité » ; vérifiez les permissions, le matériel et la documentation. Un utilisateur informé peut équilibrer la commodité du cloud avec la sécurité du traitement local selon la sensibilité de chaque tâche.