La fin de la séparation CPU-GPU sur le bureau
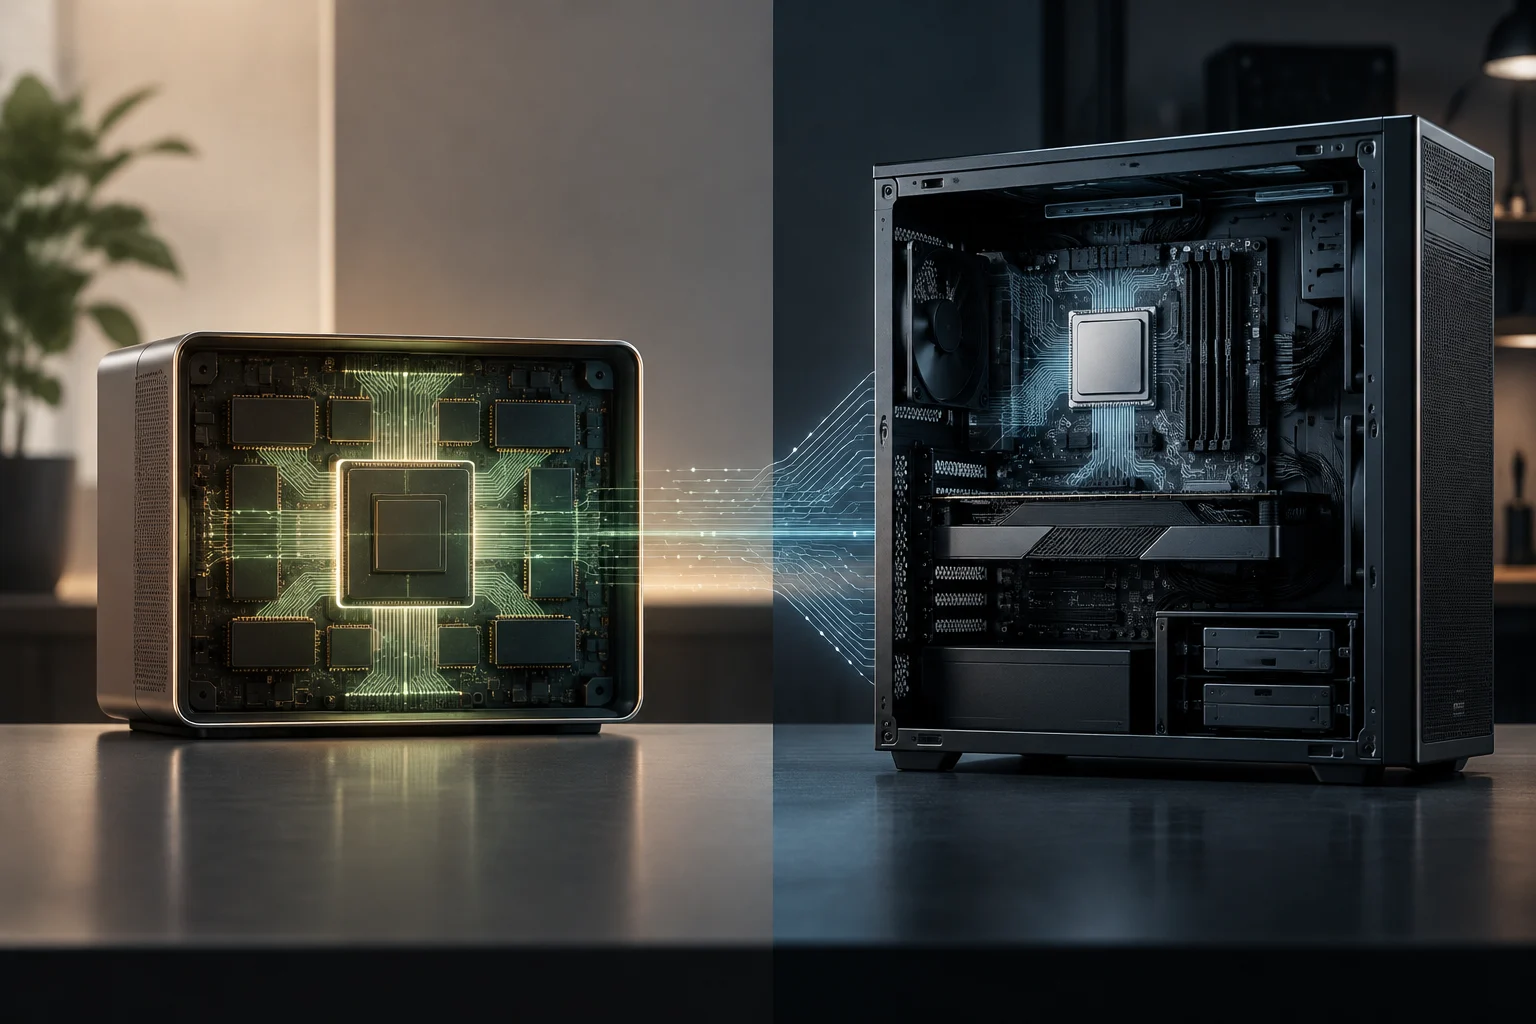
Pendant des décennies, la conception d'un PC de bureau reposait sur la séparation stricte entre CPU et GPU, connectés par des bus PCI Express. Cette architecture permettait d' scaler chaque composant indépendamment, mais imposait un goulot d'étranglement dans le transfert de données. NVIDIA RTX Spark, annoncé en mai 2026, propose une rupture radicale en intégrant les deux processeurs dans un unique superchip avec mémoire unifiée, éliminant la barrière physique entre le calcul général et graphique.
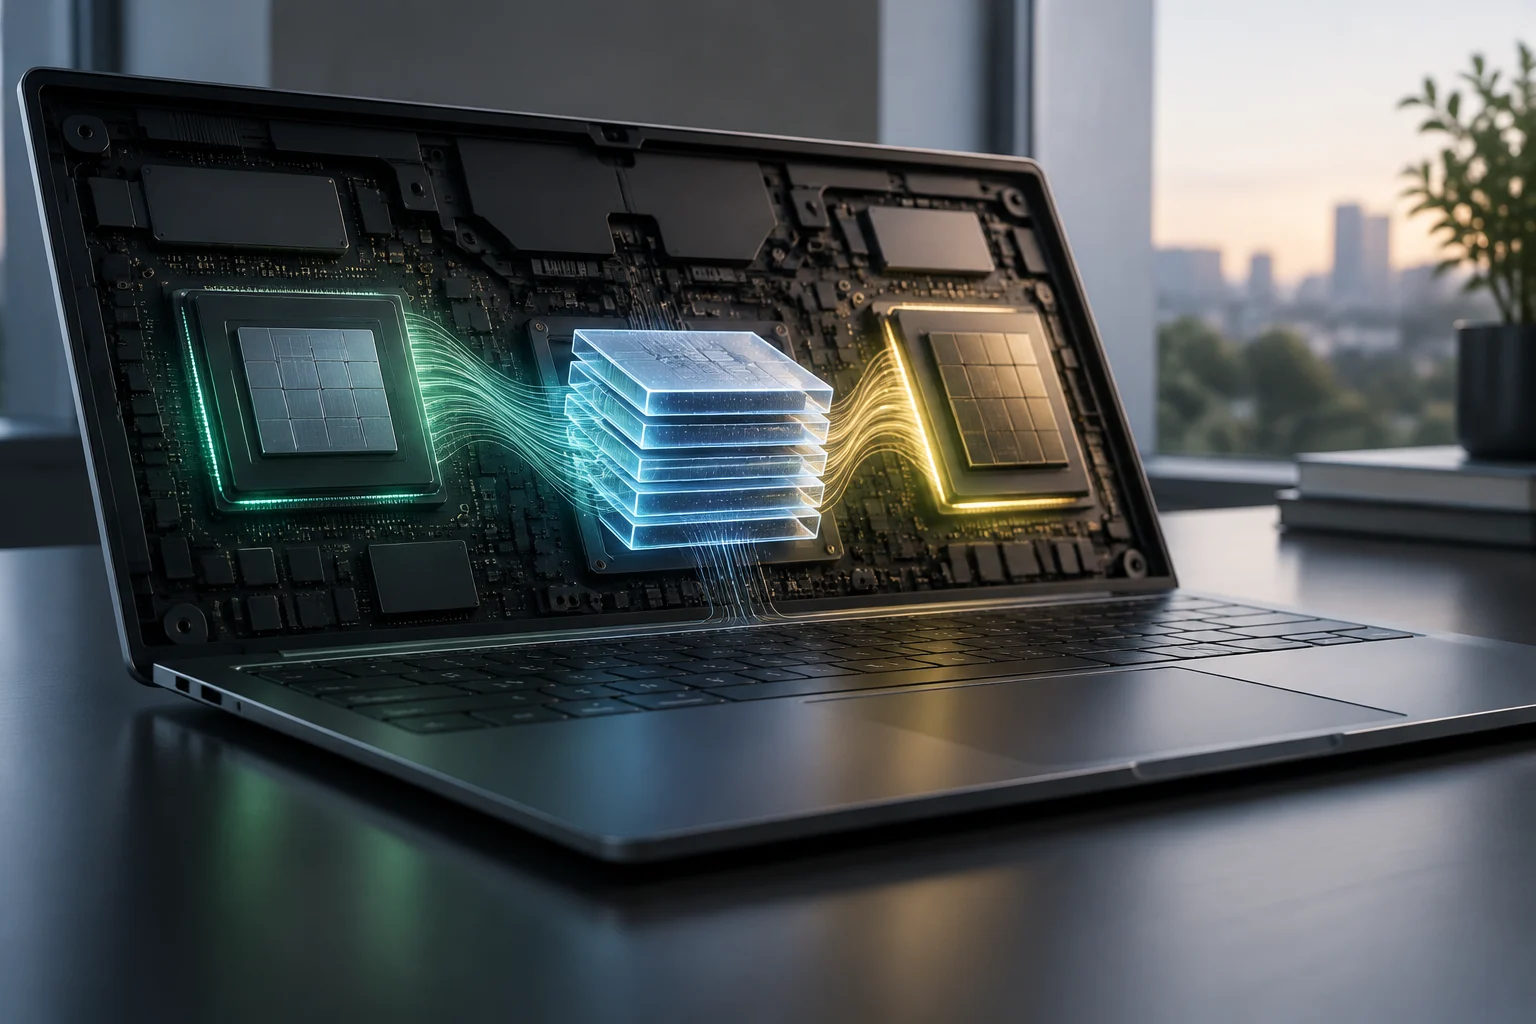
Ce changement n'est pas purement incrémental ; il représente une redéfinition du flux de données. Dans un système traditionnel, déplacer un modèle d'IA de la RAM vers la VRAM nécessite des copies coûteuses. Dans RTX Spark, le CPU Grace et le GPU Blackwell partagent le même espace d'adresses, ce qui permet aux données de rester dans la mémoire LPDDR5X sans pénalité de latence supplémentaire due au transfert. C'est la base technique qui permet d'exécuter des modèles de grande échelle localement sans dépendre du cloud.
Anatomie du superchip GB10 Grace Blackwell
Le cœur de la plateforme est le superchip GB10, qui combine un CPU Arm à 20 cœurs (architecture Grace) avec un GPU Blackwell à 6144 cœurs CUDA dans sa variante de bureau. La spécification clé est la mémoire unifiée de jusqu'à 128 Go LPDDR5X, avec une bande passante de 273 Go/s. Contrairement à la VRAM GDDR6X des GPU dédiés, qui offre des bandes passantes supérieures (souvent >1000 Go/s), la mémoire unifiée privilégie la capacité et l'efficacité énergétique sur la vitesse brute de transfert.
En termes de performance IA, NVIDIA déclare 1 petaFLOP de performance en FP4 pour la variante de bureau. Ce chiffre est atteint grâce aux Tensor Cores de cinquième génération et à l'architecture Blackwell, optimisée pour l'inférence avec précision réduite. L'efficacité énergétique est un autre pilier : le TDP de la plateforme de bureau est fixé à 140 W, une fraction de la consommation d'une configuration x86 équivalente avec un GPU haut de gamme, qui dépasse souvent 300 W sous charge maximale.
Spécifications techniques clés
| Composant | RTX Spark (Bureau) | PC Traditionnel (Référence) |
|---|---|---|
| CPU | 20 cœurs Arm (Grace) | x86 (ex. Ryzen 9 / Core i9) |
| GPU | 6144 cœurs Blackwell | GPU dédié (ex. RTX 4080) |
| Mémoire | 128 Go LPDDR5X Unifiée | 32-64 Go DDR5 + 16-24 Go VRAM |
| Bande passante | 273 Go/s | ~700-1000 Go/s (VRAM) |
| TDP | 140 W | 300-450 W (système complet) |
Avantages dans l'inférence IA locale
L'avantage principal de l'architecture unifiée se manifeste dans l'exécution de grands modèles de langage (LLM). Avec 128 Go de mémoire unifiée, RTX Spark peut charger des modèles de jusqu'à 120 milliards de paramètres en précision FP4 ou des modèles plus petits en FP16, ce qui est impossible sur un PC traditionnel avec 24 Go de VRAM. Cela permet aux développeurs et professionnels d'exécuter une inférence locale avec des contextes de jusqu'à 1 million de jetons, en maintenant la confidentialité des données et en éliminant la latence réseau associée aux API cloud.
Cependant, la bande passante de 273 Go/s est une limitation réelle pour la vitesse d'inférence (jetons par seconde). Dans les charges de travail où la vitesse de génération est critique, un GPU dédié avec une VRAM GDDR6X de bande passante supérieure peut surpasser RTX Spark en jetons par seconde, à condition que le modèle tienne dans la VRAM. La mémoire unifiée gagne en capacité et en flexibilité, mais pas nécessairement en vitesse brute de traitement pour les petits modèles qui tiennent dans la VRAM.
Créativité et rendu : le rôle de la mémoire unifiée
Pour les créateurs de contenu, la mémoire unifiée permet de gérer des scènes 3D de plus de 90 Go et d'éditer des vidéos en 12K 4:2:2 sans fragmenter les données entre la RAM et la VRAM. Adobe a restructuré Photoshop et Premiere Express pour exploiter cette architecture, promettant une performance 2 fois supérieure dans les tâches d'IA et de graphisme. Cela signifie que les flux de travail complexes, comme la composition vidéo avec plusieurs couches d'IA, peuvent s'exécuter plus fluidement en éliminant les copies de mémoire.
En rendu 3D, l'architecture Blackwell avec des cœurs de traçage de rayons de quatrième génération offre des performances compétitives. Toutefois, pour les charges de travail purement de rendu hors ligne où la vitesse est le seul facteur, un GPU dédié haut de gamme reste plus rapide en raison de sa bande passante mémoire supérieure et de son plus grand nombre de cœurs CUDA dans les modèles de pointe. RTX Spark offre un équilibre supérieur entre capacité de mémoire et performance, idéal pour des itérations rapides en temps réel.
Limitations de compatibilité et logiciel
La transition vers une architecture Arm sous Windows introduit des défis de compatibilité. Bien que plus de 100 fournisseurs de logiciels, y compris Adobe, Blender et des développeurs de jeux comme Riot Games, aient lancé des versions natives pour Arm, tout le logiciel n'est pas optimisé. Les applications x86 peuvent s'exécuter via l'émulation, mais avec une pénalité de performance qui varie selon la charge de travail. Pour les utilisateurs qui dépendent de logiciels de niche ou de pilotes spécifiques au matériel, le manque de support natif peut être un obstacle significatif.
De plus, la plateforme est moins modulaire qu'un PC traditionnel. La mémoire unifiée n'est pas extensible, et le GPU ne peut pas être remplacé par un plus puissant. Cela contraste avec l'architecture x86, où l'utilisateur peut mettre à jour la RAM, le GPU ou le stockage de manière indépendante. Adopter RTX Spark implique d'accepter un système fermé en échange d'une intégration plus profonde entre CPU, GPU et mémoire, optimisée pour les charges de travail d'IA et de créativité.
Disponibilité, prix et proposition de valeur
NVIDIA RTX Spark est disponible dans des ordinateurs portables et des bureaux d'intégrateurs comme ASUS, Dell, HP, Lenovo, Microsoft Surface et MSI, avec des modèles d'Acer et GIGABYTE à venir. Le prix d'entrée pour les bureaux se situe autour de 3 999 à 4 699 dollars, un chiffre comparable à une build traditionnelle haut de gamme. La proposition de valeur n'est pas le prix par performance brute, mais l'efficacité énergétique et la capacité de mémoire unifiée pour les charges de travail d'IA locale.
Pour un utilisateur qui a besoin d'exécuter de grands modèles d'IA localement ou de travailler avec des fichiers vidéo haute résolution, RTX Spark offre un avantage clair. Pour un joueur qui privilégie le taux de rafraîchissement maximal dans les jeux AAA ou un professionnel qui a besoin de la vitesse maximale de rendu hors ligne, une configuration x86 avec GPU dédié reste l'option la plus polyvalente et, dans de nombreux cas, plus économique à long terme en raison de la possibilité de mise à jour des composants.
Conclusion : Pour qui la transition a-t-elle du sens ?
NVIDIA RTX Spark ne cherche pas à remplacer tous les PC de bureau, mais à définir une nouvelle catégorie pour les utilisateurs qui privilégient l'IA locale et la créativité avancée. C'est le choix idéal pour les développeurs d'IA, les scientifiques des données et les créateurs de contenu qui ont besoin d'une capacité de mémoire massive et d'une efficacité énergétique. Pour le reste des utilisateurs, l'architecture séparée x86 + GPU dédié reste l'option la plus mature, polyvalente et économique, avec un écosystème logiciel plus large et la possibilité de personnalisation et de mise à jour à long terme.
La décision finale dépend du profil d'utilisation : si la charge de travail principale est l'inférence de grands modèles ou l'édition vidéo haute résolution, RTX Spark offre un avantage architectural significatif. Si la priorité est la vitesse maximale dans les jeux ou le rendu hors ligne, ou le besoin de mettre à jour les composants individuellement, le PC traditionnel reste l'option la plus pratique. L'architecture unifiée est l'avenir pour l'IA personnelle, mais ce n'est pas la solution universelle pour toutes les charges de travail de bureau.