Das Ende der CPU-GPU-Trennung am Desktop
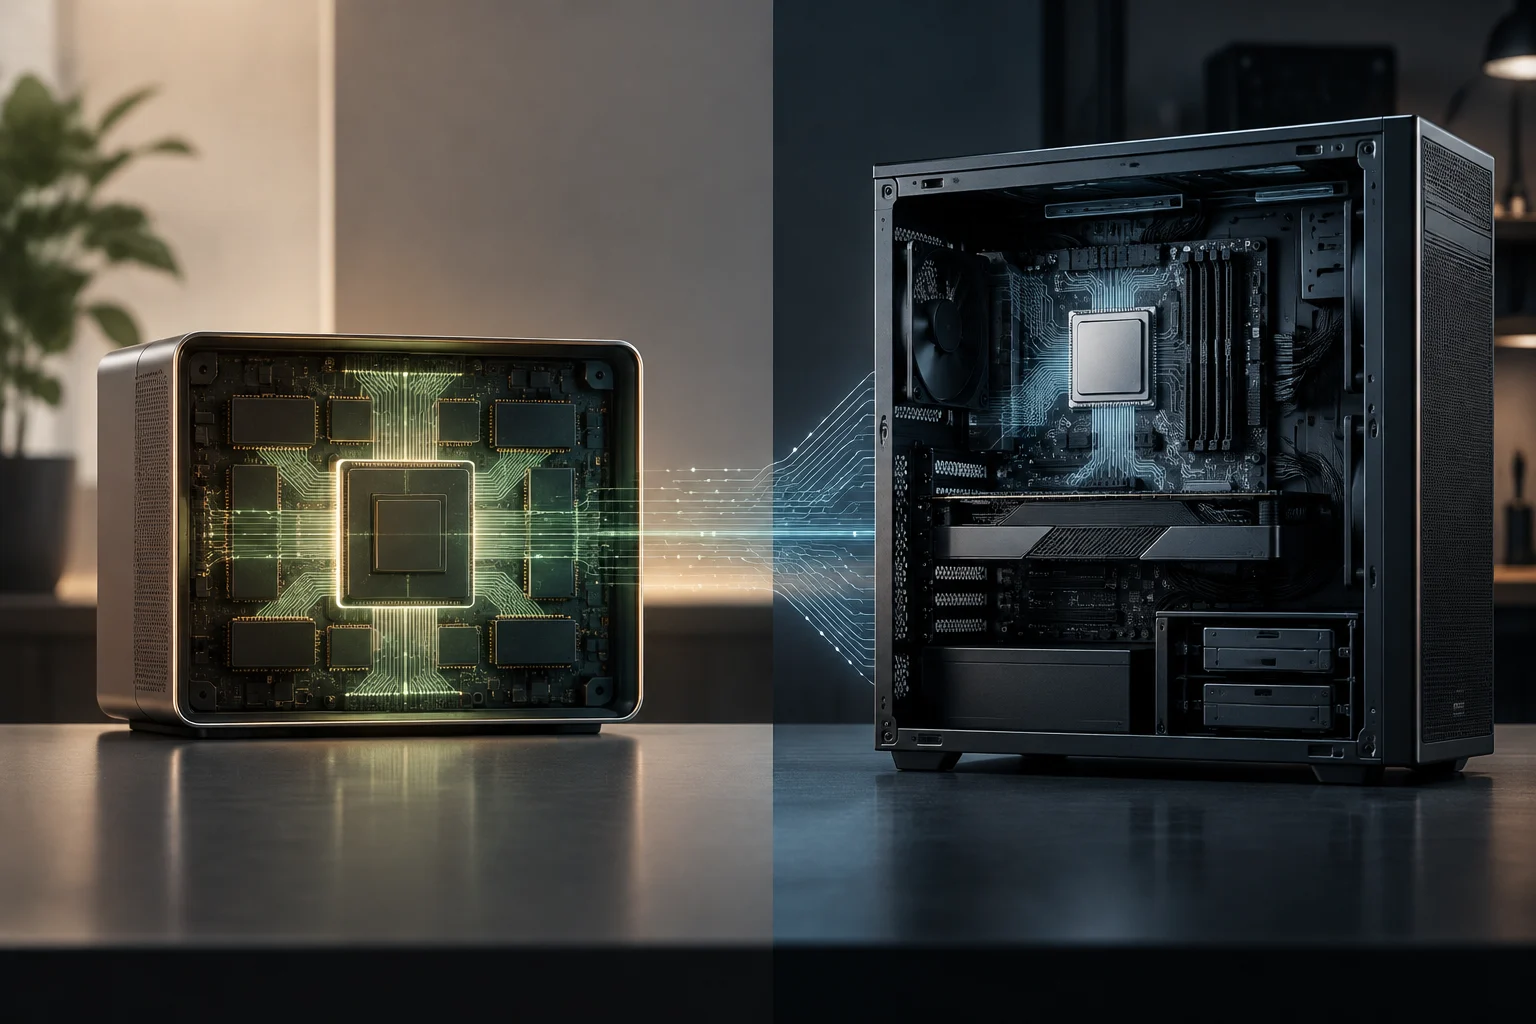
Während Jahrzehnten basierte das Design eines Desktop-PCs auf der strengen Trennung zwischen CPU und GPU, verbunden über PCI-Express-Busse. Diese Architektur erlaubte es, jede Komponente unabhängig zu skalieren, erzwang aber eine Engstelle beim Datentransfer. NVIDIA RTX Spark, im Mai 2026 angekündigt, schlägt einen radikalen Bruch vor, indem es beide Prozessoren in einem einzigen Superchip mit einheitlichem Speicher integriert und die physische Barriere zwischen allgemeiner und grafischer Berechnung eliminiert.
Diese Änderung ist nicht nur inkrementell; sie stellt eine Neudefinition des Datenflusses dar. In einem herkömmlichen System erfordert das Verschieben eines KI-Modells vom RAM in den VRAM kostspielige Kopien. In RTX Spark teilen sich die Grace-CPU und die Blackwell-GPU denselben Adressraum, was es den Daten ermöglicht, im LPDDR5X-Speicher zu verbleiben, ohne zusätzliche Latenzstrafen durch den Transfer. Dies ist die technische Grundlage, die es ermöglicht, große Modelle lokal auszuführen, ohne auf die Cloud angewiesen zu sein.
Anatomie des GB10 Grace Blackwell Superchips
Das Herzstück der Plattform ist der GB10-Superchip, der eine 20-Kern-Arm-CPU (Grace-Architektur) mit einer 6144-Kern-Blackwell-GPU in ihrer Desktop-Variante kombiniert. Die Schlüssel-Spezifikation ist der einheitliche Speicher von bis zu 128 GB LPDDR5X mit einer Bandbreite von 273 GB/s. Im Gegensatz zum GDDR6X-VRAM dedizierter GPUs, der höhere Bandbreiten bietet (oft >1000 GB/s), priorisiert der einheitliche Speicher Kapazität und Energieeffizienz gegenüber der rohen Transfergeschwindigkeit.
In Bezug auf KI-Leistung erklärt NVIDIA 1 PetaFLOP FP4-Leistung für die Desktop-Variante. Diese Zahl wird durch die Tensor Cores der fünften Generation und die Blackwell-Architektur erreicht, die für Inferenz mit reduzierter Präzision optimiert ist. Energieeffizienz ist ein weiterer Pfeiler: Das TDP der Desktop-Plattform liegt bei 140 W, ein Bruchteil des Verbrauchs einer äquivalenten x86-Konfiguration mit High-End-GPU, die unter maximaler Last oft 300 W überschreitet.
Wichtige technische Spezifikationen
| Komponente | RTX Spark (Desktop) | Herkömmlicher PC (Referenz) |
|---|---|---|
| CPU | 20 Kerne Arm (Grace) | x86 (z. B. Ryzen 9 / Core i9) |
| GPU | 6144 Kerne Blackwell | Dedizierte GPU (z. B. RTX 4080) |
| Speicher | 128 GB LPDDR5X Einheitlich | 32-64 GB DDR5 + 16-24 GB VRAM |
| Bandbreite | 273 GB/s | ~700-1000 GB/s (VRAM) |
| TDP | 140 W | 300-450 W (komplettes System) |
Vorteile bei der lokalen KI-Inferenz
Der Hauptvorteil der einheitlichen Architektur manifestiert sich in der Ausführung großer Sprachmodelle (LLM). Mit 128 GB einheitlichem Speicher kann RTX Spark Modelle mit bis zu 120 Milliarden Parametern in FP4-Präzision oder kleinere Modelle in FP16 laden, was auf einem herkömmlichen PC mit 24 GB VRAM unmöglich ist. Dies ermöglicht es Entwicklern und Fachleuten, lokale Inferenz mit Kontexten von bis zu 1 Million Tokens auszuführen, die Datensicherheit zu wahren und die Netzwerklatenz, die mit Cloud-APIs verbunden ist, zu eliminieren.
Allerdings ist die Bandbreite von 273 GB/s eine echte Einschränkung für die Inferenzgeschwindigkeit (Tokens pro Sekunde). In Workloads, in denen die Generierungsgeschwindigkeit kritisch ist, kann eine dedizierte GPU mit höherer GDDR6X-VRAM-Bandbreite RTX Spark in Tokens pro Sekunde übertreffen, vorausgesetzt, das Modell passt in den VRAM. Der einheitliche Speicher gewinnt in Kapazität und Flexibilität, aber nicht unbedingt in der rohen Verarbeitungsgeschwindigkeit für kleine Modelle, die in den VRAM passen.
Kreativität und Rendering: Die Rolle des einheitlichen Speichers
Für Content-Creator ermöglicht der einheitliche Speicher die Verarbeitung von 3D-Szenen von über 90 GB und die Bearbeitung von 12K 4:2:2-Videos, ohne die Daten zwischen RAM und VRAM zu fragmentieren. Adobe hat Photoshop und Premiere Express neu strukturiert, um diese Architektur zu nutzen, und verspricht eine 2-fach höhere Leistung bei KI- und Grafikaufgaben. Das bedeutet, dass komplexe Workflows, wie die Videocomposition mit mehreren KI-Ebenen, flüssiger ausgeführt werden können, indem Speicher-Kopien eliminiert werden.
Im 3D-Rendering bietet die Blackwell-Architektur mit Ray-Tracing-Kernen der vierten Generation konkurrenzfähige Leistung. Allerdings bleibt eine High-End-dedizierte GPU für rein offline-Rendering-Workloads, bei denen Geschwindigkeit der einzige Faktor ist, aufgrund ihrer höheren Speicherbandbreite und ihrer größeren Anzahl an CUDA-Kernen in Top-Modellen schneller. RTX Spark bietet ein überlegenes Gleichgewicht zwischen Speicherkapazität und Leistung, ideal für schnelle Echtzeit-Iterationen.
Kompatibilitäts- und Softwareeinschränkungen
Der Übergang zu einer Arm-Architektur in Windows bringt Kompatibilitäts-Herausforderungen mit sich. Obwohl mehr als 100 Softwareanbieter, einschließlich Adobe, Blender und Spieleentwickler wie Riot Games, native Versionen für Arm veröffentlicht haben, ist nicht die gesamte Software optimiert. x86-Anwendungen können über Emulation ausgeführt werden, aber mit einer Leistungsstrafe, die je nach Workload variiert. Für Benutzer, die auf Nischensoftware oder spezifische Hardware-Treiber angewiesen sind, kann der Mangel an nativer Unterstützung ein erhebliches Hindernis sein.
Darüber hinaus ist die Plattform weniger modular als ein herkömmlicher PC. Der einheitliche Speicher ist nicht erweiterbar, und die GPU kann nicht durch eine leistungsfähigere ersetzt werden. Dies steht im Gegensatz zur x86-Architektur, bei der der Benutzer RAM, GPU oder Speicher unabhängig aktualisieren kann. Die Adoption von RTX Spark bedeutet, ein geschlossenes System im Tausch gegen eine tiefere Integration zwischen CPU, GPU und Speicher zu akzeptieren, optimiert für KI- und Kreativitäts-Workloads.
Verfügbarkeit, Preis und Wertversprechen
NVIDIA RTX Spark ist in Laptops und Desktops von Integratoren wie ASUS, Dell, HP, Lenovo, Microsoft Surface und MSI verfügbar, mit Modellen von Acer und GIGABYTE folgen. Der Einstiegspreis für Desktops liegt bei etwa 3.999-4.699 US-Dollar, eine Zahl, die mit einem High-End-Herstellungs-PC vergleichbar ist. Das Wertversprechen ist nicht die rohe Leistung pro Preis, sondern die Energieeffizienz und die Kapazität des einheitlichen Speichers für lokale KI-Workloads.
Für einen Benutzer, der große KI-Modelle lokal ausführen oder mit hochauflösenden Videodateien arbeiten muss, bietet RTX Spark einen klaren Vorteil. Für einen Gamer, der die maximale Bildwiederholrate in AAA-Spielen priorisiert, oder einen Profi, der die maximale Offline-Rendering-Geschwindigkeit benötigt, bleibt eine x86-Konfiguration mit dedizierter GPU die vielseitigste und in vielen Fällen langfristig kostengünstigere Option aufgrund der Möglichkeit der Komponentenaktualisierung.
Fazit: Für wen lohnt sich der Übergang?
NVIDIA RTX Spark sucht nicht danach, alle Desktop-PCs zu ersetzen, sondern eine neue Kategorie für Benutzer zu definieren, die lokale KI und fortgeschrittene Kreativität priorisieren. Es ist die ideale Wahl für KI-Entwickler, Datenwissenschaftler und Content-Creator, die massive Speicherkapazität und Energieeffizienz benötigen. Für den Rest der Benutzer bleibt die getrennte x86 + dedizierte GPU-Architektur die reifste, vielseitigste und wirtschaftlichste Option, mit einem breiteren Software-Ökosystem und der Möglichkeit der langfristigen Anpassung und Aktualisierung.
Die endgültige Entscheidung hängt vom Nutzungsprofil ab: Wenn der Haupt-Workload die Inferenz großer Modelle oder die Bearbeitung hochauflösender Videos ist, bietet RTX Spark einen signifikanten architektonischen Vorteil. Wenn die Priorität die maximale Geschwindigkeit in Spielen oder Offline-Rendering ist oder die Notwendigkeit, Komponenten individuell zu aktualisieren, bleibt der herkömmliche PC die praktischste Option. Die einheitliche Architektur ist die Zukunft für persönliche KI, aber sie ist nicht die universelle Lösung für alle Desktop-Workloads.