O fim da separação CPU-GPU no desktop
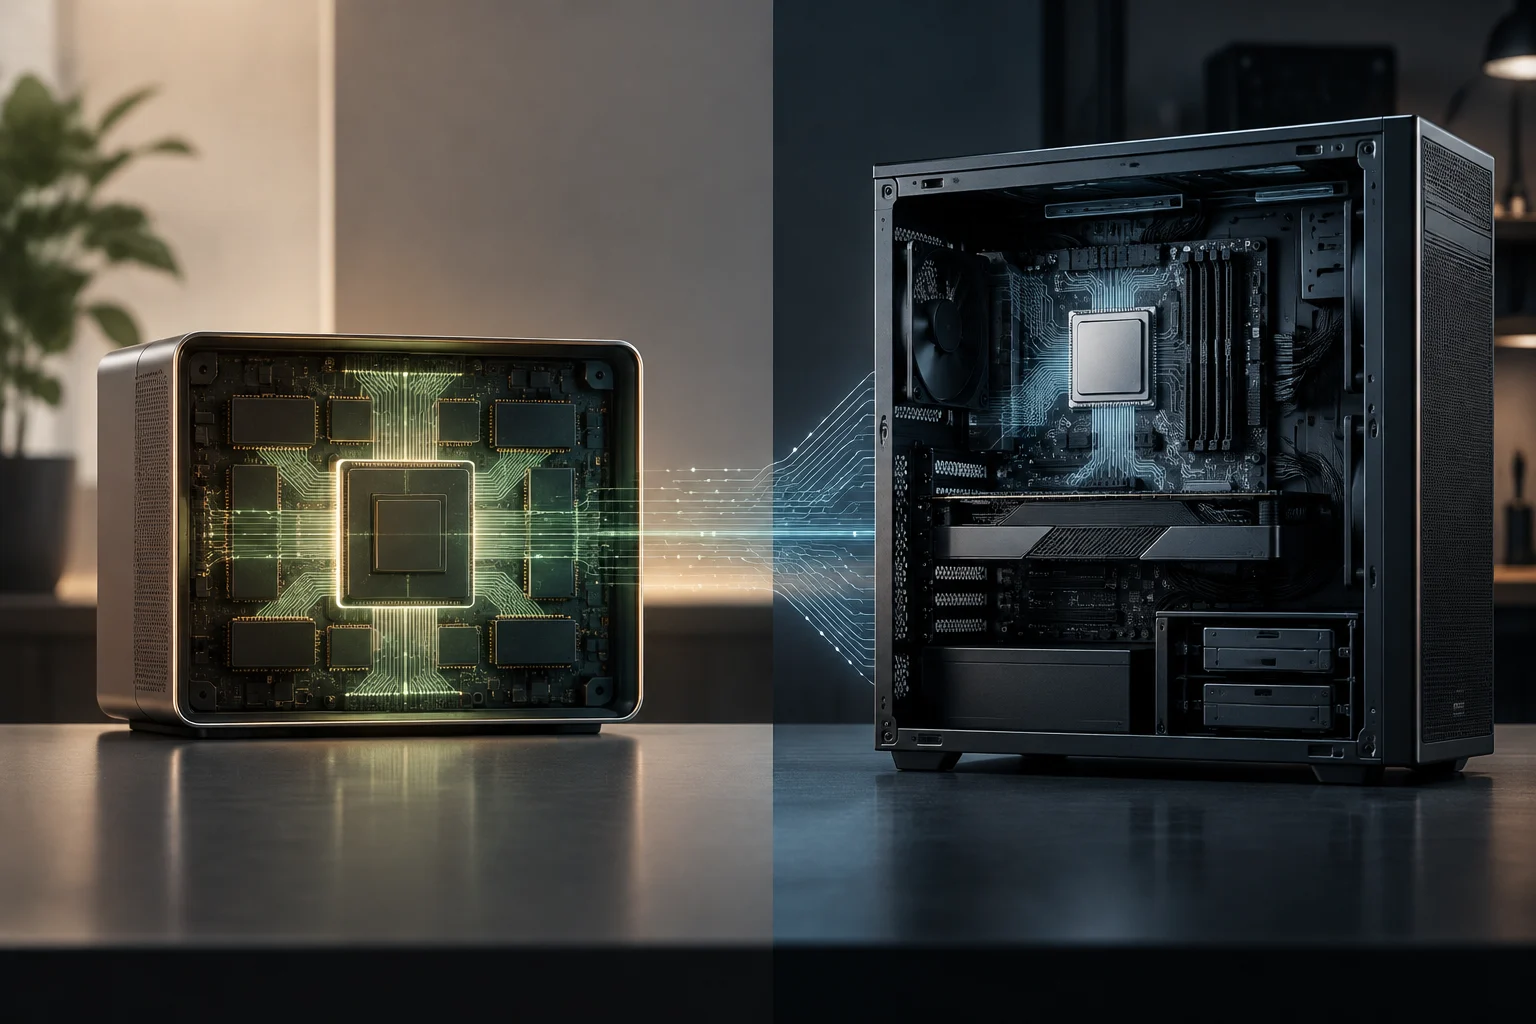
Durante décadas, o design de um PC de mesa baseou-se na separação estrita entre CPU e GPU, conectadas por barramentos PCI Express. Esta arquitetura permitia escalar cada componente de forma independente, mas impunha um gargalo na transferência de dados. A NVIDIA RTX Spark, anunciada em maio de 2026, propõe uma ruptura radical ao integrar ambos os processadores em um único superchip com memória unificada, eliminando a barreira física entre o cálculo geral e o gráfico.
Esta mudança não é meramente incremental; representa uma redefinição do fluxo de dados. Em um sistema tradicional, mover um modelo de IA da RAM para a VRAM requer cópias custosas. Na RTX Spark, a CPU Grace e a GPU Blackwell compartilham o mesmo espaço de endereçamento, o que permite que os dados permaneçam na memória LPDDR5X sem penalidade de latência adicional por transferência. Esta é a base técnica que permite executar modelos de grande escala localmente sem depender da nuvem.
Anatomia do superchip GB10 Grace Blackwell
O coração da plataforma é o superchip GB10, que combina uma CPU Arm de 20 núcleos (arquitetura Grace) com uma GPU Blackwell de 6144 núcleos CUDA em sua variante de mesa. A especificação-chave é a memória unificada de até 128 GB LPDDR5X, com uma largura de banda de 273 GB/s. Diferente da VRAM GDDR6X das GPUs dedicadas, que oferece larguras de banda superiores (frequentemente >1000 GB/s), a memória unificada prioriza a capacidade e a eficiência energética sobre a velocidade bruta de transferência.
Em termos de desempenho de IA, a NVIDIA declara 1 petaFLOP de desempenho em FP4 para a variante de mesa. Esta cifra é alcançada graças aos Tensor Cores de quinta geração e à arquitetura Blackwell, otimizada para inferência com precisão reduzida. A eficiência energética é outro pilar: o TDP da plataforma de mesa está situado em 140 W, uma fração do consumo de uma configuração x86 equivalente com GPU de gama alta, que geralmente supera os 300 W sob carga máxima.
Especificações técnicas-chave
| Componente | RTX Spark (Mesa) | PC Tradicional (Referência) |
|---|---|---|
| CPU | 20 núcleos Arm (Grace) | x86 (ex. Ryzen 9 / Core i9) |
| GPU | 6144 núcleos Blackwell | GPU dedicada (ex. RTX 4080) |
| Memória | 128 GB LPDDR5X Unificada | 32-64 GB DDR5 + 16-24 GB VRAM |
| Largura de banda | 273 GB/s | ~700-1000 GB/s (VRAM) |
| TDP | 140 W | 300-450 W (sistema completo) |
Vantagens na inferência de IA local
A principal vantagem da arquitetura unificada manifesta-se na execução de grandes modelos de linguagem (LLM). Com 128 GB de memória unificada, a RTX Spark pode carregar modelos de até 120 bilhões de parâmetros em precisão FP4 ou modelos menores em FP16, algo impossível em um PC tradicional com 24 GB de VRAM. Isso permite a desenvolvedores e profissionais executar inferência local com contextos de até 1 milhão de tokens, mantendo a privacidade dos dados e eliminando a latência de rede associada às APIs na nuvem.
No entanto, a largura de banda de 273 GB/s é uma limitação real para a velocidade de inferência (tokens por segundo). Em cargas de trabalho onde a velocidade de geração é crítica, uma GPU dedicada com VRAM GDDR6X de maior largura de banda pode superar a RTX Spark em tokens por segundo, desde que o modelo caiba na VRAM. A memória unificada ganha em capacidade e flexibilidade, mas não necessariamente em velocidade bruta de processamento para modelos pequenos que cabem na VRAM.
Criatividade e renderização: o papel da memória unificada
Para criadores de conteúdo, a memória unificada permite lidar com cenas 3D de mais de 90 GB e editar vídeo em 12K 4:2:2 sem fragmentar os dados entre RAM e VRAM. A Adobe reestruturou o Photoshop e o Premiere Express para aproveitar esta arquitetura, prometendo um desempenho 2 vezes superior em tarefas de IA e gráficos. Isso significa que fluxos de trabalho complexos, como a composição de vídeo com múltiplas camadas de IA, podem ser executados de forma mais fluida ao eliminar as cópias de memória.
Na renderização 3D, a arquitetura Blackwell com núcleos de rastreamento de raios de quarta geração oferece um desempenho competitivo. No entanto, para cargas de trabalho puramente de renderização offline onde a velocidade é o único fator, uma GPU dedicada de gama alta continua sendo mais rápida devido à sua maior largura de banda de memória e maior número de núcleos CUDA em modelos de topo de gama. A RTX Spark oferece um equilíbrio superior entre capacidade de memória e desempenho, ideal para iterações rápidas em tempo real.
Limitações de compatibilidade e software
A transição para uma arquitetura Arm no Windows introduz desafios de compatibilidade. Embora mais de 100 fornecedores de software, incluindo Adobe, Blender e desenvolvedores de jogos como Riot Games, tenham lançado versões nativas para Arm, nem todo o software está otimizado. Os aplicativos x86 podem ser executados por meio de emulação, mas com uma penalidade de desempenho que varia conforme a carga de trabalho. Para usuários que dependem de software de nicho ou drivers específicos de hardware, a falta de suporte nativo pode ser um obstáculo significativo.
Além disso, a plataforma é menos modular que um PC tradicional. A memória unificada não é expansível, e a GPU não pode ser substituída por uma mais potente. Isso contrasta com a arquitetura x86, onde o usuário pode atualizar a RAM, a GPU ou o armazenamento de forma independente. A decisão de adotar a RTX Spark implica aceitar um sistema fechado em troca de uma integração mais profunda entre CPU, GPU e memória, otimizada para cargas de trabalho de IA e criatividade.
Disponibilidade, preço e proposta de valor
A NVIDIA RTX Spark está disponível em notebooks e desktops de integradores como ASUS, Dell, HP, Lenovo, Microsoft Surface e MSI, com modelos da Acer e GIGABYTE previstos. O preço de entrada para os desktops situa-se em torno de 3.999-4.699 dólares, uma cifra comparável a uma build tradicional de gama alta. A proposta de valor não é o preço por desempenho bruto, mas a eficiência energética e a capacidade de memória unificada para cargas de trabalho de IA local.
Para um usuário que precisa executar modelos de IA grandes localmente ou trabalhar com arquivos de vídeo de alta resolução, a RTX Spark oferece uma vantagem clara. Para um jogador que prioriza a máxima taxa de atualização em jogos AAA ou um profissional que precisa da máxima velocidade de renderização offline, uma configuração x86 com GPU dedicada continua sendo a opção mais versátil e, em muitos casos, mais econômica a longo prazo devido à possibilidade de atualização de componentes.
Conclusão: Para quem faz sentido a transição?
A NVIDIA RTX Spark não busca substituir todos os PCs de mesa, mas definir uma nova categoria para usuários que priorizam a IA local e a criatividade avançada. É a escolha ideal para desenvolvedores de IA, cientistas de dados e criadores de conteúdo que precisam de capacidade de memória massiva e eficiência energética. Para o restante dos usuários, a arquitetura separada x86 + GPU dedicada continua sendo a opção mais madura, versátil e econômica, com um ecossistema de software mais amplo e a possibilidade de personalização e atualização a longo prazo.
A decisão final depende do perfil de uso: se a carga de trabalho principal é a inferência de modelos grandes ou a edição de vídeo de alta resolução, a RTX Spark oferece uma vantagem arquitetural significativa. Se a prioridade é a máxima velocidade em jogos ou renderização offline, ou a necessidade de atualizar componentes individualmente, o PC tradicional continua sendo a opção mais prática. A arquitetura unificada é o futuro para a IA pessoal, mas não é a solução universal para todas as cargas de trabalho de desktop.