Do conceito de IA local a tarefas concretas
O termo IA local agrupa tarefas muito distintas que exigem recursos díspares. A inferência (gerar texto ou imagens a partir de um modelo pré-treinado) é a mais comum para usuários domésticos, enquanto o fine-tuning ou o treinamento requerem ordens de grandeza superiores em memória e poder de cálculo. Confundir essas categorias leva a superdimensionar o hardware necessário para um uso básico, pois os processos de aprendizado envolvem gradientes e estados adicionais que não estão presentes na simples geração de saída.
Para um usuário que deseja testar modelos abertos como Llama ou Mistral, o objetivo geralmente é a inferência com latências aceitáveis. Isso implica carregar os pesos do modelo na memória da GPU e gerenciar o KV cache (memória de contexto). A documentação de projetos como Hugging Face indica que a otimização da memória é a chave para que esses modelos funcionem em hardware de consumo, não apenas em centros de dados, onde a escalabilidade é a prioridade principal.
Memória da GPU: o principal gargalo
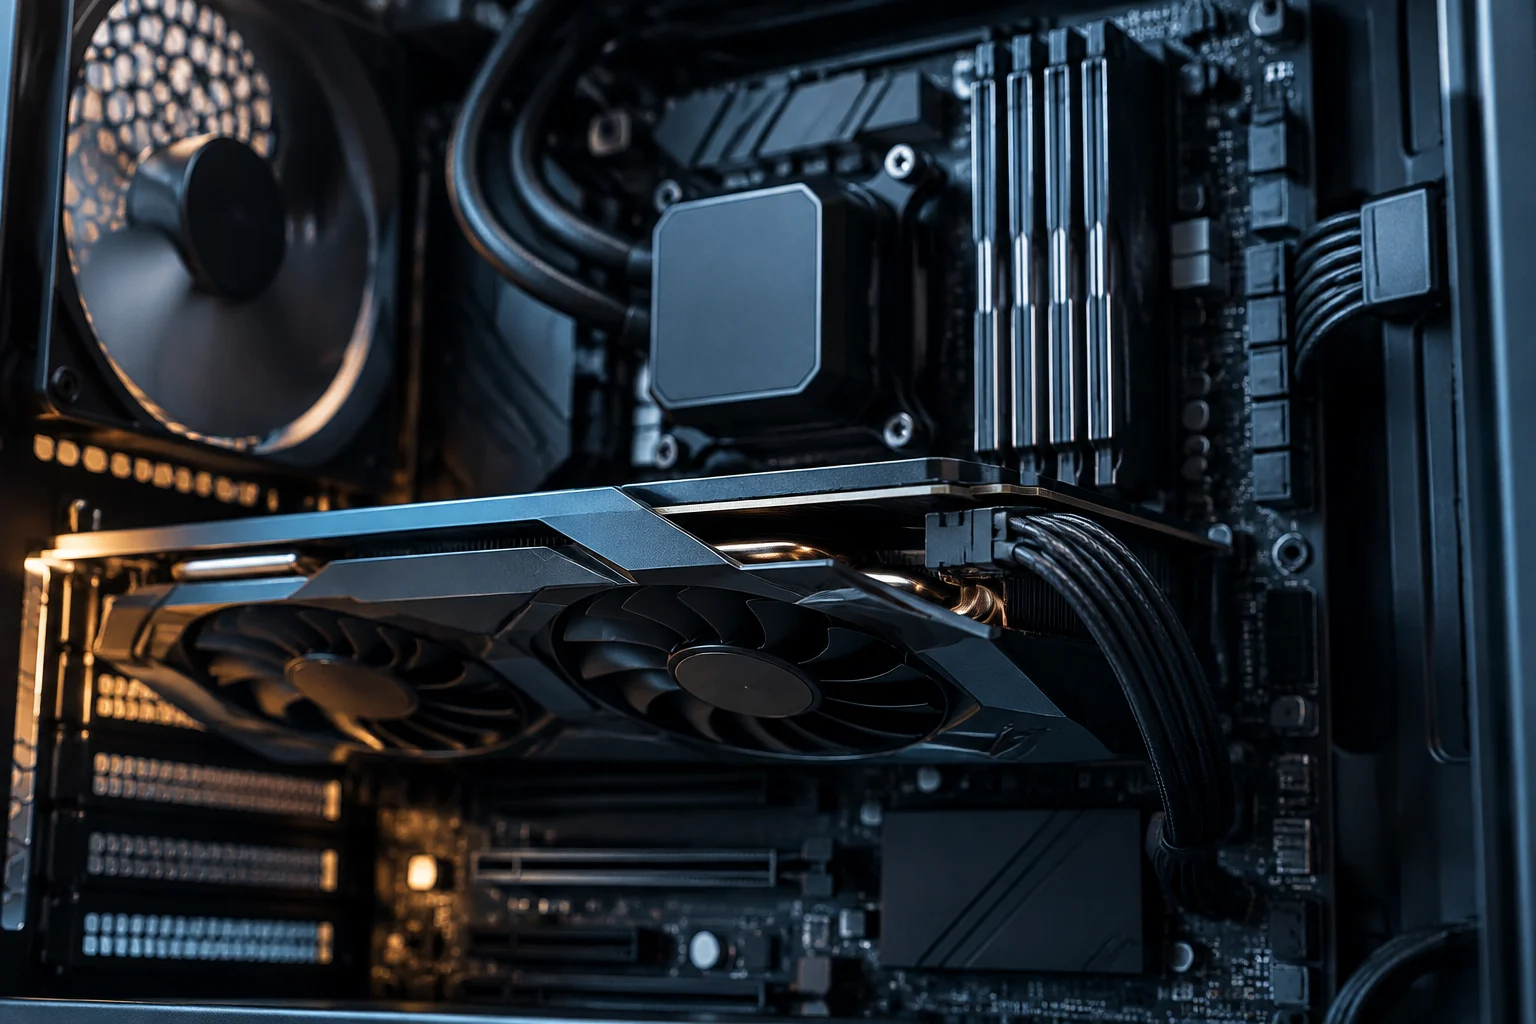
A quantidade de memória de vídeo (VRAM) determina o tamanho máximo do modelo que pode ser carregado completamente na GPU. Se a VRAM for insuficiente, o sistema deve offload (descarregar) partes do modelo para a RAM do sistema ou para o disco, o que reduz drasticamente a velocidade de geração devido à menor largura de banda da memória principal. Ferramentas como o VRAM Calculator da ApXML permitem estimar a memória necessária com base na precisão dos pesos (FP16, INT8, etc.) e no comprimento do contexto, oferecendo uma projeção realista antes da compra.
Por exemplo, um modelo de 7 bilhões de parâmetros em precisão FP16 requer aproximadamente 14 GB de VRAM apenas para os pesos, sem contar a memória de contexto. Ao aplicar a quantização INT8, esse requisito é reduzido para cerca de 7-8 GB, permitindo sua execução em placas de gama média. Essa distinção é vital: as especificações de marketing costumam citar o número de parâmetros, mas não a precisão de execução, o que gera expectativas irreais sobre o hardware necessário para tempos de resposta fluidos.
Compatibilidade de software e arquitetura CUDA
Nem toda GPU é compatível com as bibliotecas de IA modernas. A plataforma NVIDIA CUDA é o padrão de fato para o desenvolvimento de IA em PC, e seu suporte depende da Compute Capability (CC) da placa. As GPUs mais antigas (CC < 7.0) têm suporte limitado ou nulo para as instruções de precisão reduzida (FP8, INT4) que otimizam a inferência atual. A NVIDIA mantém uma lista de GPUs legacy que não recebem mais atualizações da ferramenta CUDA, tornando-as obsoletas para cargas de trabalho de IA novas que dependem dessas otimizações específicas.
Além do hardware, o NVIDIA Driver atua como sistema operacional da GPU e deve estar atualizado para suportar as últimas versões do CUDA Toolkit. Sem essa camada de software, bibliotecas como PyTorch ou TensorFlow não podem aproveitar a aceleração por hardware de forma eficiente. Para os usuários, isso significa que uma GPU potente, mas antiga, pode ser menos útil para IA do que uma GPU mais recente com suporte completo para as instruções de baixa precisão, pois a compatibilidade de software é tão crítica quanto a potência bruta.
Memória do sistema e armazenamento
Embora a GPU seja o componente crítico, a memória RAM do sistema e o armazenamento NVMe desempenham um papel de suporte fundamental. A RAM deve ser suficiente para carregar o modelo se o offloading for usado ou para gerenciar os dados de entrada/saída. Um sistema com 16 GB de RAM pode ficar curto se forem executados modelos grandes com contextos longos, mesmo que a GPU tenha VRAM suficiente, pois o sistema operacional e outros aplicativos competem por esse recurso. O armazenamento rápido é essencial para carregar os pesos do modelo (que podem exceder 10 GB) em tempos razoáveis, evitando gargalos durante a inicialização.
Em configurações de desktop, a memória unificada (como a dos chips Apple Silicon ou dos novos superchips NVIDIA Grace Blackwell) oferece uma vantagem ao eliminar a barreira entre RAM e VRAM. No entanto, na maioria dos PCs de desktop tradicionais, a separação entre memória do sistema e memória da GPU continua sendo a norma, o que exige um planejamento cuidadoso da capacidade de ambos os componentes para garantir que o fluxo de dados não seja interrompido por limitações de transferência.
O que um usuário pode verificar antes de comprar
Antes de investir em hardware para IA local, o usuário deve verificar três pontos: 1) A VRAM disponível e sua compatibilidade com a precisão de quantização desejada. 2) A Compute Capability da GPU para garantir suporte CUDA atualizado. 3) A capacidade de RAM e armazenamento para gerenciar o offloading e o carregamento de modelos. Ferramentas de linha de comando como nvidia-smi permitem verificar a VRAM e a temperatura, enquanto a documentação oficial da NVIDIA lista as CC suportadas, fornecendo uma base técnica sólida para a avaliação.
É importante não extrapolar especificações de marketing para desempenho real. Uma placa que anuncia 'suporte para IA' não garante que possa executar modelos de 70B parâmetros a velocidades úteis. A latência de inferência (tokens por segundo) depende da largura de banda de memória da GPU, não apenas de seu poder de cálculo. Para uso doméstico, uma GPU com 12-16 GB de VRAM e boa largura de banda é mais prática do que uma com 24 GB, mas com arquitetura antiga, pois a velocidade de transferência de dados impacta diretamente a experiência do usuário.
Contraste de afirmações e limites da extrapolação
As afirmações de marketing de 'PC para IA' geralmente se referem à capacidade de executar modelos pequenos ou de usar funções de IA integradas no sistema operacional, não à capacidade de treinar ou executar modelos de fronteira. O Dell Pro Max com NVIDIA GB10, por exemplo, anuncia compatibilidade com modelos de até 200 bilhões de parâmetros, mas isso se refere à capacidade teórica da memória unificada, não à velocidade de inferência prática para um usuário final que busca interação em tempo real.
As evidências disponíveis mostram que a barreira de entrada para a IA local diminuiu, mas continua sendo significativa. Os usuários devem distinguir entre capacidade (poder carregar o modelo) e desempenho (gerar texto a uma velocidade útil). Sem documentação primária de benchmarks independentes, é prudente tratar as especificações dos fabricantes como limites superiores, não como promessas de experiência do usuário, mantendo uma perspectiva crítica em relação às cifras publicitárias.