Del concepto de IA local a tareas concretas
El término IA local agrupa tareas muy distintas que exigen recursos dispares. La inferencia (generar texto o imágenes a partir de un modelo preentrenado) es la más común para usuarios domésticos, mientras que el ajuste fino o el entrenamiento requieren órdenes de magnitud superiores en memoria y potencia de cálculo. Confundir estas categorías lleva a sobredimensionar el hardware necesario para un uso básico, ya que los procesos de aprendizaje implican gradientes y estados adicionales que no están presentes en la simple generación de salida.
Para un usuario que desea probar modelos abiertos como Llama o Mistral, el objetivo suele ser la inferencia con latencias aceptables. Esto implica cargar los pesos del modelo en la memoria de la GPU y gestionar la KV cache (memoria de contexto). La documentación de proyectos como Hugging Face indica que la optimización de la memoria es clave para que estos modelos funcionen en hardware de consumo, no solo en centros de datos, donde la escalabilidad es la prioridad principal.
Memoria de GPU: el cuello de botella principal
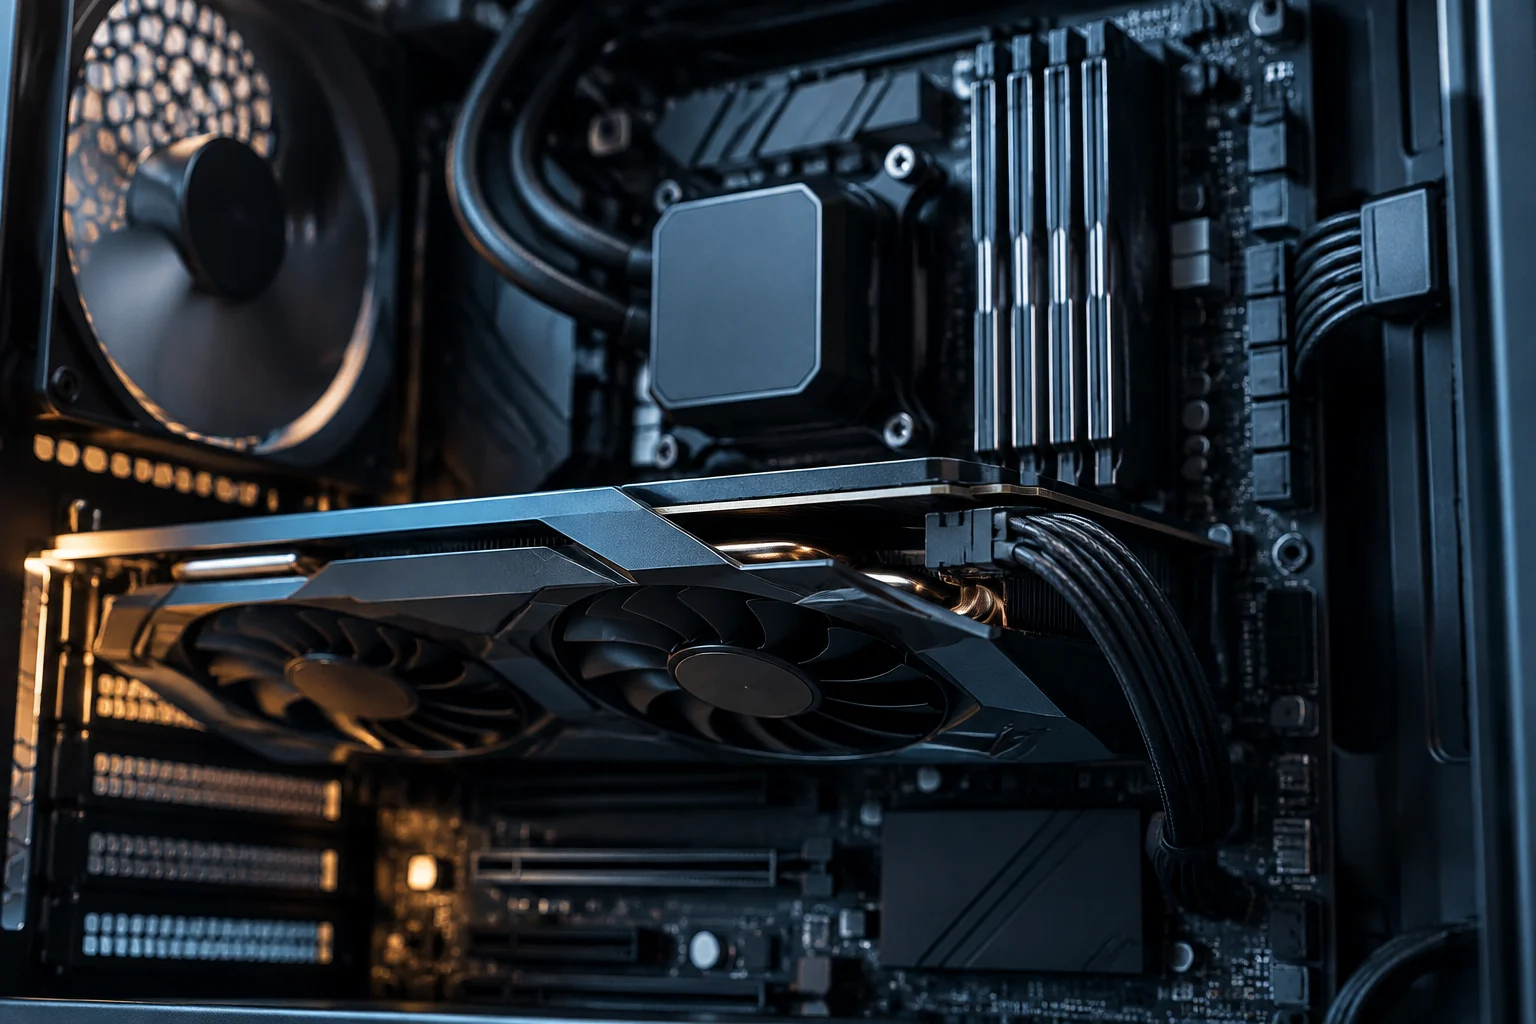
La cantidad de memoria de video (VRAM) determina el tamaño máximo del modelo que puede cargarse por completo en la GPU. Si la VRAM es insuficiente, el sistema debe offload (descargar) partes del modelo a la RAM del sistema o al disco, lo que reduce drásticamente la velocidad de generación debido a la menor ancho de banda de la memoria principal. Herramientas como el VRAM Calculator de ApXML permiten estimar la memoria necesaria según la precisión de los pesos (FP16, INT8, etc.) y la longitud de contexto, ofreciendo una proyección realista antes de la compra.
Por ejemplo, un modelo de 7 mil millones de parámetros en precisión FP16 requiere aproximadamente 14 GB de VRAM solo para los pesos, sin contar la memoria de contexto. Al aplicar cuantización INT8, este requisito se reduce a unos 7-8 GB, permitiendo su ejecución en tarjetas de gama media. Esta distinción es vital: las especificaciones de marketing suelen citar el número de parámetros, pero no la precisión de ejecución, lo que genera expectativas irreales sobre el hardware necesario para lograr tiempos de respuesta fluidos.
Compatibilidad de software y arquitectura CUDA
No toda GPU es compatible con las bibliotecas de IA modernas. La plataforma NVIDIA CUDA es el estándar de facto para el desarrollo de IA en PC, y su soporte depende de la Compute Capability (CC) de la tarjeta. Las GPUs más antiguas (CC < 7.0) tienen soporte limitado o nulo para las instrucciones de precisión reducida (FP8, INT4) que optimizan la inferencia actual. NVIDIA mantiene una lista de GPUs legacy que ya no reciben actualizaciones de la herramienta CUDA, lo que las hace obsoletas para cargas de trabajo de IA nuevas que dependen de estas optimizaciones específicas.
Además del hardware, el NVIDIA Driver actúa como sistema operativo de la GPU y debe estar actualizado para soportar las últimas versiones del CUDA Toolkit. Sin esta capa de software, las bibliotecas como PyTorch o TensorFlow no pueden aprovechar la aceleración por hardware de forma eficiente. Para los usuarios, esto significa que una GPU potente pero antigua puede ser menos útil para IA que una GPU más reciente con soporte completo para las instrucciones de baja precisión, ya que la compatibilidad de software es tan crítica como la potencia bruta.
Memoria del sistema y almacenamiento
Aunque la GPU es el componente crítico, la memoria RAM del sistema y el almacenamiento NVMe juegan un papel de soporte fundamental. La RAM debe ser suficiente para cargar el modelo si se usa offloading o para gestionar los datos de entrada/salida. Un sistema con 16 GB de RAM puede quedarse corto si se ejecutan modelos grandes con contextos largos, incluso si la GPU tiene VRAM suficiente, ya que el sistema operativo y otras aplicaciones compiten por este recurso. El almacenamiento rápido es esencial para cargar los pesos del modelo (que pueden superar los 10 GB) en tiempos razonables, evitando cuellos de botella durante la inicialización.
En configuraciones de sobremesa, la memoria unificada (como la de los chips Apple Silicon o los nuevos superchips NVIDIA Grace Blackwell) ofrece una ventaja al eliminar la barrera entre RAM y VRAM. Sin embargo, en la mayoría de PCs de sobremesa tradicionales, la separación entre memoria de sistema y memoria de GPU sigue siendo la norma, lo que exige una planificación cuidadosa de la capacidad de ambos componentes para garantizar que el flujo de datos no se vea interrumpido por limitaciones de transferencia.
Qué puede comprobar un usuario antes de comprar
Antes de invertir en hardware para IA local, el usuario debe verificar tres puntos: 1) La VRAM disponible y su compatibilidad con la precisión de cuantización deseada. 2) La Compute Capability de la GPU para asegurar soporte CUDA actualizado. 3) La capacidad de RAM y almacenamiento para gestionar el offloading y la carga de modelos. Herramientas de línea de comandos como nvidia-smi permiten comprobar la VRAM y la temperatura, mientras que la documentación oficial de NVIDIA lista las CC soportadas, proporcionando una base técnica sólida para la evaluación.
Es importante no extrapolar especificaciones de marketing a rendimiento real. Una tarjeta que anuncia 'soporte para IA' no garantiza que pueda ejecutar modelos de 70B parámetros a velocidades útiles. La latencia de inferencia (tokens por segundo) depende de la ancho de banda de memoria de la GPU, no solo de su potencia de cálculo. Para uso doméstico, una GPU con 12-16 GB de VRAM y buen ancho de banda es más práctica que una con 24 GB pero arquitectura antigua, ya que la velocidad de transferencia de datos impacta directamente en la experiencia de usuario.
Contraste de afirmaciones y límites de la extrapolación
Las afirmaciones de 'PC para IA' en el marketing suelen referirse a la capacidad de ejecutar modelos pequeños o de usar funciones de IA integradas en el sistema operativo, no a la capacidad de entrenar o ejecutar modelos de frontera. La Dell Pro Max con NVIDIA GB10, por ejemplo, anuncia compatibilidad con modelos de hasta 200 mil millones de parámetros, pero esto se refiere a la capacidad teórica de la memoria unificada, no a la velocidad de inferencia práctica para un usuario final que busca interacción en tiempo real.
La evidencia disponible muestra que la barrera de entrada para la IA local ha bajado, pero sigue siendo significativa. Los usuarios deben distinguir entre capacidad (poder cargar el modelo) y rendimiento (generar texto a una velocidad útil). Sin documentación primaria de benchmarks independientes, es prudente tratar las especificaciones de los fabricantes como límites superiores, no como promesas de experiencia de usuario, manteniendo una perspectiva crítica ante las cifras publicitarias.