Dal concetto di IA locale a compiti concreti
Il termine IA locale raggruppa compiti molto diversi che richiedono risorse disuguali. L'inferenza (generare testo o immagini da un modello pre-addestrato) è la più comune per gli utenti domestici, mentre il fine-tuning o l'addestramento richiedono ordini di grandezza superiori in memoria e potenza di calcolo. Confondere queste categorie porta a sovradimensionare l'hardware necessario per un uso di base, poiché i processi di apprendimento implicano gradienti e stati aggiuntivi non presenti nella semplice generazione di output.
Per un utente che desidera provare modelli aperti come Llama o Mistral, l'obiettivo è solitamente l'inferenza con latenze accettabili. Questo implica caricare i pesi del modello nella memoria GPU e gestire la KV cache (memoria di contesto). La documentazione di progetti come Hugging Face indica che l'ottimizzazione della memoria è chiave affinché questi modelli funzionino su hardware consumer, non solo nei data center, dove la scalabilità è la priorità principale.
Memoria GPU: il collo di bottiglia principale
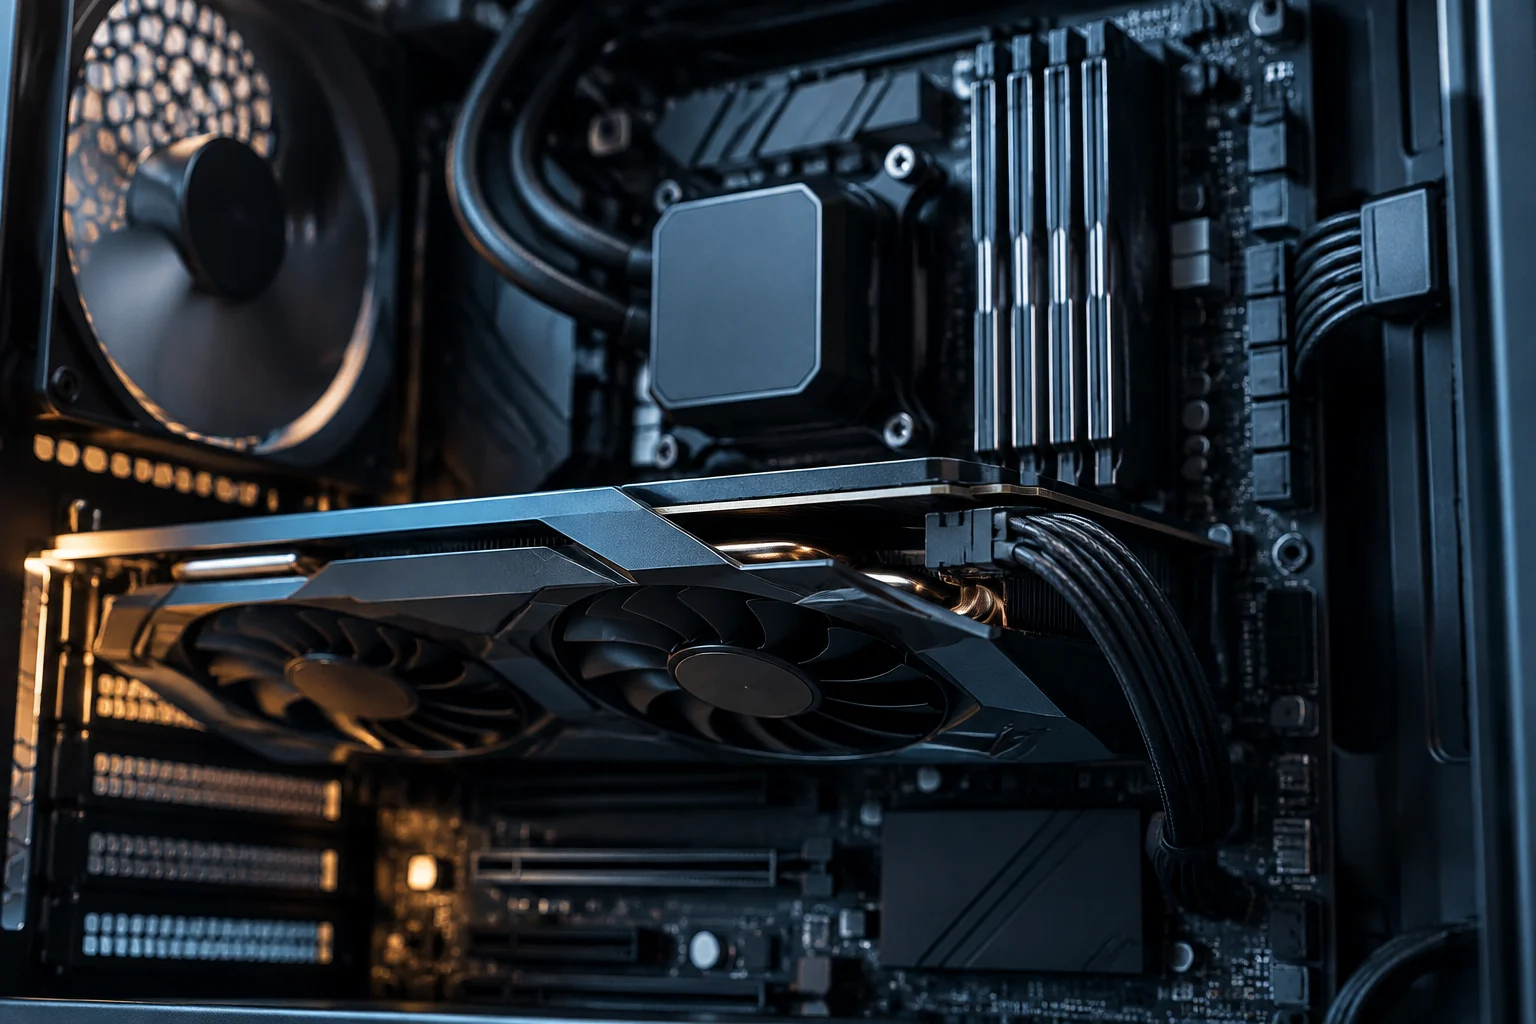
La quantità di memoria video (VRAM) determina la dimensione massima del modello che può essere caricato completamente nella GPU. Se la VRAM è insufficiente, il sistema deve offload (scaricare) parti del modello nella RAM di sistema o su disco, riducendo drasticamente la velocità di generazione a causa della minore banda passante della memoria principale. Strumenti come il VRAM Calculator di ApXML permettono di stimare la memoria necessaria in base alla precisione dei pesi (FP16, INT8, ecc.) e alla lunghezza del contesto, offrendo una proiezione realistica prima dell'acquisto.
Ad esempio, un modello di 7 miliardi di parametri in precisione FP16 richiede circa 14 GB di VRAM solo per i pesi, senza contare la memoria di contesto. Applicando la quantizzazione INT8, questo requisito si riduce a circa 7-8 GB, permettendone l'esecuzione su schede di fascia media. Questa distinzione è vitale: le specifiche di marketing citano spesso il numero di parametri, ma non la precisione di esecuzione, generando aspettative irrealistiche sull'hardware necessario per tempi di risposta fluidi.
Compatibilità software e architettura CUDA
Non tutte le GPU sono compatibili con le librerie di IA moderne. La piattaforma NVIDIA CUDA è lo standard de facto per lo sviluppo di IA su PC, e il suo supporto dipende dalla Compute Capability (CC) della scheda. Le GPU più vecchie (CC < 7.0) hanno supporto limitato o nullo per le istruzioni a precisione ridotta (FP8, INT4) che ottimizzano l'inferenza attuale. NVIDIA mantiene un elenco di GPU legacy che non ricevono più aggiornamenti del toolkit CUDA, rendendole obsolete per nuovi carichi di lavoro di IA che dipendono da queste ottimizzazioni specifiche.
Oltre all'hardware, il NVIDIA Driver agisce come sistema operativo della GPU e deve essere aggiornato per supportare le ultime versioni del CUDA Toolkit. Senza questo layer software, librerie come PyTorch o TensorFlow non possono sfruttare in modo efficiente l'accelerazione hardware. Per gli utenti, questo significa che una GPU potente ma vecchia può essere meno utile per l'IA di una GPU più recente con supporto completo per le istruzioni a bassa precisione, poiché la compatibilità software è critica quanto la potenza bruta.
Memoria di sistema e archiviazione
Sebbene la GPU sia il componente critico, la memoria RAM di sistema e l'archiviazione NVMe svolgono un ruolo di supporto fondamentale. La RAM deve essere sufficiente per caricare il modello se si usa l'offloading o per gestire i dati di input/output. Un sistema con 16 GB di RAM può risultare corto se si eseguono modelli grandi con contesti lunghi, anche se la GPU ha VRAM sufficiente, poiché il sistema operativo e altre applicazioni competono per questa risorsa. L'archiviazione veloce è essenziale per caricare i pesi del modello (che possono superare i 10 GB) in tempi ragionevoli, evitando colli di bottiglia durante l'inizializzazione.
Nelle configurazioni desktop, la memoria unificata (come quella dei chip Apple Silicon o dei nuovi superchip NVIDIA Grace Blackwell) offre un vantaggio eliminando la barriera tra RAM e VRAM. Tuttavia, nella maggior parte dei PC desktop tradizionali, la separazione tra memoria di sistema e memoria GPU rimane la norma, richiedendo una pianificazione accurata della capacità di entrambi i componenti per garantire che il flusso di dati non venga interrotto da limitazioni di trasferimento.
Cosa può verificare un utente prima di acquistare
Prima di investire in hardware per l'IA locale, l'utente deve verificare tre punti: 1) La VRAM disponibile e la sua compatibilità con la precisione di quantizzazione desiderata. 2) La Compute Capability della GPU per assicurare supporto CUDA aggiornato. 3) La capacità di RAM e archiviazione per gestire l'offloading e il caricamento dei modelli. Strumenti da riga di comando come nvidia-smi permettono di verificare la VRAM e la temperatura, mentre la documentazione ufficiale di NVIDIA elenca le CC supportate, fornendo una base tecnica solida per la valutazione.
È importante non estrapolare specifiche di marketing a prestazioni reali. Una scheda che annuncia 'supporto per l'IA' non garantisce che possa eseguire modelli di 70B parametri a velocità utili. La latenza di inferenza (token al secondo) dipende dalla banda passante della memoria della GPU, non solo dalla sua potenza di calcolo. Per uso domestico, una GPU con 12-16 GB di VRAM e buona banda passante è più pratica di una con 24 GB ma architettura vecchia, poiché la velocità di trasferimento dati impatta direttamente l'esperienza utente.
Contrasto delle affermazioni e limiti dell'estrapolazione
Le affermazioni di marketing di 'PC per l'IA' si riferiscono solitamente alla capacità di eseguire modelli piccoli o di usare funzioni di IA integrate nel sistema operativo, non alla capacità di addestrare o eseguire modelli di frontiera. Il Dell Pro Max con NVIDIA GB10, ad esempio, annuncia compatibilità con modelli fino a 200 miliardi di parametri, ma questo si riferisce alla capacità teorica della memoria unificata, non alla velocità di inferenza pratica per un utente finale che cerca interazione in tempo reale.
Le prove disponibili mostrano che la barriera d'ingresso per l'IA locale è scesa, ma rimane significativa. Gli utenti devono distinguere tra capacità (poter caricare il modello) e prestazione (generare testo a una velocità utile). Senza documentazione primaria di benchmark indipendenti, è prudente trattare le specifiche dei produttori come limiti superiori, non come promesse di esperienza utente, mantenendo una prospettiva critica sulle cifre pubblicitarie.