Il confine critico: privacy locale vs cloud
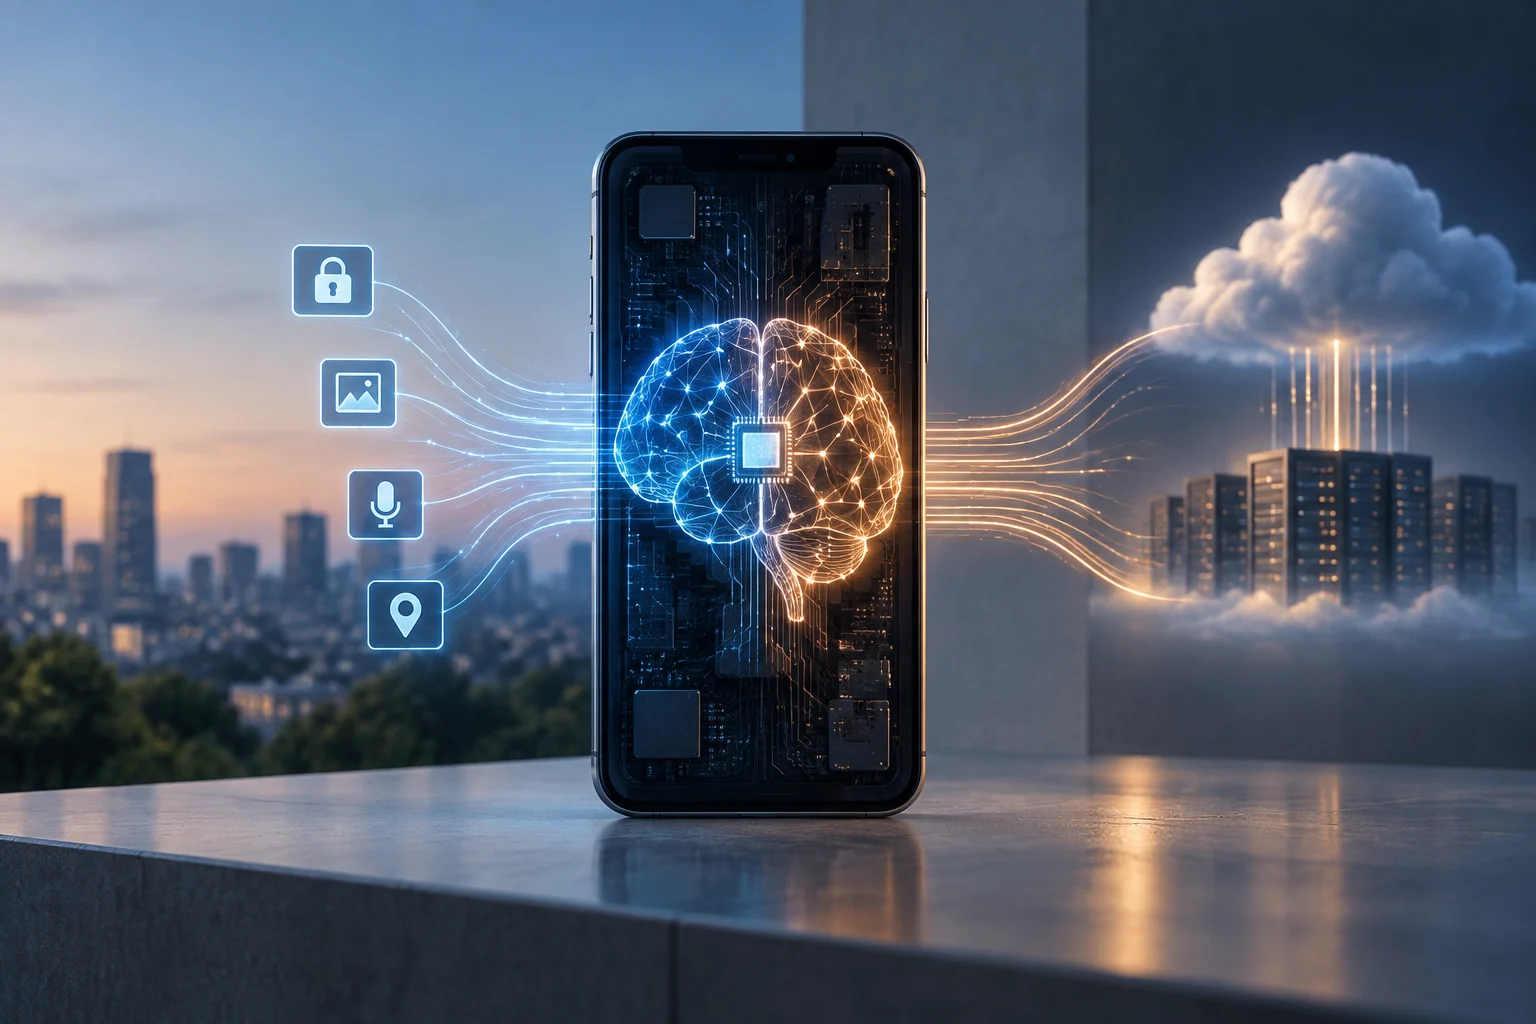
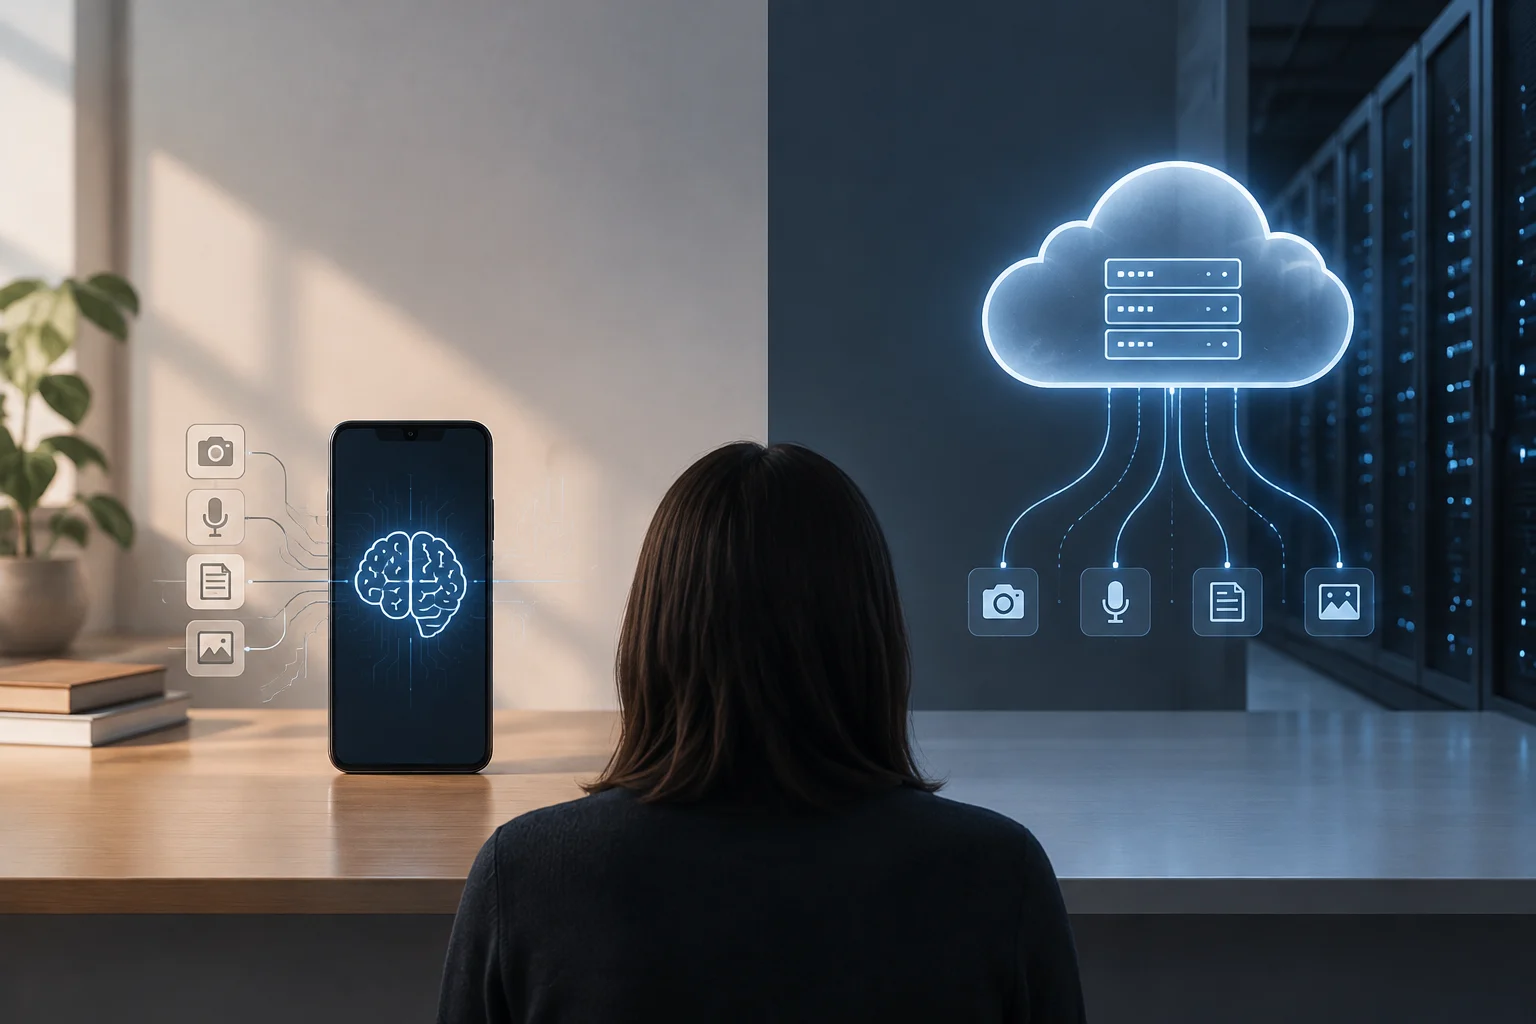
La distinzione fondamentale tra un'applicazione di IA locale e una basata sul cloud risiede in dove viene eseguito il modello. Nell'elaborazione locale, l'inferenza avviene all'interno del tuo hardware, il che significa che i dati non lasciano il dispositivo. Al contrario, le soluzioni cloud inviano ogni query a server remoti, dove viene elaborata e restituita la risposta.
Questa differenza non è solo tecnica, ma riguarda la sovranità dei dati. Secondo fonti specializzate, l'IA locale consente di mantenere le informazioni sensibili all'interno della macchina, riducendo l'esposizione a terzi. Tuttavia, è cruciale capire che "locale" non significa sempre "offline": funzioni come sincronizzazione, fatturazione o aggiornamenti possono richiedere la rete anche nelle app locali.
Per l'utente medio, questa distinzione determina il livello di rischio. Se gestisci dati aziendali, medici o finanziari, la verifica del modello di elaborazione è un passaggio di sicurezza obbligatorio prima di adottare qualsiasi strumento di IA generativa.
Passo 1: Auditare la documentazione ufficiale dell'applicazione
Il primo passo per verificare l'origine dell'elaborazione è consultare la documentazione tecnica ufficiale dello sviluppatore. Cerca sezioni specifiche su "architettura", "requisiti di sistema" o "privacy dei dati". Le app che eseguono modelli localmente specificano di solito la dimensione dei modelli scaricabili e i requisiti di VRAM o RAM.
Nel caso di strumenti come Ollama, LM Studio o PocketPal AI, la documentazione indica chiaramente che i modelli vengono scaricati ed eseguiti sul dispositivo. Al contrario, applicazioni come ChatGPT o Gemini specificano che l'elaborazione avviene nell'infrastruttura cloud del provider, utilizzando servizi come Microsoft Azure o Google Cloud.
Un indicatore chiave è la presenza di modelli open source (come Llama, Qwen o Gemma) nell'elenco di compatibilità. Se l'app consente di caricare pesi di modelli locali, è molto probabile che offra un'opzione di inferenza locale, sebbene spesso coesista con un'opzione cloud per modelli più potenti.
Passo 2: Analizzare i permessi di rete e archiviazione
I permessi richiesti dall'applicazione sul tuo sistema operativo sono un indizio tecnico diretto. Un'app di IA puramente locale ha bisogno di permessi di archiviazione massiva per salvare i pesi del modello (che possono occupare diversi gigabyte) e di accesso alla GPU o NPU per l'inferenza.
Per quanto riguarda la rete, un'app locale idealmente dovrebbe richiedere una connessione solo per il download iniziale del modello e gli aggiornamenti. Se l'applicazione richiede permessi di rete costanti e non consente la modalità offline, è probabile che stia inviando dati al cloud. Puoi usare strumenti di monitoraggio di rete per vedere se c'è traffico in uscita costante durante l'inferenza.
È importante distinguere tra telemetria ed elaborazione dei dati. Molte app locali inviano metriche di prestazioni o errori ai loro server, ma non il contenuto dei tuoi prompt. La documentazione sulla privacy deve chiarire esplicitamente quali dati vengono trasmessi e a quale scopo.
Passo 3: Verificare la capacità hardware del dispositivo
Non tutto l'hardware può eseguire l'IA locale in modo efficiente. La capacità di inferenza locale dipende criticamente dalla VRAM (memoria video) e dalla RAM di sistema. Per i modelli linguistici di medie dimensioni, si raccomandano almeno 8-16 GB di VRAM, mentre per i modelli piccoli, 4-8 GB possono essere sufficienti.
Se il tuo dispositivo non dispone di una GPU dedicata potente o di RAM sufficiente, è tecnicamente improbabile che l'app stia eseguendo il modello localmente, a meno che non si tratti di un modello molto piccolo e distillato. Nei dispositivi mobili, la presenza di una NPU (Unità di Elaborazione Neurale) indica che il produttore ottimizza per l'IA locale, come si vede nei dispositivi ASUS, HP o Lenovo.
Puoi verificare le tue specifiche nel Task Manager (Windows) o nelle Informazioni di sistema (macOS). Se l'app consuma risorse GPU significative quando risponde, è un segnale forte di elaborazione locale. Se la CPU e la GPU rimangono inattive mentre l'app risponde, il lavoro sta avvenendo nel cloud.
Passo 4: Interpretare la politica sulla privacy
La politica sulla privacy è il documento legale che definisce cosa fa l'azienda con i tuoi dati. Cerca clausole che menzionino l'"addestramento dei modelli" con dati degli utenti. Se la politica indica che i tuoi prompt vengono utilizzati per migliorare il servizio, i tuoi dati stanno lasciando il tuo dispositivo e vengono elaborati da terzi.
Nelle app locali, la politica sulla privacy è di solito più breve e specifica: indica che i dati vengono elaborati sul dispositivo dell'utente e non archiviati su server centrali. Tuttavia, deve chiarire se vengono raccolti metadati di utilizzo o se ci sono funzioni di sincronizzazione che potrebbero inviare dati al cloud.
Una sfumatura importante: alcune app "ibride" consentono di scegliere tra locale e cloud. In questi casi, la politica sulla privacy deve dettagliare le condizioni di ogni modalità. Se non c'è chiarezza, assumi che la modalità predefinita sia quella a maggior rischio, ovvero il cloud.
Decisioni pratiche per la privacy dei dati
Basato sulla verifica, puoi prendere decisioni informate. Se la privacy è la tua priorità massima, scegli app che offrono inferenza 100% locale e verifica che il tuo hardware sia in grado di supportare i modelli di cui hai bisogno. Strumenti come Ollama o LM Studio sono standard in questo ambito.
Se hai bisogno di capacità avanzate che il tuo hardware non supporta, considera l'uso del cloud, ma attiva le opzioni di privacy rafforzata se il provider le offre (come la disattivazione dell'addestramento con i tuoi dati). Negli ambienti aziendali, strumenti come Sophos Protected Browser consentono di limitare il caricamento di file nelle app di IA per prevenire fughe di dati.
La chiave è la trasparenza tecnica. Non fidarti solo del marketing della "privacy"; verifica i permessi, l'hardware e la documentazione. Un utente informato può bilanciare la comodità del cloud con la sicurezza dell'elaborazione locale in base alla sensibilità di ogni compito.