Una stazione di lavoro per l'IA, non un PC convenzionale
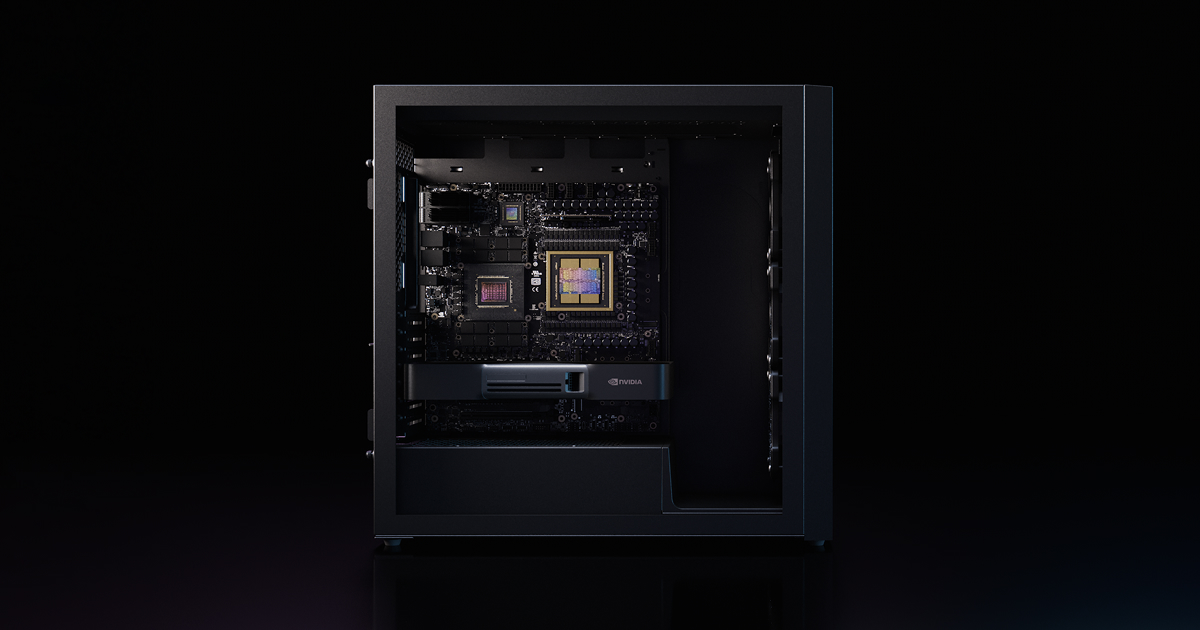
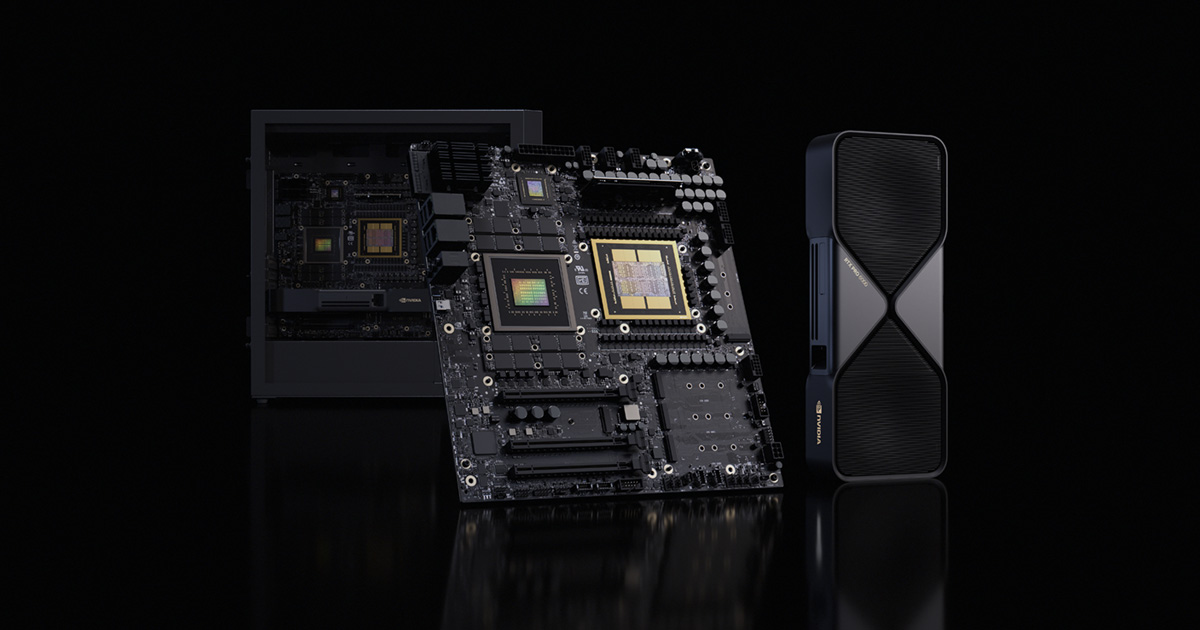
NVIDIA DGX Station è una workstation desktop costruita attorno al superchip GB300 Grace Blackwell Ultra. NVIDIA l'ha presentata nel 2025. La piattaforma combina CPU e GPU, memoria coerente di grande capacità e strumenti di IA di NVIDIA.
DGX Station è progettata per sviluppare ed eseguire carichi di lavoro di IA localmente. NVIDIA la rivolge a sviluppatori, ricercatori e scienziati dei dati che lavorano con modelli e agenti di IA; la scheda tecnica descrive anche l'uso della stazione per inferenza, fine-tuning e data science.
L'annuncio iniziale di DGX Station e quello della versione per Windows sono traguardi distinti. La scheda di NVIDIA presenta la stazione generale con Ubuntu e strumenti di sviluppo per l'IA; la variante per Windows viene annunciata con il sistema operativo di Microsoft e disponibilità prevista per il quarto trimestre. Pertanto, Windows non descrive tutte le configurazioni di DGX Station né garantisce da solo la compatibilità di qualsiasi applicazione o modello.
GB300 e memoria coerente: la specifica che cambia la scala
Il GB300 combina una GPU NVIDIA Blackwell Ultra con una CPU NVIDIA Grace a 72 core basata su Neoverse V2. La scheda tecnica di NVIDIA specifica fino a 748 GB di memoria coerente: 252 GB di HBM3e associati alla GPU e 496 GB di LPDDR5X per la CPU. Non si tratta di una singola memoria omogenea con identico bandwidth: la scheda indica 7,1 TB/s per la HBM3e e 396 GB/s per la LPDDR5X.
La connessione tra CPU e GPU utilizza NVLink-C2C, che consente uno spazio di memoria coerente condiviso. Questa architettura permette di lavorare con modelli grandi all'interno di uno stesso spazio di memoria. La capacità totale aiuta ad allocare modelli di dimensioni maggiori, ma non significa che tutti i dati accedano alla velocità della HBM3e né che ogni applicazione sfrutti la memoria allo stesso modo.
NVIDIA dichiara fino a 20 PFLOPS di calcolo Tensor FP4, con sparsity, e fino a 15 PFLOPS senza questa condizione. Pubblica anche cifre diverse per altre precisioni, come 10 PFLOPS FP8/FP6 e 5 PFLOPS FP16/BF16. Queste metriche descrivono tassi massimi di operazioni sotto precisioni e condizioni specifiche; non equivalgono a una misura universale di velocità per inferenza, fine-tuning o addestramento.
| Risorsa | Specifica pubblicata | Cosa tenere in considerazione |
|---|---|---|
| Memoria HBM3e della GPU | 252 GB; 7,1 TB/s | Memoria ad alto bandwidth per l'acceleratore |
| Memoria LPDDR5X della CPU | 496 GB; 396 GB/s | Amplia lo spazio coerente, con bandwidth diverso |
| Memoria coerente totale | Fino a 748 GB | Capacità condivisa; non è tutta HBM3e |
| Prestazione Tensor FP4 | Fino a 20 PFLOPS con sparsity | Metrica massima condizionata da precisione e sparsity |
| Potenza totale del sistema | 1.600 W | Richiede di considerare circuito elettrico, calore e raffreddamento |
Windows amplia l'integrazione, ma non elimina le differenze di software
L'edizione DGX Station for Windows è pensata per collegare il calcolo locale con applicazioni e flussi aziendali che già funzionano su Windows. NVIDIA indica il supporto della pila di software di IA dell'azienda e l'accesso agli strumenti Linux tramite Windows Subsystem for Linux (WSL).
L'opzione non trasforma i programmi di IA in software indipendente dal sistema operativo. La compatibilità dipende dagli strumenti e dall'ambiente scelti: NVIDIA indica che DGX Station for Windows supporta la sua pila di software di IA e gli strumenti Linux tramite Windows Subsystem for Linux (WSL).
NVIDIA presenta DGX Station con Ubuntu e strumenti di sviluppo per l'IA. La variante per Windows viene annunciata con accesso agli strumenti Linux tramite Windows Subsystem for Linux (WSL), ma la sua disponibilità è prevista per il quarto trimestre. La scelta del sistema operativo dipende dalle applicazioni e dagli strumenti che il team utilizzerà e dal suo ambiente di deployment.
L'edizione per Windows aggiunge inoltre un approccio di gestione aziendale, con telemetria out-of-band tramite BMC e funzioni di amministrazione. NVIDIA descrive anche l'uso di WSL per carichi di lavoro Linux. Queste capacità possono facilitare il deployment in una flotta aziendale, sebbene la sicurezza effettiva dipenderà dalle politiche configurate, dagli aggiornamenti e dalla gestione di ciascuna organizzazione; non si deduce unicamente dalla presenza di Windows.
Quali lavori possono beneficiare di una macchina locale di questa scala
La combinazione di molta memoria e calcolo Tensor può essere utile per inferenza di modelli grandi, sperimentazione con agenti, analisi dei dati e fine-tuning, a patto che il software e la precisione scelti si adattino all'hardware. NVIDIA propone di eseguire localmente modelli fino a un trilione di parametri; è una capacità dichiarata dal produttore, non una garanzia che qualsiasi modello di quelle dimensioni funzioni con una velocità, un contesto o una qualità determinati.
Per i team che lavorano con dati riservati, l'elaborazione locale consente di mantenere i dati all'interno della propria infrastruttura se l'applicazione e la configurazione non li inviano a servizi esterni. Questo può aiutare a ridurre la dipendenza da un'API remota e a controllare l'accesso ai dati, ma l'hardware da solo non garantisce la privacy: è necessario verificare telemetria, connessioni, strumenti di terze parti, archiviazione e politiche degli agenti.
La stazione può anche essere combinata con una GPU NVIDIA RTX PRO Blackwell aggiuntiva per visualizzazione ray-traced e simulazione, secondo la configurazione supportata. Questa possibilità è rilevante per lavori che uniscono IA e grafica professionale, come visualizzazione tecnica o applicazioni di fisica basata su IA. Non va confusa con la capacità della GPU integrata: la scheda aggiuntiva è una configurazione diversa e la sua disponibilità dipende dal produttore del sistema.
Al contrario, i compiti generali da desktop, i giochi o i carichi che usano poco l'acceleratore non giustificano da soli una stazione di questa categoria. Per inferenza leggera, modelli piccoli o uso occasionale, un PC con GPU dedicata, una workstation meno costosa o un servizio cloud potrebbero essere alternative più proporzionate. La domanda pratica non è se DGX Station possa eseguire l'IA, ma se memoria, prestazioni e controllo locale risolvano un'esigenza ricorrente che altre opzioni non coprono.
Consumo, deployment e costo: i limiti da includere nel calcolo
NVIDIA pubblica una potenza totale del sistema di 1.600 W e indica che è necessario un circuito da 20 A.
La potenza nominale non consente da sola di calcolare il costo elettrico reale: il consumo dipende dal carico, dal tempo di utilizzo, dalla configurazione e dal prezzo locale dell'energia. Non permette nemmeno di confrontare le prestazioni per watt con una GPU da desktop senza test equivalenti della stessa attività, precisione e software. Una cifra massima di PFLOPS e un'altra di potenza massima non sostituiscono misurazioni comparabili.
NVIDIA presenta DGX Station come un prodotto di produttori associati e invita a contattarli per richiedere il sistema. Prima di acquistare, è opportuno richiedere un preventivo completo che dettagli imposte, tempi, garanzia, servizio e i componenti inclusi.
Nel confrontare una workstation, è opportuno considerare più del prezzo di una GPU: contano anche la capacità di memoria, la configurazione del sistema, le opzioni di espansione e il budget. DGX Station integra una grande capacità di memoria coerente in una piattaforma da desktop. La decisione dipende dalle esigenze specifiche del progetto.
Per chi ha senso e cosa verificare prima di decidere
NVIDIA descrive DGX Station per sviluppare ed eseguire l'IA localmente e ne propone l'uso con modelli grandi, inferenza, fine-tuning e agenti di IA. La piattaforma consente anche di sviluppare in locale e di scalare o distribuire carichi di lavoro in data center o nel cloud di NVIDIA.
Per uno sviluppatore individuale, è opportuno valutare l'acquisto in base ai carichi di lavoro previsti e alla configurazione necessaria. La dimensione del modello non basta per decidere: contano anche la lunghezza del contesto, la quantizzazione, la concorrenza, la latenza accettabile e le prestazioni richieste dal progetto.
Prima di decidere, è opportuno verificare questi punti:
- Che i modelli e i framework necessari supportino la configurazione e il sistema operativo scelti.
- Quanta memoria richiede il carico reale, separando capacità di memoria da bandwidth.
- Se bastino inferenza e prototipazione o se il progetto richieda addestramento su larga scala.
- Che l'installazione elettrica e il raffreddamento dello spazio supportino un sistema da 1.600 W.
- Quale prezzo, componenti, garanzia e tempi offra il produttore associato nel mercato corrispondente.
La scheda di NVIDIA specifica fino a 748 GB di memoria coerente e un sistema da 1.600 W. Nel confrontare le opzioni, considera questi requisiti insieme ai carichi di lavoro e alla configurazione necessari.