Definizione pratica e ambito del termine
L'IA locale è un modo pratico per descrivere i sistemi in cui un modello o una funzione di intelligenza artificiale viene eseguito sul dispositivo dell'utente o su infrastruttura controllata da quest'ultimo, dalla sua organizzazione o da un amministratore. Il termine non determina da solo la dimensione del modello, chi lo ha sviluppato o se l'intero servizio funziona offline.
Non esiste una definizione tecnica unica di «IA locale» nelle fonti disponibili. Pertanto, è opportuno usarla per parlare di dove avviene l'elaborazione di una funzione specifica, anziché trattarla come una categoria chiusa con requisiti universali. Un telefono che elabora un compito e un server di un'organizzazione possono rientrare in quella descrizione, anche se le loro risorse e forme di amministrazione sono diverse.
La differenza di base con un servizio di IA nel cloud sta nella posizione del calcolo principale: nel primo caso viene eseguito sul dispositivo o in un ambiente locale; nel secondo, su infrastruttura remota del provider. Questa distinzione non implica che ogni componente segua lo stesso percorso. Un'applicazione può elaborare un'operazione localmente e ricorrere a servizi remoti per altre funzioni.
Quindi, quando si valuta una funzione, è più preciso chiedere quale parte viene elaborata localmente che etichettare l'intera applicazione come locale. Il download del modello, l'autenticazione, gli aggiornamenti e le funzioni ausiliarie possono ancora dipendere da una connessione o da servizi esterni. La parola «locale» non dimostra, da sola, che non ci sia scambio di dati con terze parti.
Come funziona: modello, input e risorse
In termini semplici, il sistema deve disporre del modello sul dispositivo o sul server scelto ed eseguire lì le operazioni corrispondenti a una richiesta. La CPU, la GPU e la memoria sono parte delle risorse che possono intervenire. Se il compito viene completato in quell'ambiente, l'input non ha bisogno di essere inviato a un server remoto per quell'elaborazione; questo non esclude altre comunicazioni relative all'applicazione.
Il dispositivo deve avere risorse sufficienti per caricare il modello e gestire il compito. La memoria disponibile è un limite importante, ma non l'unico: contano anche la capacità di calcolo, il formato del modello e l'applicazione che lo esegue. Non basta che il file stia nello storage; il sistema deve poterlo utilizzare durante l'inferenza.
Alcuni esempi illustrano la differenza tra installare un modello e poterlo eseguire. Una guida secondaria cita modelli di 12 miliardi di parametri associati a circa 7,6 GB e di 27 miliardi associati a 18 GB. Sono esempi concreti di quella fonte, non requisiti universali: i bisogni reali variano a seconda del modello, del suo formato, della configurazione e dell'hardware.
L'elaborazione può avvenire su un computer personale o su un server amministrato da un'organizzazione. Quest'ultimo può offrire risorse diverse da quelle di un mobile, ma «locale» non significa automaticamente che l'utente abbia il controllo esclusivo sul server. Per comprendere il deployment, bisogna distinguere posizione fisica, amministrazione e accesso: sono questioni correlate, ma non equivalenti.
Locale, sul dispositivo, offline e self-hosted
Questi termini descrivono aspetti diversi e possono sovrapporsi. L'IA sul dispositivo indica di solito che il calcolo avviene su un mobile, un computer o un altro equipaggiamento personale. «IA locale» può coprire quel caso, ma anche un server all'interno di una rete o infrastruttura amministrata localmente. «Self-hosted» mette l'accento su chi mantiene o amministra il sistema, non necessariamente sul fatto che si esegua sullo stesso apparato usato dalla persona.
«Offline» descrive una condizione di connettività: la funzione può operare senza accesso a internet. Non è sinonimo di «locale». Un modello può eseguirsi sul dispositivo e aver bisogno di internet per scaricarsi, aggiornarsi o accedere a una funzione complementare. Al contrario, un server di una rete locale può gestire richieste su quella rete anche se i dispositivi client sono connessi ad essa.
Il cloud si riferisce qui a elaborazione realizzata su infrastruttura remota gestita da un provider. Le configurazioni possono essere ibride: una fase si esegue sul dispositivo e un'altra viene inviata a un servizio remoto. La tabella riassume distinzioni pratiche; non sono categorie necessariamente esclusive né garantiscono da sole un risultato di privacy determinato.
| Configurazione | Dove avviene il calcolo principale | Serve internet? | Cosa si può concludere sulla privacy |
|---|---|---|---|
| IA sul dispositivo | Sul mobile o computer usato dalla persona | Non necessariamente per ogni compito; download o funzioni aggiuntive possono richiedere connessione | L'input elaborato localmente non deve essere inviato per quell'operazione; bisogna verificare altre comunicazioni |
| IA self-hosted | Su infrastruttura amministrata dalla persona o organizzazione, come un server proprio | Dipende dall'accesso al server, dagli aggiornamenti e dai servizi associati | L'amministrazione può essere sotto controllo proprio; questo non dimostra che il server o l'applicazione siano liberi da accessi o trasferimenti |
| Elaborazione nel cloud | Su infrastruttura remota del provider | Di solito serve connessione per inviare richieste e ricevere risultati | La richiesta viene elaborata fuori dal dispositivo; le politiche e il percorso dei dati dipendono dal servizio |
| Configurazione ibrida | Una combinazione di dispositivo, infrastruttura locale e servizi remoti | Dipende dalla funzione specifica | Bisogna identificare quali dati e fasi passano attraverso ogni ambiente |
Privacy, sicurezza e connettività
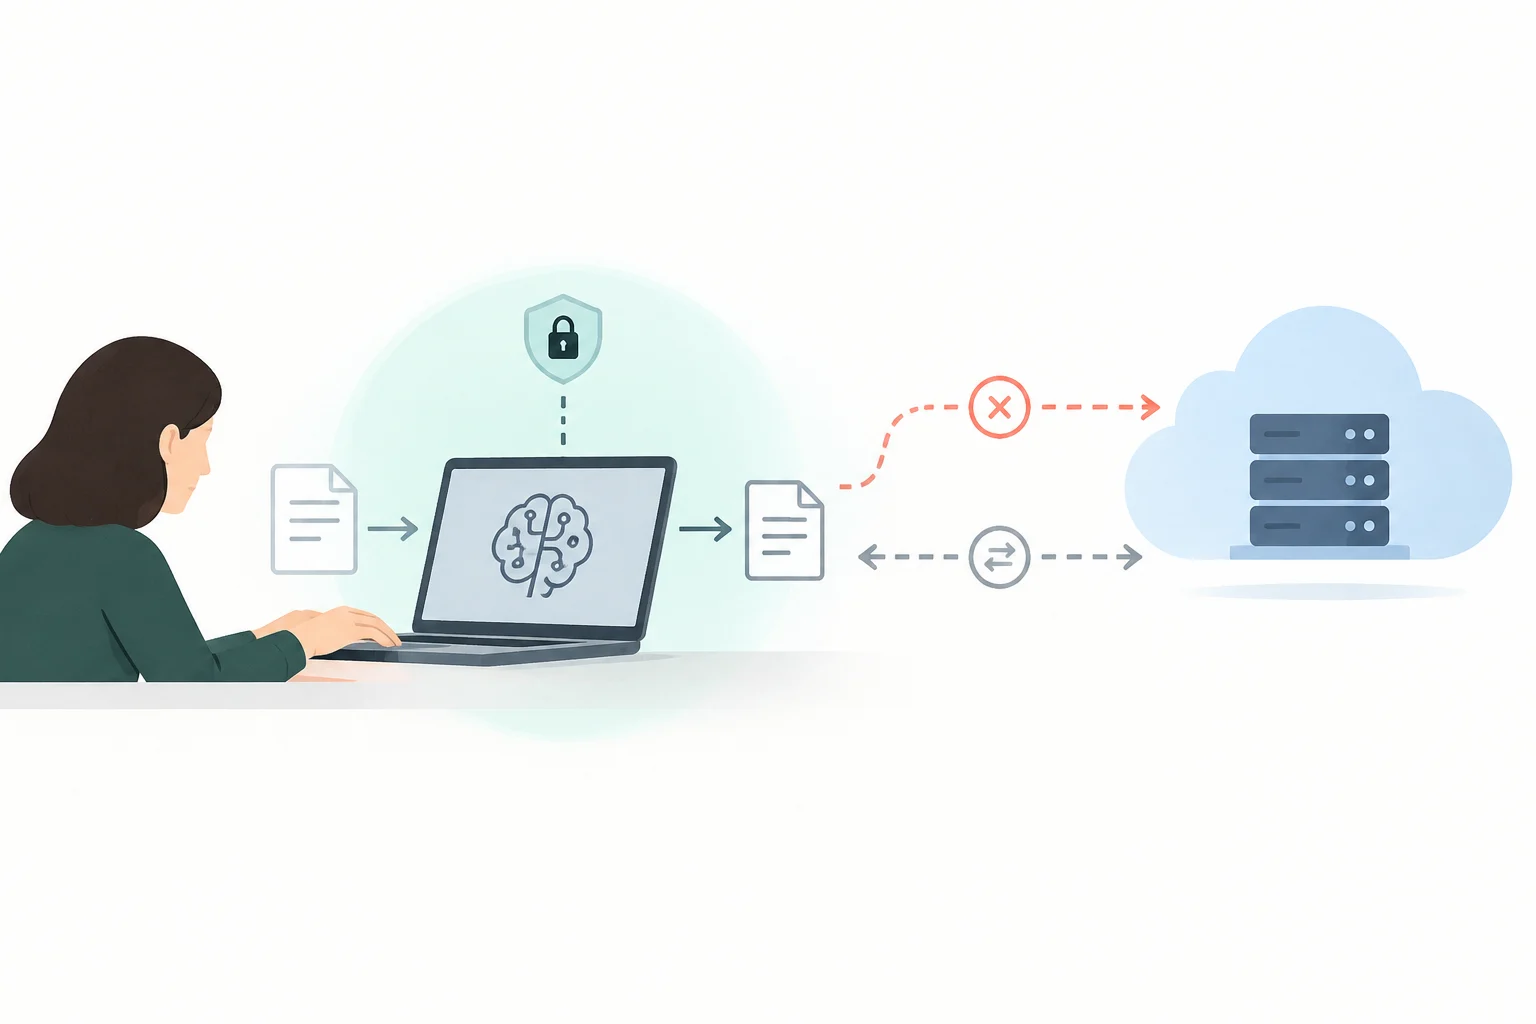
Se una richiesta viene elaborata localmente e non trasmessa a un altro sistema, l'esposizione associata all'invio di quell'input a un provider remoto può essere ridotta. È un vantaggio potenziale di controllo, non una garanzia generale di privacy. Per sapere cosa accade nella pratica, bisogna verificare il percorso dei dati di ogni funzione, incluse le fasi precedenti e successive all'inferenza.
Il termine locale non certifica nemmeno la sicurezza dell'equipaggiamento. Un dispositivo o server può essere configurato male, consentire accessi non autorizzati o salvare dati in modi inaspettati per l'utente. La protezione dipende dalle misure applicate, da chi ha accesso e da come si gestiscono registri, copie e aggiornamenti. La posizione del calcolo è solo un pezzo di quella valutazione.
La connessione può ancora essere necessaria per ottenere il modello, aggiornarlo o usare capacità remote. Inoltre, un'applicazione può combinare elaborazione locale con richieste a servizi esterni. Pertanto, funzionare localmente non equivale a funzionare sempre senza rete. La domanda utile è quali compiti si possono completare offline e quali dati vengono trasmessi quando la connessione torna disponibile.
Per informazioni sensibili, non conviene dedurre la privacy da un'etichetta commerciale o da un'impostazione isolata. Cerca spiegazioni del provider su cosa viene elaborato sul dispositivo, cosa viene inviato ai server, quanto tempo viene conservato e quali servizi vengono attivati. Se la documentazione non permette di rispondere, quella mancanza di dettaglio limita ciò che si può concludere; non dimostra, da sola, che ci sia un trasferimento.
Applicazioni possibili e limiti di prestazioni
L'elaborazione locale può essere pertinente quando si vuole che un compito venga risolto vicino ai dati o ridurre la dipendenza da un servizio remoto. Tra i compiti spesso considerati ci sono riassumere documenti, trascrivere contenuti o analizzare immagini. Queste sono possibili applicazioni dell'approccio, non una garanzia che qualsiasi modello locale possa eseguire ogni compito con qualità adeguata.
La scelta dipende dal compito e dal modello, oltre che dall'hardware. Un modello specializzato nel testo non equivale a uno preparato per analizzare immagini; due modelli di dimensioni simili non rispondono necessariamente allo stesso modo. Per documenti estesi, ad esempio, contano la capacità di gestire il contesto e il modo in cui l'applicazione incorpora le informazioni. La dimensione o il nome del modello non bastano per anticipare la sua utilità.
Sul dispositivo, la memoria e la capacità di calcolo limitano quali modelli possono essere eseguiti e con quale fluidità. I modelli più grandi possono richiedere più risorse; la documentazione disponibile non permette di offrire una cifra universale di velocità, consumo o qualità per ogni tipo di equipaggiamento. La decisione pratica è verificare i requisiti del modello specifico e la compatibilità dell'applicazione, senza assumere che l'installazione basti.
Ci sono anche costi operativi meno visibili: riservare spazio, ottenere nuove versioni e mantenere l'ambiente. In un'installazione amministrata, quei compiti ricadono su chi mantiene l'infrastruttura. In un servizio remoto, parte di quella manutenzione può corrispondere al provider, anche se l'utente dipende ancora dal suo servizio e connessione. Controllo e comodità possono implicare compromessi diversi, non una gerarchia valida per tutti.
Come verificare dove viene elaborata una funzione
Inizia dalla documentazione ufficiale del provider e cerca una spiegazione riferita alla funzione specifica: esecuzione sul dispositivo, elaborazione remota o modalità ibrida. Verifica anche se la funzione richiede di scaricare un modello, connettersi a un server o attivare servizi aggiuntivi. Una descrizione generale dell'applicazione può non chiarire il comportamento di ogni capacità.
I permessi del sistema operativo forniscono contesto sugli accessi che un'applicazione richiede, ma non identificano da soli la destinazione dei dati né dove viene eseguito un modello. Su Android, ad esempio, <uses-permission-sdk-23> permette di dichiarare che un permesso è richiesto per installazioni su Android 6.0 (livello API 23) o successivo. Quella dichiarazione riguarda permessi e compatibilità, non dimostra che l'IA funzioni localmente.
È anche utile verificare se un compito resta disponibile disattivando la connessione, ma quel risultato informa solo sul bisogno di rete in quella circostanza. Non certifica da solo quali dati sono stati trasmessi prima, se ci sono registri né come si comportano altre funzioni. Allo stesso modo, un indicatore «sul dispositivo» deve essere letto insieme alla documentazione e all'ambito esatto a cui si riferisce.
Un breve elenco di controllo aiuta a evitare conclusioni affrettate:
- Identifica la funzione e il modello, non solo il nome dell'applicazione.
- Cerca dove viene eseguita l'inferenza e quali operazioni usano servizi remoti.
- Rivedi i requisiti di download, aggiornamento e connessione.
- Consulta quali dati vengono salvati, trasmessi o registrati, e per quanto tempo.
- Se la risposta non è documentata, considera la posizione dell'elaborazione non confermata, anziché inferirla da permessi o messaggi promozionali.