Definição prática e alcance do termo
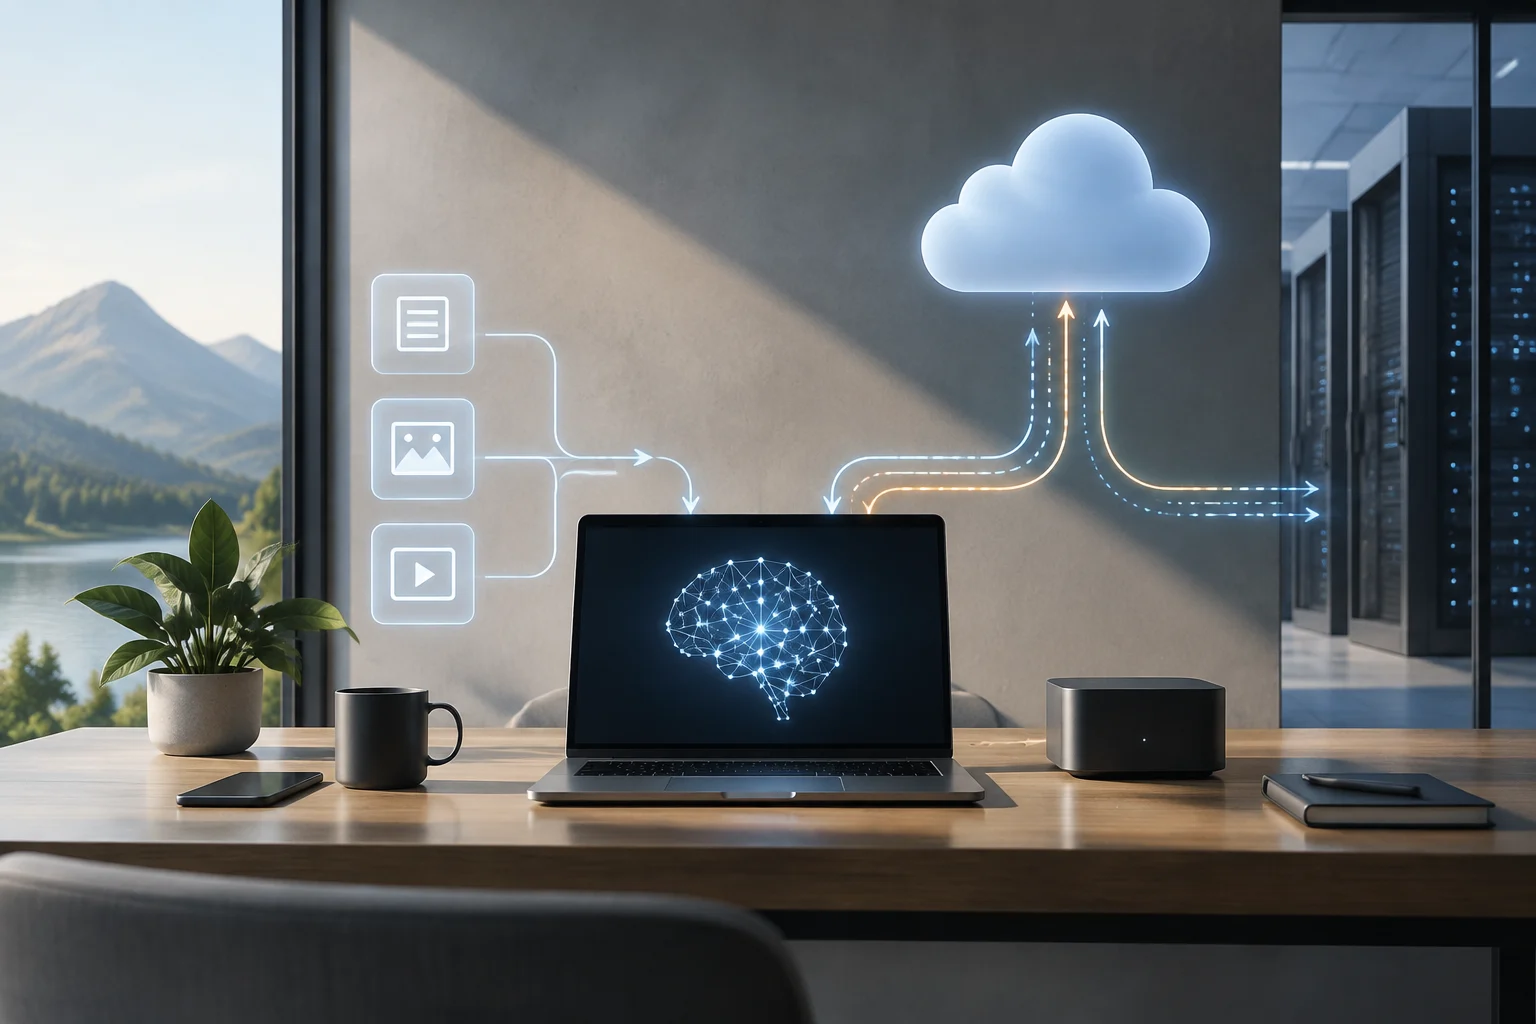
A IA local é uma forma prática de descrever sistemas em que um modelo ou uma função de inteligência artificial é executado no dispositivo do usuário ou em infraestrutura controlada por este, sua organização ou um administrador. O termo não determina por si só o tamanho do modelo, quem o desenvolveu ou se todo o serviço funciona offline.
Não há uma definição técnica única de «IA local» nas fontes disponíveis. Por isso, convém usá-la para falar de onde ocorre o processamento de uma função concreta, em vez de tratá-la como uma categoria fechada com requisitos universais. Um telefone que processa uma tarefa e um servidor de uma organização podem encaixar nessa descrição, embora seus recursos e formas de administração sejam distintos.
A diferença básica com um serviço de IA na nuvem está na localização do cálculo principal: no primeiro caso, é realizado no dispositivo ou em um ambiente local; no segundo, em infraestrutura remota do provedor. Esta distinção não implica que cada componente siga o mesmo caminho. Um aplicativo pode processar uma operação localmente e recorrer a serviços remotos para outras funções.
Por isso, ao avaliar uma função, é mais preciso perguntar qual parte é processada localmente do que rotular todo o aplicativo como local. O download do modelo, a autenticação, as atualizações e as funções auxiliares podem continuar dependendo de uma conexão ou de serviços externos. A palavra «local» não demonstra, por si só, que não há troca de dados com terceiros.
Como funciona: modelo, entradas e recursos
Em termos simples, o sistema precisa dispor do modelo no dispositivo ou no servidor escolhido e executar ali as operações correspondentes a uma solicitação. A CPU, a GPU e a memória são parte dos recursos que podem intervir. Se a tarefa é concluída nesse ambiente, a entrada não precisa ser enviada a um servidor remoto para esse processamento; isso não exclui outras comunicações relacionadas ao aplicativo.
O dispositivo deve ter recursos suficientes para carregar o modelo e atender à tarefa. A memória disponível é um limite importante, mas não o único: também contam a capacidade de cálculo, o formato do modelo e o aplicativo que o executa. Não basta que o arquivo caiba no armazenamento; o sistema deve poder utilizá-lo durante a inferência.
Alguns exemplos ilustram a diferença entre instalar um modelo e poder executá-lo. Um guia secundário cita modelos de 12 bilhões de parâmetros associados a cerca de 7,6 GB e de 27 bilhões associados a 18 GB. São exemplos concretos dessa fonte, não requisitos universais: as necessidades reais variam conforme o modelo, seu formato, a configuração e o hardware.
O processamento pode ocorrer em um computador pessoal ou em um servidor administrado por uma organização. Este último pode oferecer recursos diferentes dos de um celular, mas «local» não significa automaticamente que o usuário tenha controle exclusivo sobre o servidor. Para entender o despliegue, é preciso distinguir localização física, administração e acesso: são questões relacionadas, mas não equivalentes.
Local, no dispositivo, offline e auto-hospedada
Estes termos descrevem aspectos diferentes e podem se sobrepor. IA no dispositivo geralmente indica que o cálculo ocorre em um celular, computador ou outro equipamento pessoal. «IA local» pode abranger esse caso, mas também um servidor dentro de uma rede ou infraestrutura administrada localmente. «Auto-hospedada» coloca o foco em quem mantém ou administra o sistema, não necessariamente em que ele seja executado no mesmo aparelho que a pessoa usa.
«Offline» descreve uma condição de conectividade: a função pode operar sem acesso à internet. Não é sinônimo de «local». Um modelo pode ser executado no dispositivo e precisar de internet para ser baixado, atualizado ou acessar uma função complementar. Por outro lado, um servidor de uma rede local pode atender solicitações nessa rede, mesmo que os dispositivos cliente estejam conectados a ela.
A nuvem refere-se aqui a processamento realizado em infraestrutura remota gerenciada por um provedor. As configurações podem ser híbridas: uma etapa é executada no dispositivo e outra é enviada a um serviço remoto. A tabela resume distinções práticas; não são categorias necessariamente exclusivas nem garantem por si mesmas um resultado de privacidade determinado.
| Configuração | Onde ocorre o cálculo principal | Precisa de internet? | O que se pode concluir sobre privacidade |
|---|---|---|---|
| IA no dispositivo | No celular ou computador usado pela pessoa | Não necessariamente para cada tarefa; download ou funções adicionais podem requerer conexão | A entrada processada localmente não precisa ser enviada para essa operação; é preciso verificar outras comunicações |
| IA auto-hospedada | Em infraestrutura administrada pela pessoa ou organização, como um servidor próprio | Depende do acesso ao servidor, das atualizações e dos serviços associados | A administração pode estar sob controle próprio; isso não demonstra que o servidor ou o aplicativo estejam livres de acessos ou transferências |
| Processamento na nuvem | Em infraestrutura remota do provedor | Habitualmente se requer conexão para enviar solicitações e receber resultados | A solicitação é processada fora do dispositivo; as políticas e o percurso dos dados dependem do serviço |
| Configuração híbrida | Uma combinação de dispositivo, infraestrutura local e serviços remotos | Depende da função concreta | É preciso identificar quais dados e etapas passam por cada ambiente |
Privacidade, segurança e conectividade
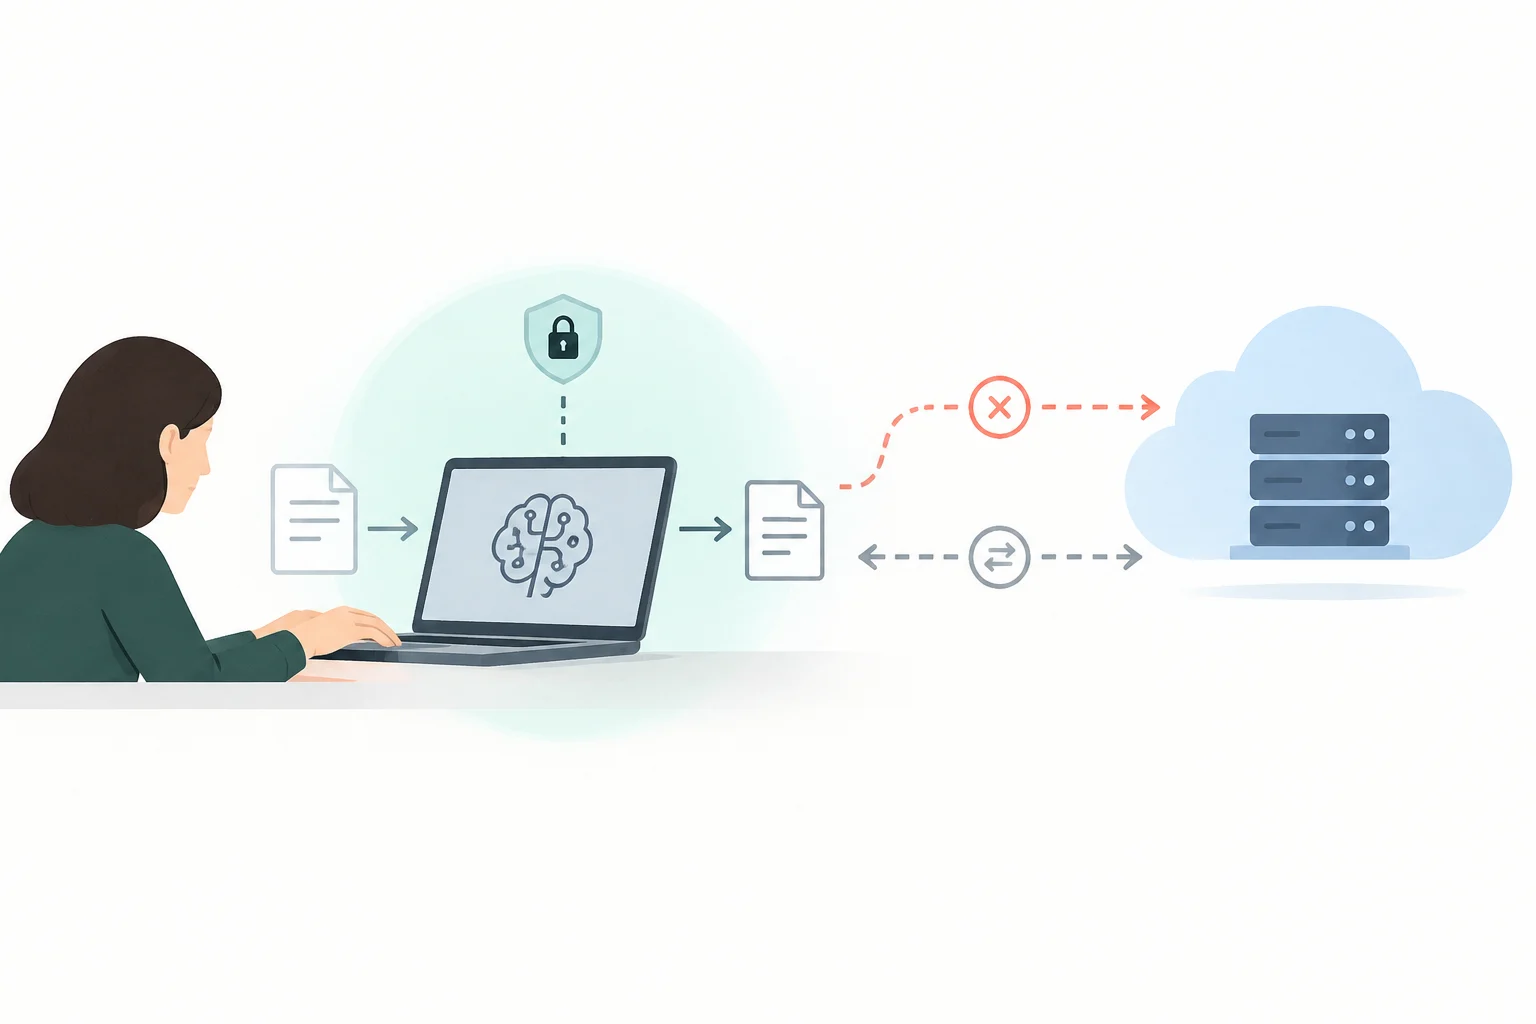
Se uma solicitação é processada localmente e não transmitida a outro sistema, a exposição associada ao envio dessa entrada a um provedor remoto pode ser reduzida. É uma vantagem potencial de controle, não uma garantia geral de privacidade. Para saber o que acontece na prática, é preciso verificar o percurso dos dados de cada função, incluindo as etapas anteriores e posteriores à inferência.
O termo local também não certifica a segurança do equipamento. Um dispositivo ou servidor pode estar mal configurado, permitir acessos indevidos ou guardar dados de maneira que o usuário não espera. A proteção depende das medidas aplicadas, de quem tem acesso e de como se gerenciam registros, cópias e atualizações. A localização do cálculo é apenas uma peça dessa avaliação.
A conexão pode continuar sendo necessária para obter o modelo, atualizá-lo ou usar capacidades remotas. Além disso, um aplicativo pode combinar processamento local com solicitações a serviços externos. Por isso, funcionar localmente não equivale a funcionar sempre sem rede. A pergunta útil é quais tarefas podem ser concluídas offline e quais dados são transmitidos quando a conexão volta a estar disponível.
Para informações sensíveis, não convém deduzir a privacidade a partir de um rótulo comercial ou de um ajuste isolado. Busque explicações do provedor sobre o que é processado no dispositivo, o que é enviado a servidores, quanto tempo é conservado e quais serviços são ativados. Se a documentação não permite respondê-lo, essa falta de detalhe limita o que se pode concluir; não prova, por si só, que haja uma transferência.
Aplicações possíveis e limites de desempenho
O processamento local pode ser pertinente quando se quer que uma tarefa seja resolvida perto dos dados ou reduzir a dependência de um serviço remoto. Entre as tarefas que costumam ser consideradas estão resumir documentos, transcrever conteúdo ou analisar imagens. Estas são aplicações possíveis da abordagem, não uma garantia de que qualquer modelo local possa realizar cada tarefa com qualidade adequada.
A escolha depende da tarefa e do modelo, além do hardware. Um modelo especializado em texto não equivale a um preparado para analisar imagens; dois modelos de tamanho parecido também não precisam responder da mesma forma. Para documentos extensos, por exemplo, importam a capacidade de lidar com o contexto e a forma como o aplicativo incorpora a informação. O tamanho ou o nome do modelo não bastam para antecipar sua utilidade.
No dispositivo, a memória e a capacidade de cálculo limitam quais modelos podem ser executados e com que fluidez. Os modelos maiores podem requerer mais recursos; a documentação disponível não permite oferecer uma cifra universal de velocidade, consumo ou qualidade para cada tipo de equipamento. A decisão prática é verificar os requisitos do modelo concreto e a compatibilidade do aplicativo, sem assumir que a instalação basta.
Também há custos operacionais menos visíveis: reservar espaço, obter novas versões e manter o ambiente. Em uma instalação administrada, essas tarefas recaem sobre quem mantém a infraestrutura. Em um serviço remoto, parte dessa manutenção pode corresponder ao provedor, embora o usuário continue dependendo de seu serviço e conexão. Controle e conforto podem implicar compromissos distintos, não uma hierarquia válida para todos.
Como verificar onde uma função é processada
Comece pela documentação oficial do provedor e busque uma explicação referida à função concreta: execução no dispositivo, processamento remoto ou modalidade híbrida. Verifique também se a função requer baixar um modelo, conectar-se a um servidor ou ativar serviços adicionais. Uma descrição geral do aplicativo pode não esclarecer o comportamento de cada capacidade.
As permissões do sistema operacional fornecem contexto sobre os acessos que um aplicativo solicita, mas não identificam por si só o destino dos dados nem onde um modelo é executado. No Android, por exemplo, <uses-permission-sdk-23> permite declarar que uma permissão é requerida para instalações no Android 6.0 (nível de API 23) ou posterior. Essa declaração trata de permissões e compatibilidade, não de demonstrar que a IA funcione localmente.
Também é útil verificar se uma tarefa continua disponível ao desativar a conexão, mas esse resultado só informa sobre a necessidade de rede nessa circunstância. Não certifica por si só quais dados foram transmitidos antes, se há registros nem como se comportam outras funções. Da mesma forma, um indicador de «no dispositivo» deve ser lido junto com a documentação e o escopo exato ao qual se refere.
Uma breve lista de verificação ajuda a evitar conclusões precipitadas:
- Identifique a função e o modelo, não apenas o nome do aplicativo.
- Busque onde a inferência é executada e quais operações usam serviços remotos.
- Revise os requisitos de download, atualização e conexão.
- Consulte quais dados são guardados, transmitidos ou registrados, e por quanto tempo.
- Se a resposta não estiver documentada, considere a localização do processamento não confirmada, em vez de inferi-la a partir de permissões ou mensagens promocionais.