Definición práctica y alcance del término
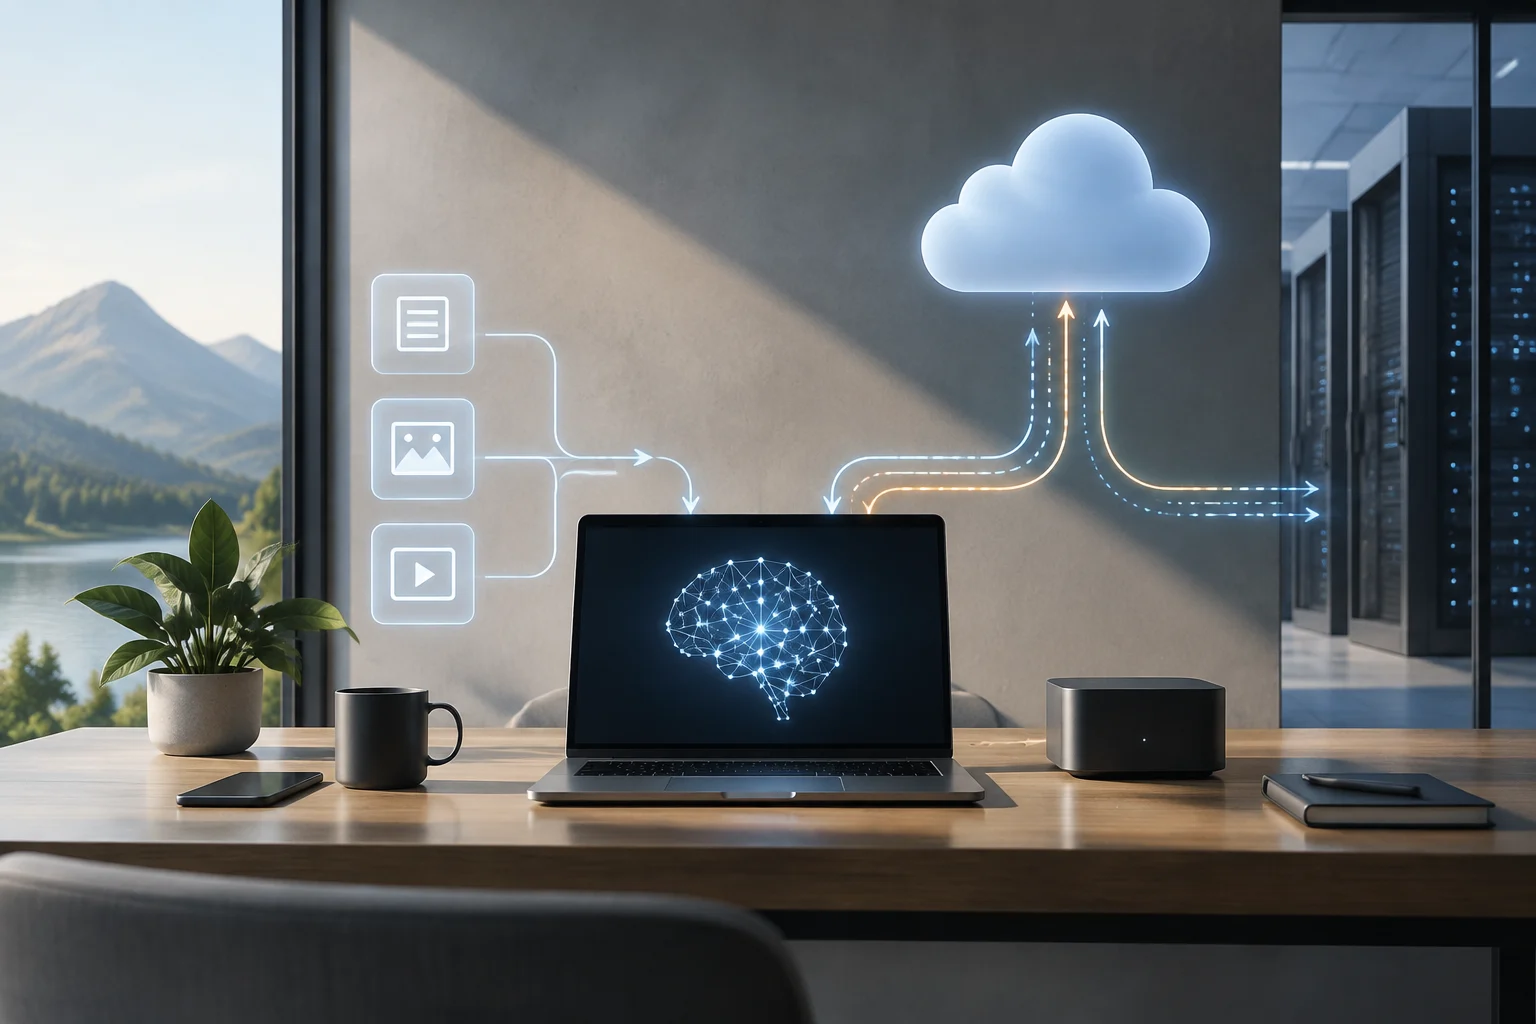
La IA local es una forma práctica de describir sistemas en los que un modelo o una función de inteligencia artificial se ejecuta en el dispositivo del usuario o en infraestructura que este, su organización o un administrador controla. El término no determina por sí solo el tamaño del modelo, quién lo desarrolló ni si todo el servicio funciona sin conexión.
No hay una definición técnica única de «IA local» en las fuentes disponibles. Por eso, conviene usarla para hablar de dónde ocurre el procesamiento de una función concreta, en vez de tratarla como una categoría cerrada con requisitos universales. Un teléfono que procesa una tarea y un servidor de una organización pueden encajar en esa descripción, aunque sus recursos y formas de administración sean distintos.
La diferencia básica con un servicio de IA en la nube está en la ubicación del cálculo principal: en el primer caso se realiza en el dispositivo o en un entorno local; en el segundo, en infraestructura remota del proveedor. Esta distinción no implica que cada componente siga la misma ruta. Una aplicación puede procesar una operación localmente y recurrir a servicios remotos para otras funciones.
Por eso, al evaluar una función, es más preciso preguntar qué parte se procesa localmente que etiquetar toda la aplicación como local. La descarga del modelo, la autenticación, las actualizaciones y las funciones auxiliares pueden seguir dependiendo de una conexión o de servicios externos. La palabra «local» no demuestra, por sí sola, que no haya intercambio de datos con terceros.
Cómo funciona: modelo, entradas y recursos
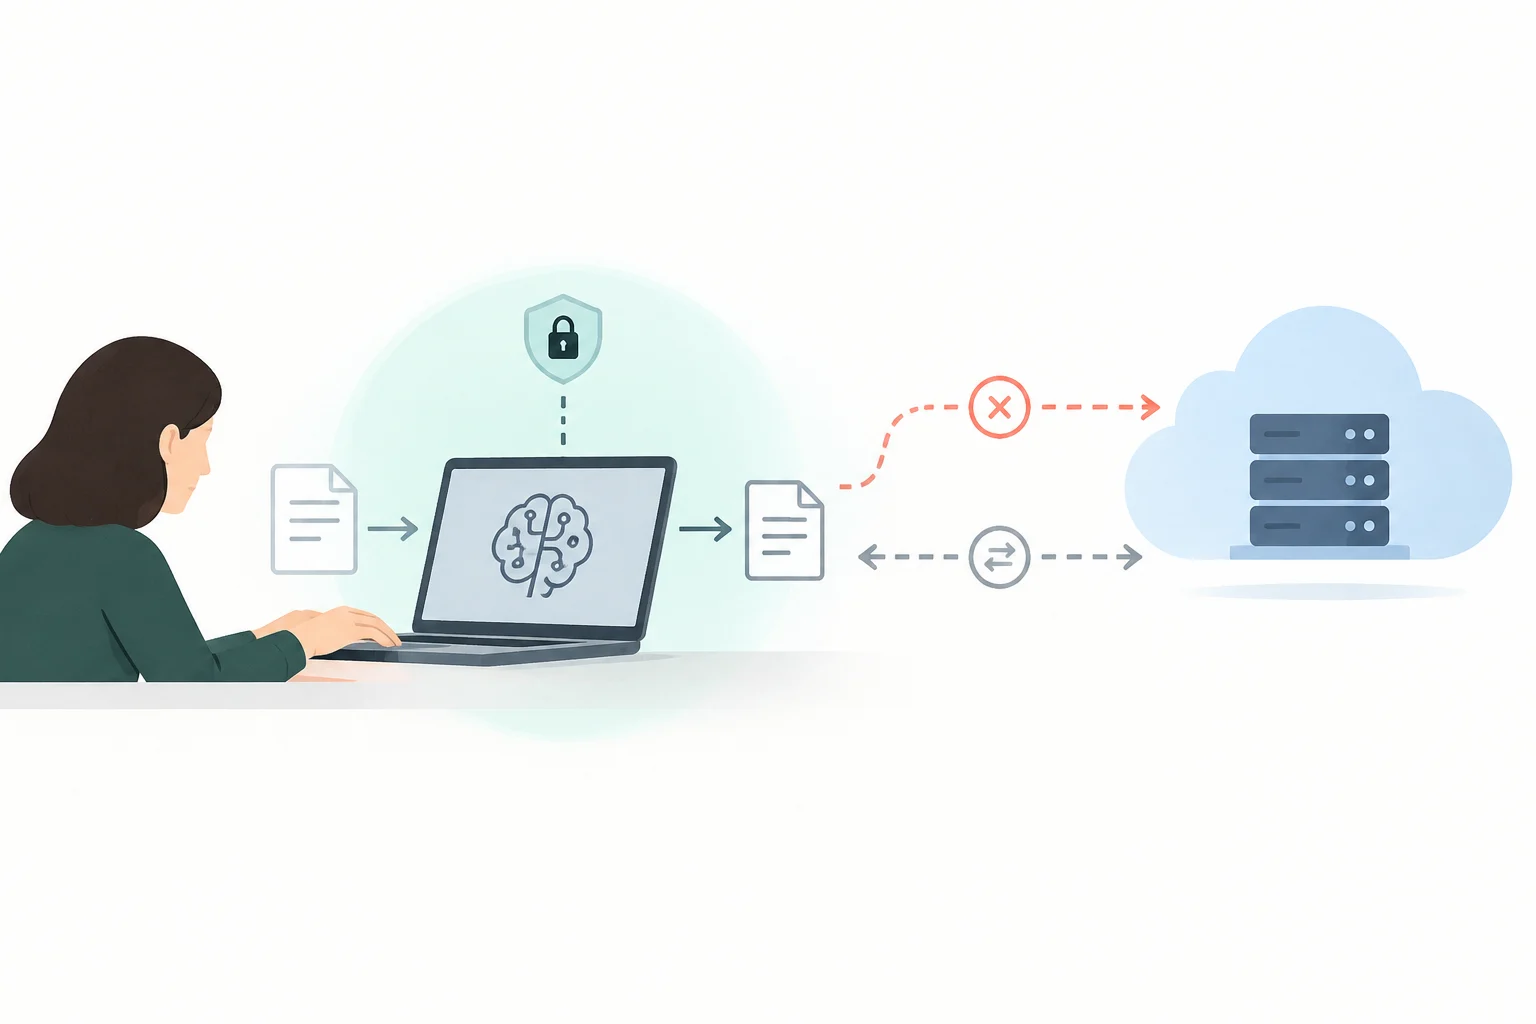
En términos sencillos, el sistema necesita disponer del modelo en el dispositivo o en el servidor elegido y ejecutar allí las operaciones correspondientes a una solicitud. La CPU, la GPU y la memoria son parte de los recursos que pueden intervenir. Si la tarea se completa en ese entorno, la entrada no necesita enviarse a un servidor remoto para ese procesamiento; eso no excluye otras comunicaciones relacionadas con la aplicación.
El dispositivo debe tener recursos suficientes para cargar el modelo y atender la tarea. La memoria disponible es un límite importante, pero no es el único: también cuentan la capacidad de cálculo, el formato del modelo y la aplicación que lo ejecuta. No basta con que el archivo quepa en el almacenamiento; el sistema debe poder utilizarlo durante la inferencia.
Algunos ejemplos ilustran la diferencia entre instalar un modelo y poder ejecutarlo. Una guía secundaria cita modelos de 12 mil millones de parámetros asociados a unos 7,6 GB y de 27 mil millones asociados a 18 GB. Son ejemplos concretos de esa fuente, no requisitos universales: las necesidades reales varían según el modelo, su formato, la configuración y el hardware.
El procesamiento puede ocurrir en un equipo personal o en un servidor administrado por una organización. Este último puede ofrecer recursos distintos a los de un móvil, pero «local» no significa automáticamente que el usuario tenga control exclusivo sobre el servidor. Para entender el despliegue hay que distinguir ubicación física, administración y acceso: son cuestiones relacionadas, pero no equivalentes.
Local, en el dispositivo, sin conexión y autoalojada
Estos términos describen aspectos diferentes y pueden solaparse. IA en el dispositivo suele indicar que el cálculo ocurre en un móvil, ordenador u otro equipo personal. «IA local» puede abarcar ese caso, pero también un servidor dentro de una red o infraestructura administrada localmente. «Autoalojada» pone el acento en quién mantiene o administra el sistema, no necesariamente en que se ejecute en el mismo aparato que usa la persona.
«Sin conexión» describe una condición de conectividad: la función puede operar sin acceso a internet. No es sinónimo de «local». Un modelo puede ejecutarse en el dispositivo y necesitar internet para descargarse, actualizarse o acceder a una función complementaria. A la inversa, un servidor de una red local puede atender solicitudes en esa red aunque los dispositivos cliente sí estén conectados a ella.
La nube se refiere aquí a procesamiento realizado en infraestructura remota gestionada por un proveedor. Las configuraciones pueden ser híbridas: una etapa se ejecuta en el dispositivo y otra se envía a un servicio remoto. La tabla resume distinciones prácticas; no son categorías necesariamente excluyentes ni garantizan por sí mismas un resultado de privacidad determinado.
| Configuración | Dónde ocurre el cálculo principal | ¿Necesita internet? | Qué permite concluir sobre privacidad |
|---|---|---|---|
| IA en el dispositivo | En el móvil u ordenador que usa la persona | No necesariamente para ejecutar cada tarea; descarga o funciones adicionales pueden requerir conexión | La entrada procesada localmente no tiene que enviarse para esa operación; hay que comprobar otras comunicaciones |
| IA autoalojada | En infraestructura administrada por la persona u organización, como un servidor propio | Depende del acceso al servidor, las actualizaciones y los servicios asociados | La administración puede estar bajo control propio; eso no demuestra que el servidor o la aplicación estén libres de accesos o transferencias |
| Procesamiento en la nube | En infraestructura remota del proveedor | Habitualmente se requiere conexión para enviar solicitudes y recibir resultados | La solicitud se procesa fuera del dispositivo; las políticas y el recorrido de los datos dependen del servicio |
| Configuración híbrida | Una combinación de dispositivo, infraestructura local y servicios remotos | Depende de la función concreta | Hay que identificar qué datos y etapas pasan por cada entorno |
Privacidad, seguridad y conectividad
Si una solicitud se procesa localmente y no se transmite a otro sistema, puede reducirse la exposición asociada a enviar esa entrada a un proveedor remoto. Es una ventaja potencial de control, no una garantía general de privacidad. Para saber qué ocurre en la práctica, hay que comprobar el recorrido de los datos de cada función, incluidas las etapas previas y posteriores a la inferencia.
El término local tampoco certifica la seguridad del equipo. Un dispositivo o servidor puede estar mal configurado, permitir accesos indebidos o guardar datos de manera que el usuario no espera. La protección depende de las medidas aplicadas, de quién tiene acceso y de cómo se gestionan registros, copias y actualizaciones. La ubicación del cálculo es solo una pieza de esa evaluación.
La conexión puede seguir siendo necesaria para obtener el modelo, actualizarlo o usar capacidades remotas. Además, una aplicación puede combinar procesamiento local con solicitudes a servicios externos. Por eso, funcionar localmente no equivale a funcionar siempre sin red. La pregunta útil es qué tareas se pueden completar sin conexión y qué datos se transmiten cuando esta vuelve a estar disponible.
Para información sensible, no conviene deducir la privacidad a partir de un rótulo comercial o de un ajuste aislado. Busca explicaciones del proveedor sobre qué se procesa en el dispositivo, qué se envía a servidores, cuánto tiempo se conserva y qué servicios se activan. Si la documentación no permite responderlo, esa falta de detalle limita lo que se puede concluir; no prueba, por sí sola, que haya una transferencia.
Aplicaciones posibles y límites de rendimiento
El procesamiento local puede ser pertinente cuando se quiere que una tarea se resuelva cerca de los datos o reducir la dependencia de un servicio remoto. Entre las tareas que se suelen plantear están resumir documentos, transcribir contenido o analizar imágenes. Estas son posibles aplicaciones del enfoque, no una garantía de que cualquier modelo local pueda realizar cada tarea con calidad adecuada.
La elección depende de la tarea y del modelo, además del hardware. Un modelo especializado en texto no equivale a uno preparado para analizar imágenes; dos modelos de tamaño parecido tampoco tienen por qué responder igual. Para documentos extensos, por ejemplo, importan la capacidad para manejar el contexto y la forma en que la aplicación incorpora la información. El tamaño o el nombre del modelo no bastan para anticipar su utilidad.
En el dispositivo, la memoria y la capacidad de cálculo limitan qué modelos pueden ejecutarse y con qué fluidez. Los modelos mayores pueden requerir más recursos; la documentación disponible no permite ofrecer una cifra universal de velocidad, consumo o calidad para cada tipo de equipo. La decisión práctica es comprobar los requisitos del modelo concreto y la compatibilidad de la aplicación, sin asumir que la instalación basta.
También hay costes operativos menos visibles: reservar espacio, obtener versiones nuevas y mantener el entorno. En una instalación administrada, esas tareas recaen en quien mantiene la infraestructura. En un servicio remoto, parte de ese mantenimiento puede corresponder al proveedor, aunque el usuario siga dependiendo de su servicio y conexión. Control y comodidad pueden implicar compromisos distintos, no una jerarquía válida para todos.
Cómo comprobar dónde se procesa una función
Empieza por la documentación oficial del proveedor y busca una explicación referida a la función concreta: ejecución en el dispositivo, procesamiento remoto o modalidad híbrida. Comprueba también si la función requiere descargar un modelo, conectarse a un servidor o activar servicios adicionales. Una descripción general de la aplicación puede no aclarar el comportamiento de cada capacidad.
Los permisos del sistema operativo aportan contexto sobre los accesos que solicita una aplicación, pero no identifican por sí solos el destino de los datos ni dónde se ejecuta un modelo. En Android, por ejemplo, <uses-permission-sdk-23> permite declarar que un permiso se requiere para instalaciones en Android 6.0 (nivel de API 23) o posterior. Esa declaración trata de permisos y compatibilidad, no de demostrar que la IA funcione localmente.
También es útil comprobar si una tarea sigue disponible al desactivar la conexión, pero ese resultado solo informa sobre la necesidad de red en esa circunstancia. No certifica por sí solo qué datos se transmitieron antes, si hay registros ni cómo se comportan otras funciones. Del mismo modo, un indicador de «en el dispositivo» debe leerse junto con la documentación y el alcance exacto al que se refiere.
Una lista breve de comprobación ayuda a evitar conclusiones precipitadas:
- Identifica la función y el modelo, no solo el nombre de la aplicación.
- Busca dónde se ejecuta la inferencia y qué operaciones usan servicios remotos.
- Revisa los requisitos de descarga, actualización y conexión.
- Consulta qué datos se guardan, transmiten o registran, y durante cuánto tiempo.
- Si la respuesta no está documentada, considera la ubicación del procesamiento no confirmada, en vez de inferirla a partir de permisos o mensajes promocionales.