Posicionamiento del DGX Spark en el escritorio
El NVIDIA DGX Spark se presenta como una categoría de ordenador de sobremesa diseñada específicamente para construir y ejecutar modelos de inteligencia artificial. A diferencia de las estaciones de trabajo tradicionales, que combinan una CPU x86 con una GPU discreta, integra ambos componentes en un único superchip. La propuesta busca reducir la barrera que supone transferir datos entre procesador y acelerador, y ofrece una arquitectura coherente para gestionar cargas de trabajo de IA desde un mismo sistema.
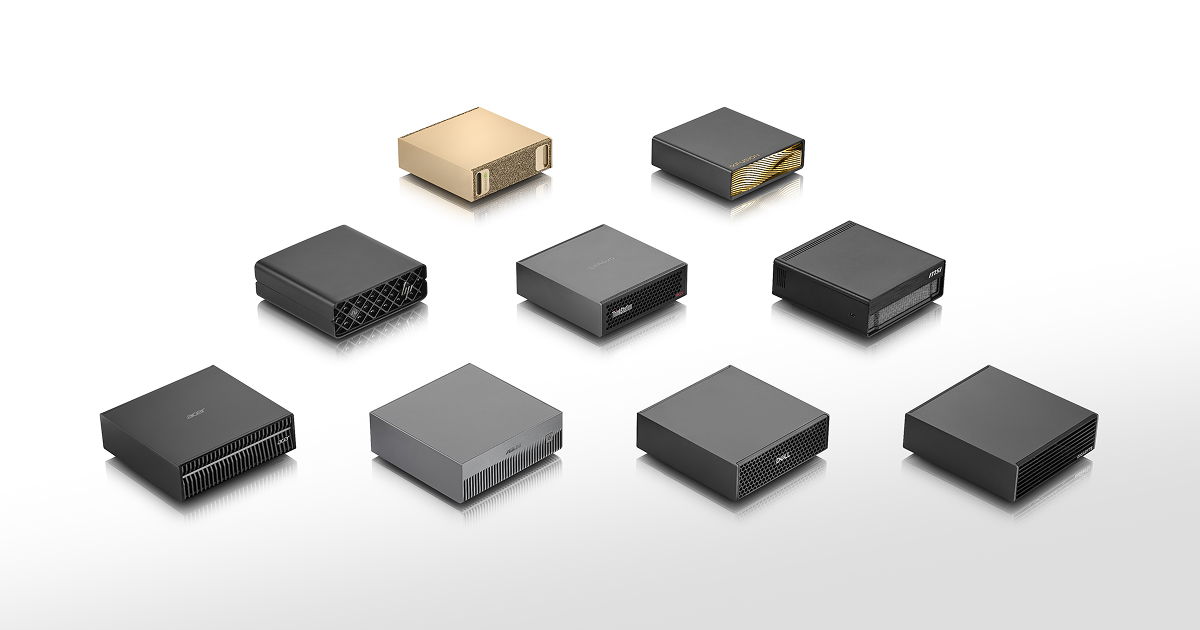
Con unas dimensiones de 150 x 150 x 50.5 mm y un peso de 1.2 kg, su formato compacto permite colocarlo en un escritorio sin recurrir a un chasis torre. NVIDIA lo orienta a desarrolladores que necesitan prototipar, ajustar y ejecutar localmente la inferencia de modelos de hasta 200 mil millones de parámetros. Tener los modelos disponibles en el propio equipo reduce la dependencia de la nube durante el desarrollo y al trabajar con agentes autónomos, aunque no significa que el dispositivo sustituya a cualquier infraestructura de cómputo.
Arquitectura del superchip GB10
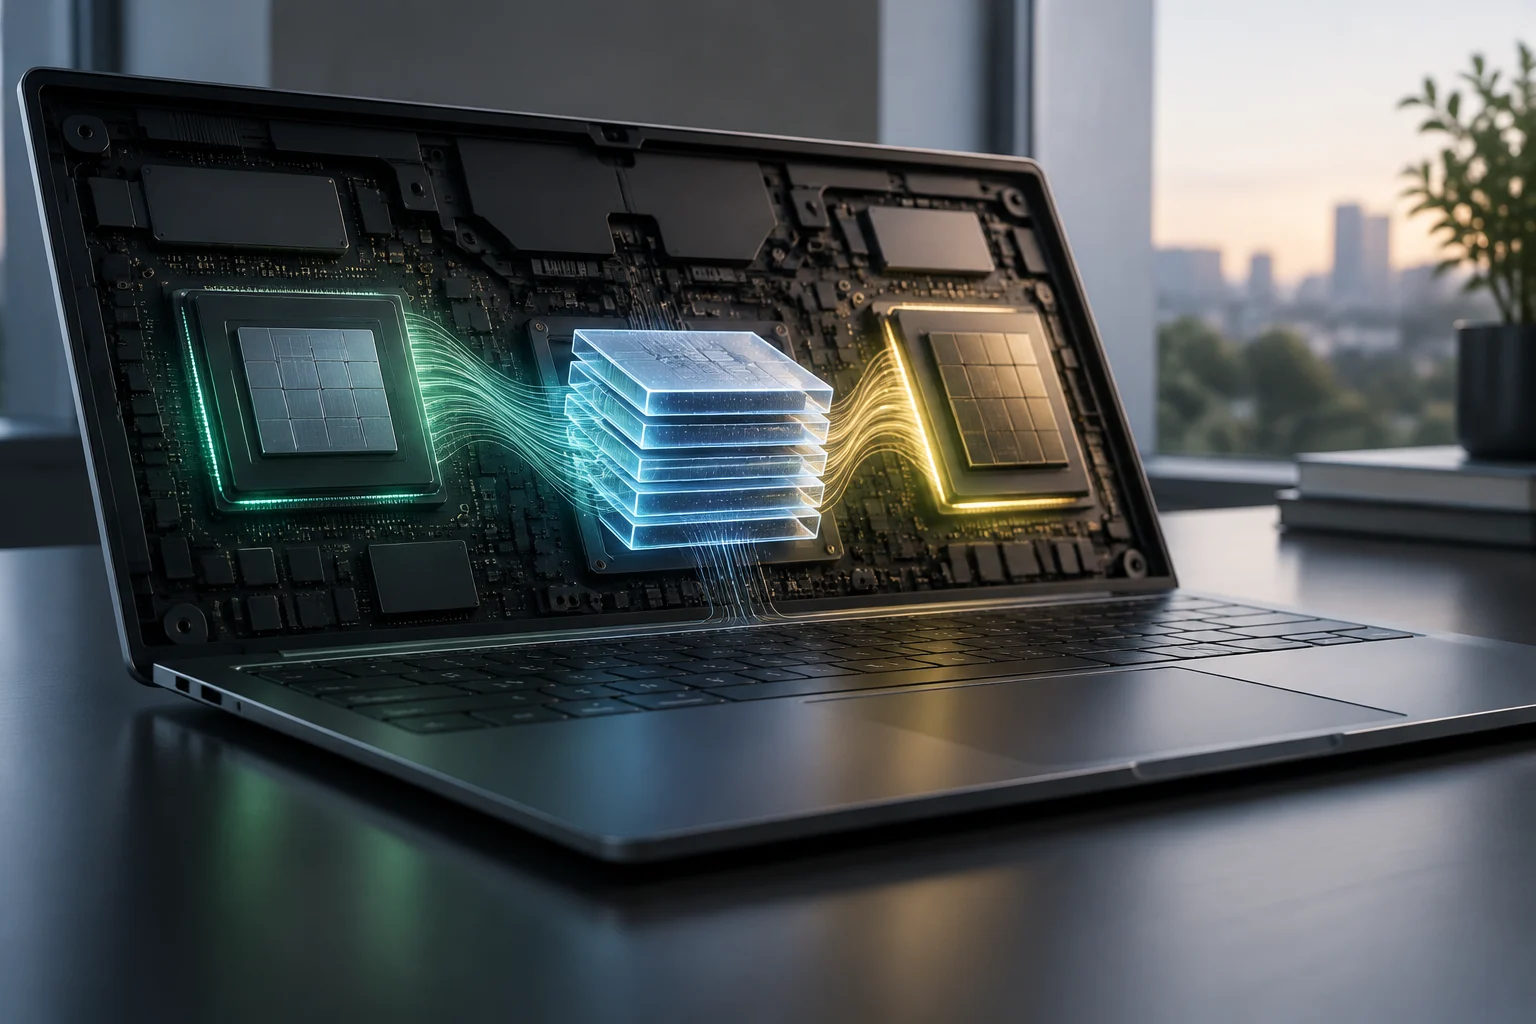
El núcleo del sistema es el superchip GB10 Grace Blackwell, que combina una CPU Arm de 20 núcleos con una GPU Blackwell. La CPU reúne 10 núcleos de alto rendimiento Cortex-X925 y 10 núcleos de eficiencia Cortex-A725; la GPU incorpora Tensor Cores de quinta generación y núcleos RT de cuarta generación. La conexión entre ambos componentes se realiza mediante NVLink-C2C, que permite una comunicación de alta velocidad y contribuye a mantener el flujo de datos entre CPU y GPU.
La memoria es uno de los rasgos más distintivos de esta arquitectura. El sistema cuenta con 128 GB de memoria unificada coherente LPDDR5x, compartida entre la CPU y la GPU sin que sea necesario copiar los datos de una a otra. De este modo, un modelo puede cargarse en la memoria del sistema sin depender únicamente de la VRAM disponible en una GPU discreta, que suele limitarse a 24 o 32 GB. La capacidad no garantiza por sí sola una inferencia rápida, pero permite abordar modelos que no cabrían en esa cantidad de memoria gráfica.
Rendimiento de inferencia y comparativas
En potencia bruta, el DGX Spark ofrece hasta 1 petaFLOP de rendimiento en FP4 con esparsidad. Esa cifra describe capacidad de cálculo bajo una precisión y unas condiciones concretas; no equivale directamente a la velocidad que percibe una persona al generar texto. En inferencia de modelos de lenguaje también importa cuánto tarda el sistema en suministrar los datos que necesita cada operación.
El ancho de banda de memoria, de 273 GB/s compartido entre CPU y GPU, condiciona ese suministro y, por tanto, el ritmo de generación de tokens. La memoria disponible y la velocidad de acceso son medidas distintas: una capacidad alta permite cargar modelos grandes, mientras que el ancho de banda influye en la rapidez con la que se procesan. Por eso, la potencia máxima anunciada no basta para anticipar el rendimiento real de una carga de trabajo.
Los benchmarks independientes indican que, para modelos pequeños, de menos de 20B parámetros, el DGX Spark compite eficazmente con GPU de gama alta. En modelos mayores, la limitación de ancho de banda se hace más visible. En pruebas con GPT-OSS 20B, una RTX 5090 generó 205.5 tokens por segundo, frente a los 60.9 del DGX Spark. La GPU discreta conserva la ventaja en velocidad de decodificación pura, una diferencia relevante cuando la prioridad es obtener respuestas con la menor espera posible.
Limitaciones de memoria y ancho de banda
Aunque los 128 GB permiten cargar modelos cuantizados de hasta 200B parámetros, el ancho de banda de 273 GB/s supone un cuello de botella significativo. Para modelos de más de 30B parámetros, la velocidad de generación de tokens disminuye notablemente. En consecuencia, poder cargar el modelo completo no significa que la interacción vaya a ser tan fluida como en un sistema con mayor ancho de banda de memoria.
Esta limitación está vinculada a la tecnología LPDDR5x, que prioriza la densidad y la eficiencia energética sobre la velocidad de transferencia. El diseño hace posible reunir una gran capacidad de memoria en el sistema, pero esa capacidad y el ritmo al que se leen los datos no escalan de la misma manera. El tamaño del modelo modifica el equilibrio: cuanto más exigente sea la carga, más importante resulta considerar también el acceso a memoria.
Para quienes necesitan inferencia rápida con modelos grandes, el DGX Spark puede no ser la opción ideal, pese a su capacidad para cargar modelos extensos. La elección depende de qué se prioriza: disponer de memoria suficiente para ejecutar el modelo completo o maximizar la velocidad de respuesta. En usos donde la latencia es crítica, las soluciones con más ancho de banda pueden resultar más adecuadas; si prima la capacidad, la memoria unificada ofrece una ventaja distinta.
Viabilidad para cargas de trabajo de IA local
El DGX Spark resulta especialmente útil para el desarrollo de agentes autónomos y otras tareas de inferencia en las que la latencia no es el factor principal. Su capacidad para ejecutar modelos localmente de forma continua puede ser adecuada cuando la privacidad de los datos es prioritaria o cuando no se desea o no se puede acceder a la nube. La utilidad en esos escenarios proviene de mantener la carga en el equipo, no de que la velocidad sea siempre superior a la de una GPU discreta.
La opción de interconectar hasta cuatro unidades mediante ConnectX-7 permite escalar la memoria unificada hasta 512 GB y el rendimiento de IA hasta 4 petaFLOPS. La expansión por unidades ofrece una vía para aumentar los recursos sin pasar directamente a un centro de datos completo. Esto puede hacer que el sistema resulte viable para equipos pequeños que necesitan capacidades de inferencia avanzadas, aunque la conveniencia concreta dependerá de sus modelos y de la importancia que asignen a capacidad y velocidad.
Conclusión y relevancia para 2026
El NVIDIA DGX Spark propone una alternativa de sobremesa a las configuraciones tradicionales de CPU más GPU discreta. Su arquitectura unificada aborda la limitación de capacidad de memoria que puede impedir cargar modelos grandes en una GPU, pero introduce una restricción de ancho de banda que repercute en el rendimiento de esos modelos. Su propuesta se define por ese equilibrio entre poder alojar más datos y procesarlos a una velocidad condicionada por la memoria.
De cara a 2026, el dispositivo se posiciona como una herramienta para desarrolladores que trabajan con modelos de tamaño medio y agentes locales. La decisión de adoptarlo debe considerar tanto la capacidad de memoria necesaria como la velocidad de inferencia que exige cada tarea. Las GPU discretas de gama alta siguen siendo superiores en rendimiento puro de decodificación; por ello, el DGX Spark encaja mejor cuando cargar el modelo localmente y mantener los datos en el equipo pesan más que alcanzar la máxima velocidad.