Definición canónica: qué constituye un sistema de IA
La inteligencia artificial se define como el campo de la informática dedicado a crear sistemas capaces de realizar tareas que tradicionalmente requieren inteligencia humana, como la percepción, el razonamiento, el aprendizaje y la comprensión del lenguaje natural. Esta definición, respaldada por organismos como la Unión Europea y empresas tecnológicas, establece que no se trata de una única tecnología, sino de un conjunto de métodos que permiten a las máquinas procesar información y tomar decisiones.
El Reglamento Europeo de Inteligencia Artificial (AI Act), que entró en vigor en febrero de 2025, ofrece un marco legal para clasificar estos sistemas según su nivel de riesgo. La normativa distingue entre sistemas de propósito general y específicos, estableciendo obligaciones para los proveedores y usuarios. Esta regulación busca garantizar que el desarrollo de la IA sea transparente, seguro y respetuoso con los derechos fundamentales, marcando un estándar global para la industria.
Diferencia con la programación tradicional
A diferencia de un programa tradicional, donde cada regla está preprogramada explícitamente por un desarrollador, un sistema de IA aprende patrones a partir de datos. En la programación clásica, si el criterio cambia, el código debe modificarse manualmente. En la IA, el sistema ajusta sus propios parámetros internos al exponerse a nuevos ejemplos, lo que le permite adaptarse a situaciones que no estaban previstas en su diseño inicial.
Mecanismos de funcionamiento: del dato a la decisión
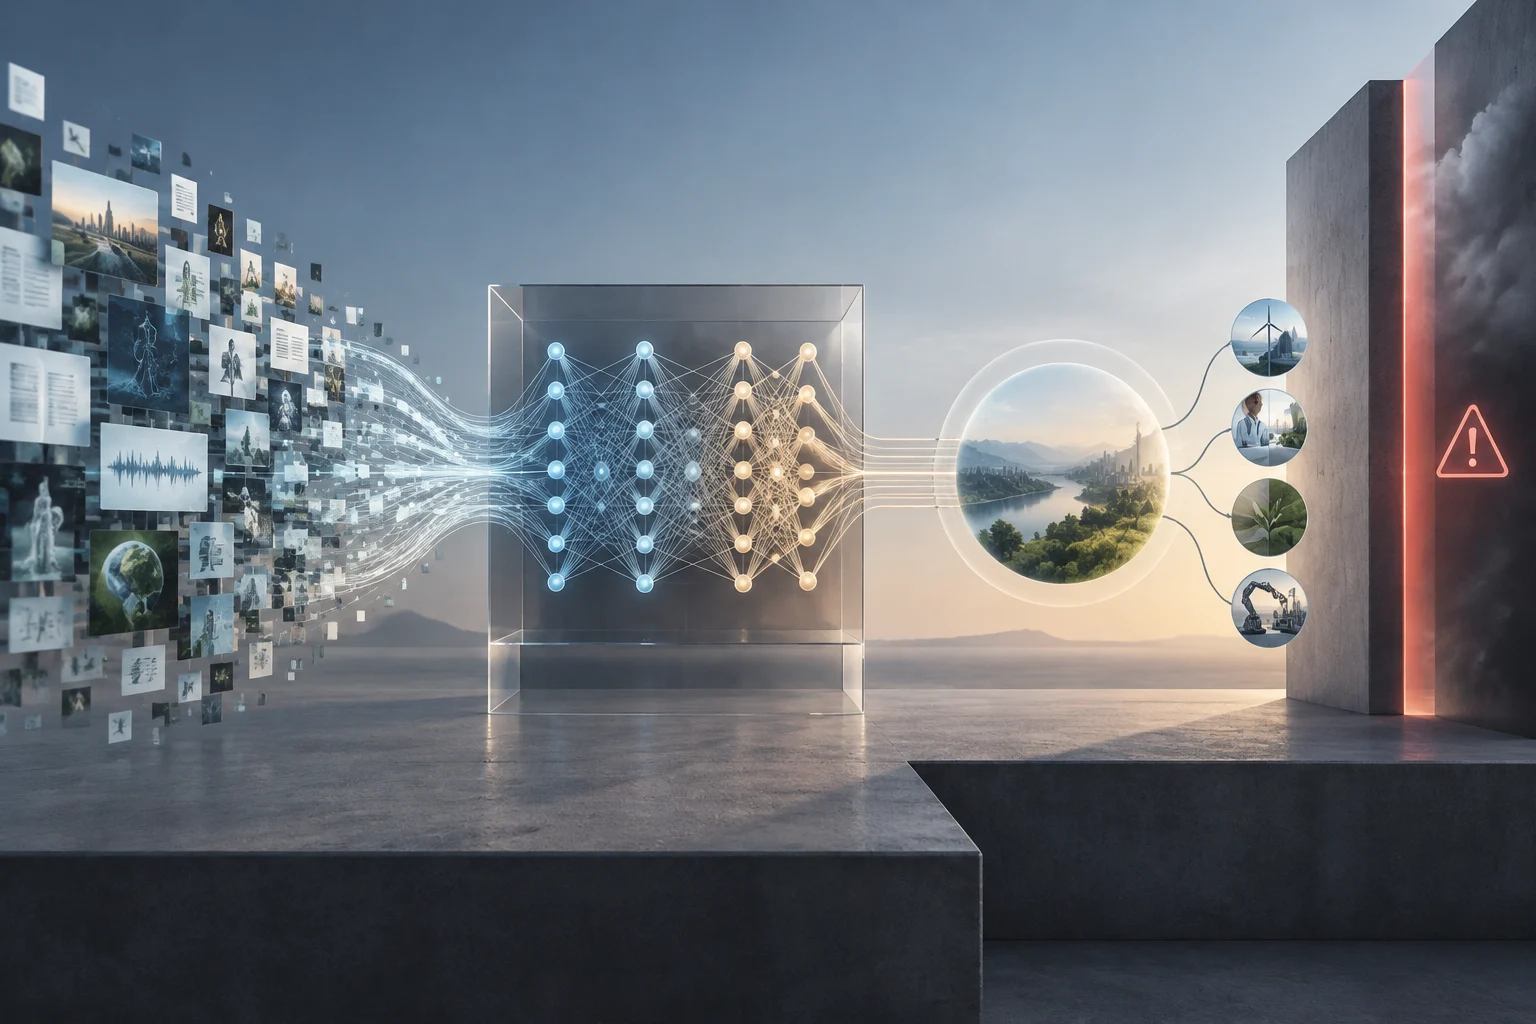
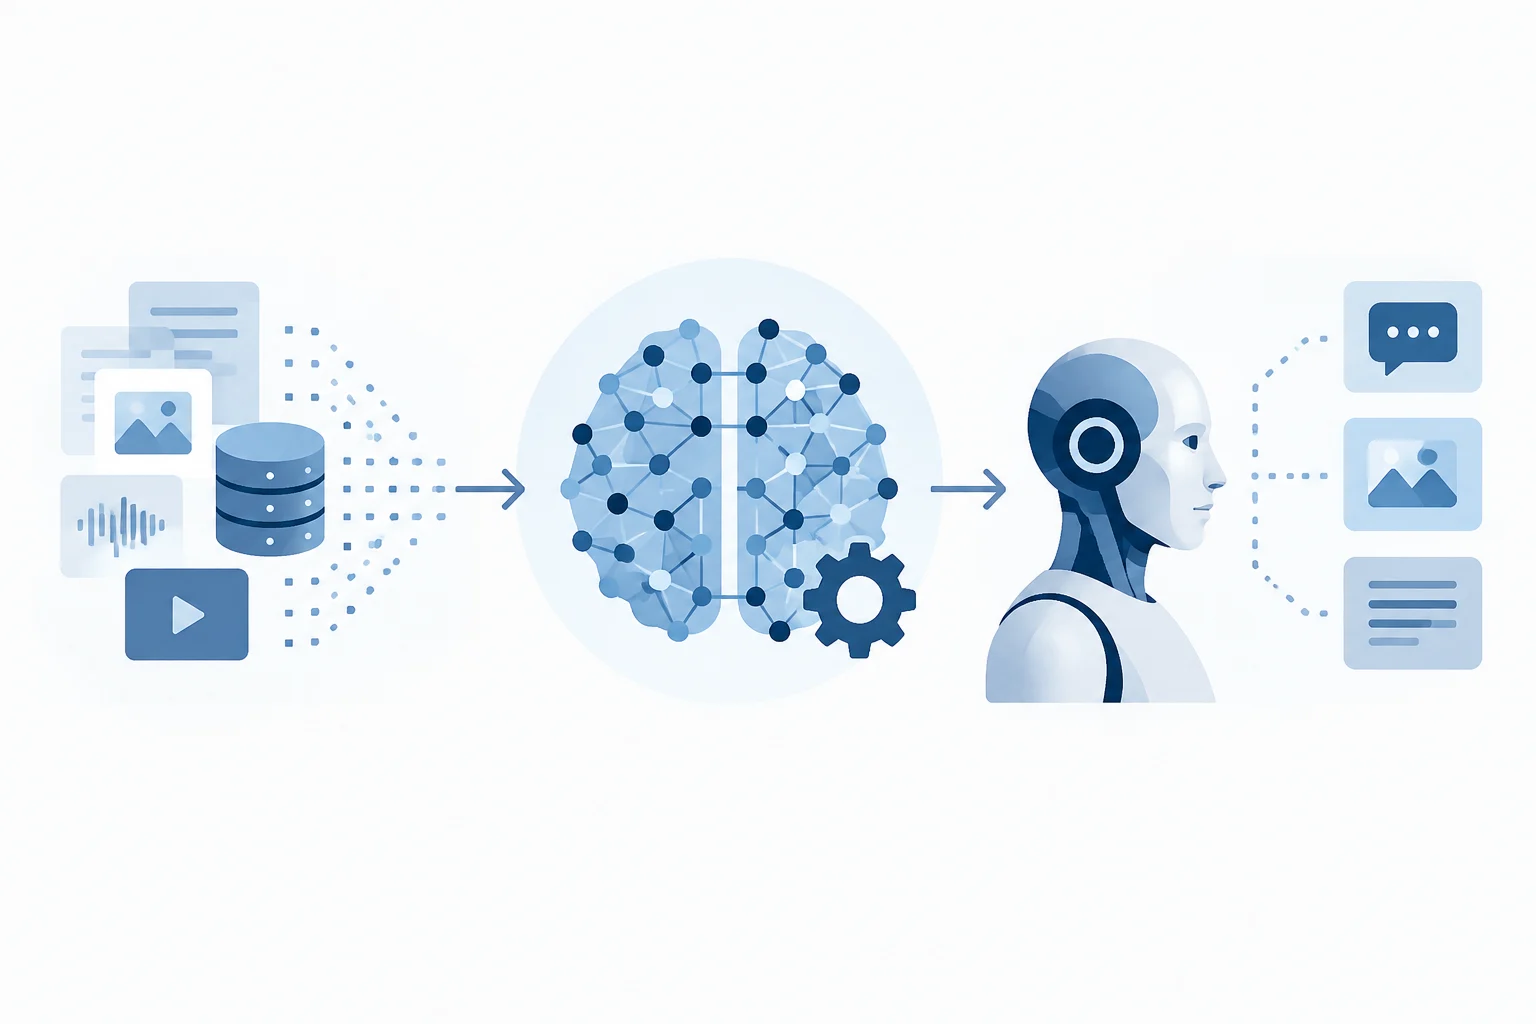
El funcionamiento de un sistema de IA se basa en el aprendizaje automático (machine learning), un subconjunto de la IA donde los sistemas identifican patrones en grandes volúmenes de datos sin ser programados explícitamente para cada caso. El proceso comienza con la recolección de datos, que se utilizan para entrenar un modelo matemático. Este modelo ajusta sus parámetros internos hasta que sus predicciones se alinean con los resultados esperados en el conjunto de datos de entrenamiento.
Una vez entrenado, el modelo entra en la fase de inferencia, que es el momento en que el sistema aplica los patrones aprendidos a nuevos datos para generar una respuesta o decisión. Por ejemplo, un modelo entrenado con imágenes de animales puede identificar una raza de perro en tiempo real, aunque nunca haya visto esa imagen específica antes. La calidad de la inferencia depende directamente de la cantidad y la relevancia de los datos utilizados en el entrenamiento.
El ciclo de vida del modelo
El desarrollo de un sistema de IA sigue un ciclo iterativo que incluye la recolección de datos, el entrenamiento, la validación, el despliegue y la retroalimentación. La validación es crucial para medir la precisión del modelo en datos que no ha visto durante el entrenamiento, evitando el sobreajuste. La retroalimentación permite actualizar el modelo con nuevos datos, mejorando su rendimiento a lo largo del tiempo.
Tipos de aprendizaje automático
Dentro del aprendizaje automático, existen tres enfoques principales que se diferencian por cómo se estructuran los datos y cómo recibe el modelo sus instrucciones. La elección del método depende de la naturaleza del problema y de la disponibilidad de datos etiquetados. Cada enfoque tiene aplicaciones específicas y requisitos distintos en cuanto a la calidad y el volumen de la información de entrada.
La siguiente tabla compara los tres tipos principales de aprendizaje automático, destacando sus características, ejemplos de aplicación y requisitos de datos:
| Tipo de aprendizaje | Descripción | Ejemplo de aplicación | Requisitos de datos |
|---|---|---|---|
| Supervisado | El modelo aprende a partir de datos etiquetados con la respuesta correcta. | Detección de spam en correos electrónicos. | Datos etiquetados (entrada y salida esperada). |
| No supervisado | El modelo identifica patrones o agrupaciones en datos sin etiquetar. | Segmentación de clientes en marketing. | Datos sin etiquetar, grandes volúmenes. |
| Por refuerzo | El modelo aprende mediante ensayo y error, recibiendo recompensas o penalizaciones. | Robots de navegación o juegos de ajedrez. | Entorno simulado o real con feedback continuo. |
El aprendizaje supervisado es el más común en aplicaciones comerciales, ya que permite evaluar la precisión del modelo de manera objetiva. El no supervisado es útil cuando no se conoce la estructura de los datos o se busca descubrir relaciones ocultas. El aprendizaje por refuerzo se emplea en entornos dinámicos donde la acción del agente tiene consecuencias inmediatas que pueden medirse.
IA débil, IA fuerte y IA generativa
El campo de la IA se divide tradicionalmente en dos ramas: la inteligencia artificial débil (o estrecha) y la inteligencia artificial fuerte (o general). La IA débil está diseñada para realizar tareas específicas, como el reconocimiento de voz en un asistente virtual o la recomendación de productos en una plataforma de comercio electrónico. La mayoría de las aplicaciones actuales pertenecen a esta categoría, ya que son más fáciles de desarrollar y evaluar.
La IA fuerte (AGI, por sus siglas en inglés) aspira a emular la inteligencia humana en su totalidad, permitiendo a la máquina razonar, adaptarse y aprender de manera similar a una persona. Este tipo de IA aún se encuentra en fase de investigación y no ha sido alcanzado por ningún sistema comercial. La distinción es importante para evitar expectativas irreales sobre las capacidades actuales de la tecnología.
IA generativa vs. IA analítica
En los últimos años, ha cobrado protagonismo la IA generativa, un subconjunto de la IA que crea contenido nuevo (texto, imágenes, código) a partir de los patrones aprendidos. A diferencia de la IA analítica, que clasifica o predice, la IA generativa produce salidas creativas. Modelos como GPT-4 de OpenAI son ejemplos de IA generativa, utilizados para redactar textos, generar código o crear imágenes. Esta capacidad ha ampliado el alcance de la IA en sectores creativos y de desarrollo de software.
Usos prácticos y ejemplos explicados
La inteligencia artificial se aplica en diversos sectores, desde la salud hasta la industria. En el ámbito médico, los sistemas de IA ayudan en el diagnóstico por imagen, analizando radiografías o resonancias para detectar anomalías que podrían pasar desapercibidas por el ojo humano. Estos sistemas no reemplazan al médico, sino que actúan como una herramienta de apoyo que agiliza el proceso y reduce la carga de trabajo.
En el sector financiero, la IA se utiliza para la detección de fraude, analizando transacciones en tiempo real para identificar patrones sospechosos. En el comercio electrónico, los motores de recomendación sugieren productos basándose en el historial de compras y el comportamiento del usuario. En la industria, la IA optimiza la cadena de suministro, predice fallos en maquinaria y automatiza procesos de control de calidad.
Ejemplo: diagnóstico médico
Un sistema de IA entrenado con miles de imágenes de retinas puede detectar signos de diabetes o glaucoma con una precisión comparable a la de un especialista. El modelo analiza la imagen y genera una probabilidad de enfermedad, que el médico revisa y confirma. Este enfoque permite escalar la capacidad de diagnóstico en zonas con escasez de especialistas, mejorando el acceso a la atención sanitaria.
Límites, riesgos y la necesidad de supervisión
A pesar de sus ventajas, la IA presenta riesgos significativos que deben gestionarse. Uno de los más destacados es la alucinación, fenómeno por el cual un modelo generativo inventa información que no existe o es incorrecta, presentándola con la misma confianza que los datos reales. Esto ocurre porque el modelo predice la siguiente palabra o elemento más probable, sin verificar la veracidad de la información.
Otro riesgo importante es el sesgo en los datos de entrenamiento. Si los datos utilizados para entrenar un modelo no son representativos de la población objetivo, las recomendaciones del sistema pueden favorecer o perjudicar a ciertos grupos. Por ejemplo, un modelo de contratación entrenado con datos históricos sesgados puede perpetuar la discriminación de género o raza. La supervisión humana es imprescindible para detectar y corregir estos sesgos.
Dependencia y desvanecimiento del juicio
La confianza excesiva en los sistemas de IA puede llevar a la dependencia tecnológica, donde los profesionales adoptan las sugerencias del sistema sin revisarlas críticamente. Esto es especialmente preocupante en sectores críticos como la salud o la justicia, donde un error puede tener consecuencias graves. La formación de los usuarios y la implementación de protocolos de verificación son esenciales para mitigar este riesgo.
Glosario básico de términos clave
Para comprender la IA, es útil familiarizarse con algunos términos técnicos. Un modelo es la representación matemática que el sistema utiliza para hacer predicciones. Un dataset (conjunto de datos) es la colección de información con la que se entrena al modelo. La inferencia es el proceso de aplicar el modelo entrenado a nuevos datos para obtener una respuesta.
El entrenamiento es la fase en la que el modelo ajusta sus parámetros para minimizar el error en los datos de entrenamiento. La validación es el proceso de evaluar el modelo con datos que no ha visto durante el entrenamiento, para medir su capacidad de generalización. El sobreajuste ocurre cuando el modelo memoriza los datos de entrenamiento en lugar de aprender patrones generales, lo que reduce su rendimiento en datos nuevos.
Importancia de la calidad de los datos
La calidad de los datos es determinante para el éxito de un sistema de IA. Datos incompletos, ruidosos o sesgados pueden llevar a modelos inexactos o injustos. La gobernanza de datos implica establecer procesos para garantizar la calidad, la privacidad y la seguridad de la información utilizada en el entrenamiento y la inferencia. Sin una base de datos sólida, incluso el algoritmo más avanzado no podrá funcionar correctamente.