Que signifie concevoir un processeur à chiplets ?
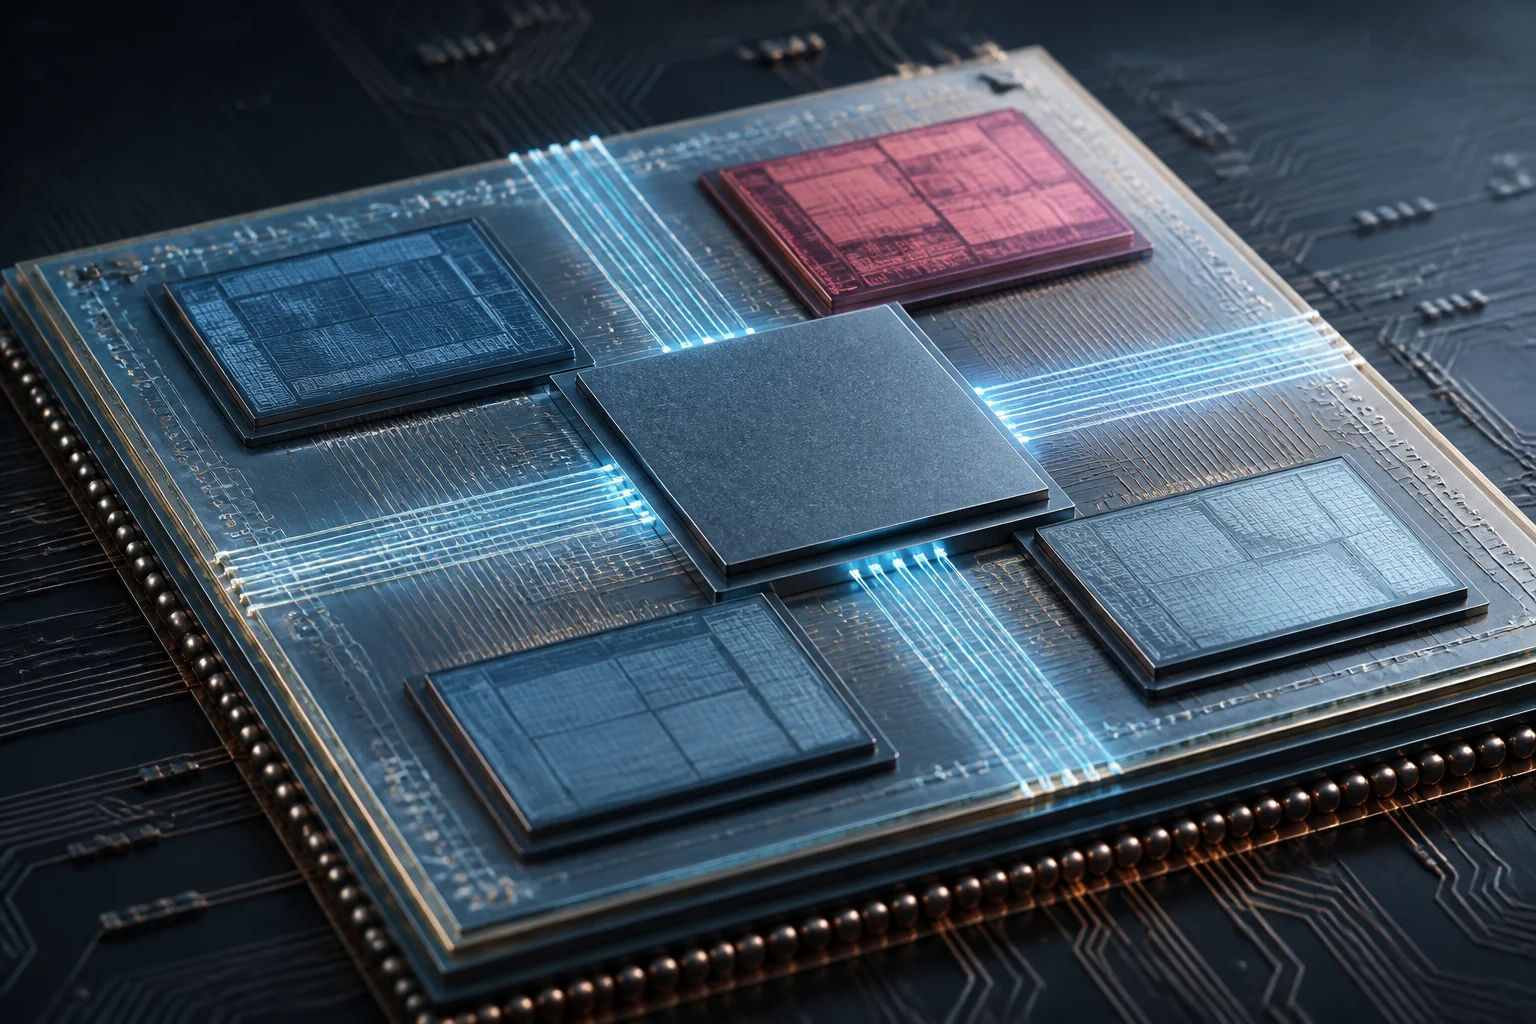
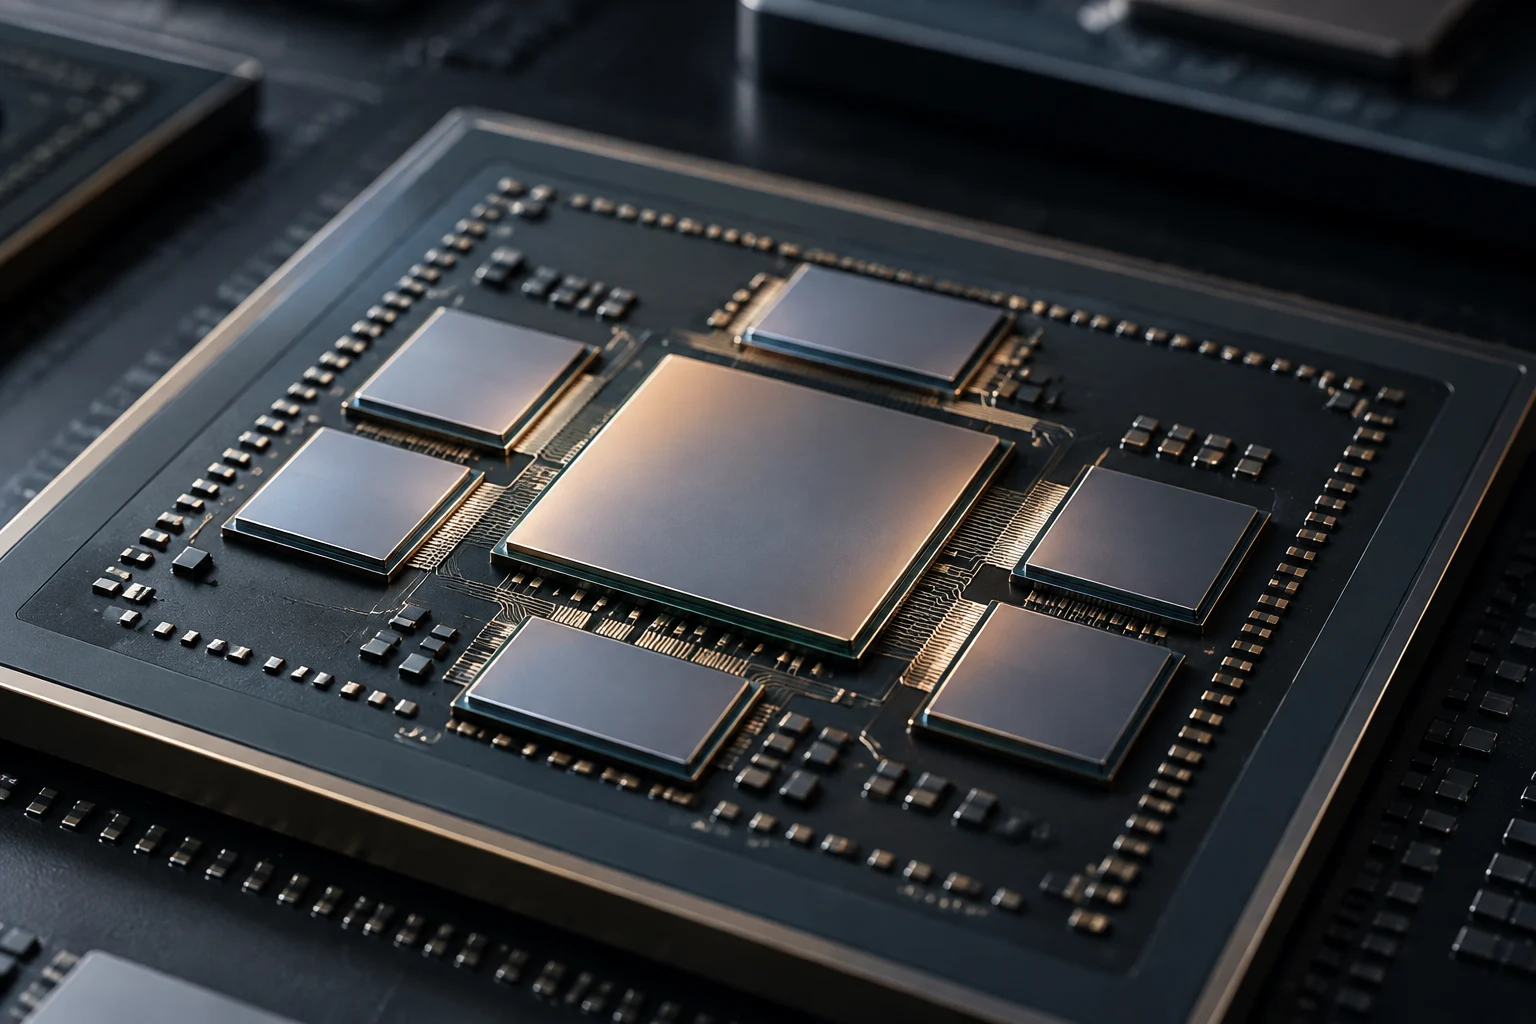
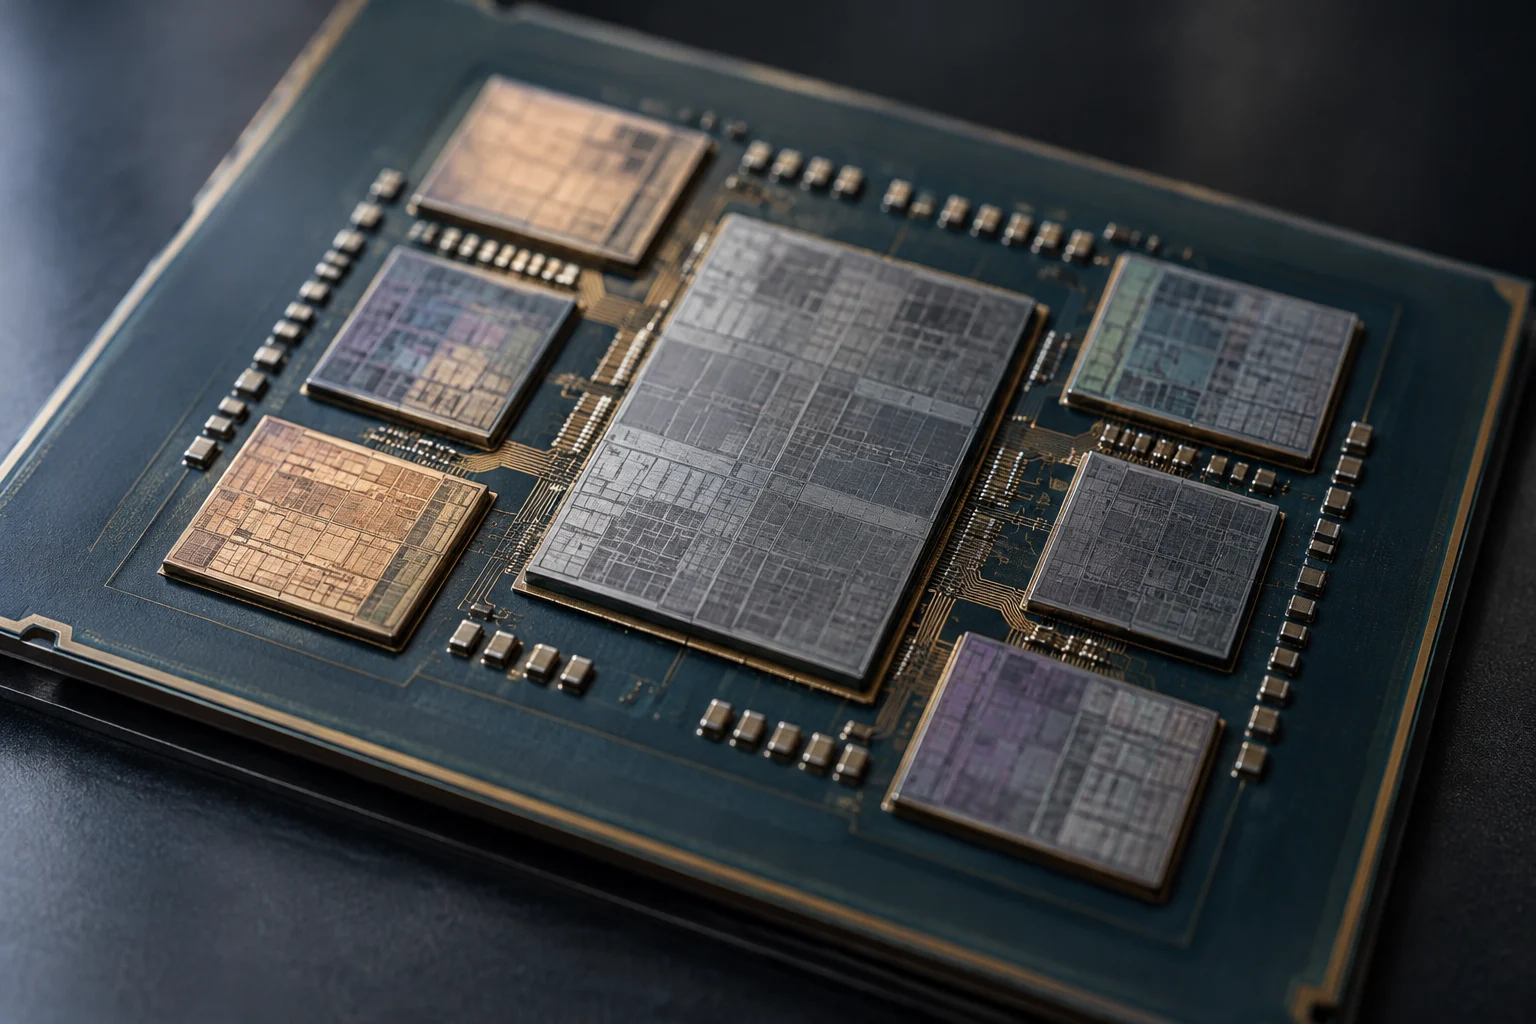
Un processeur à chiplets réunit plusieurs blocs de silicium — les dies — au sein d’un même boîtier. Au lieu d’intégrer nécessairement tous les cœurs, les caches et les fonctions d’entrée-sortie sur une seule puce, le fabricant répartit certaines tâches entre plusieurs composants connectés. L’organisation physique du processeur est ainsi modulaire, même si ses blocs sont réunis dans un même boîtier.
La distinction essentielle concerne le boîtier complet et chaque puce. Un chiplet ne constitue pas à lui seul un processeur fini : il lui faut un substrat ou une structure de packaging, des connexions électriques et des mécanismes pour échanger des données et de l’énergie avec les autres composants. La répartition varie selon l’architecture ; elle peut séparer le calcul et les entrées-sorties, ou associer des blocs de calcul à d’autres fonctions.
La modularité ne signifie pas non plus que toutes les pièces sont interchangeables. Une conception peut réutiliser des blocs internes ou combiner des technologies de fabrication, mais les chiplets doivent être compatibles avec une architecture, une interface et une méthode d’assemblage. Il s’agit de décomposer la conception de manière maîtrisée, et non d’assembler un processeur comme des composants indépendants de carte mère.
Pourquoi séparer les blocs de silicium ?
Une grande puce monolithique peut être difficile à fabriquer : si un défaut touche une zone, il risque de rendre inutilisable une pièce entière. Des puces plus petites peuvent réduire l’impact de certains défauts et permettre au fabricant de combiner plusieurs blocs pour créer différentes configurations. C’est une possibilité de conception et de fabrication, pas une garantie que chaque processeur obtenu coûtera moins cher.
Il est aussi possible d’attribuer des fonctions à différents procédés de fabrication. Les blocs de calcul, qui peuvent tirer parti d’une technologie plus avancée, n’ont pas nécessairement à partager le même procédé que les circuits d’entrée-sortie ou d’autres fonctions moins sensibles à la densité des transistors. Cette séparation peut favoriser la réutilisation des conceptions et éviter de transférer tous les composants vers le nœud le plus coûteux ; en contrepartie, elle impose de valider les interactions entre des pièces conçues et fabriquées séparément.
La documentation technique d’Intel décrit la désagrégation comme un moyen de combiner des chiplets et des nœuds de fabrication, et indique que la taille et la fonction des blocs sont choisies en tenant compte des performances, de la surface et de la fabrication. Le coût final dépend de l’ensemble : nombre et taille des puces, rendement de fabrication, tests avant assemblage, packaging et volume de production. La présence de chiplets ne suffit donc pas à conclure que le coût de production sera inférieur.
Le packaging fait aussi partie de l’architecture
Lorsque plusieurs puces partagent un boîtier, leur mode de connexion détermine une grande partie des possibilités de conception. Certaines solutions placent les chiplets côte à côte et utilisent des ponts ou des interposeurs ; d’autres empilent les puces verticalement. Chaque option impose des contraintes différentes en matière d’espace, de densité des connexions, de dissipation thermique et de fabrication. Le boîtier n’est plus une enveloppe passive : il participe à la conception du système.
Les interconnexions doivent transporter suffisamment de données sans consommer trop d’espace ni d’énergie. Elles ajoutent également des trajets et des limites physiques : la communication entre blocs n’est pas identique à celle qui se déroule au sein d’une même puce. La distance, le type de liaison ainsi que l’organisation des caches et des contrôleurs peuvent influer sur la latence. Il n’existe pas de pénalité universelle applicable à tous les processeurs à chiplets, car elle dépend de leur mise en œuvre.
La documentation d’Intel présente des technologies comme EMIB et Foveros pour relier des puces dans des configurations 2,5D et 3D. Ce sont des exemples d’approches industrielles, et non des mesures comparatives des performances des processeurs. Une densité de connexion supérieure n’implique pas automatiquement un processeur plus rapide : l’avantage dépend des données qui traversent la liaison, de leur fréquence et des ressources disponibles dans le reste du système.
Interconnexion, mémoire et cohérence
Les blocs de calcul doivent communiquer avec les caches, la mémoire et les fonctions d’entrée-sortie. Dans certaines architectures, les contrôleurs mémoire et les connexions externes se trouvent sur une puce distincte ; dans d’autres, l’organisation diffère. L’emplacement de ces éléments détermine le parcours des données et les blocs qui partagent des ressources. Le nombre de chiplets ou de cœurs ne suffit donc pas à décrire l’architecture.
L’interconnexion transporte les données entre les blocs et peut également acheminer des informations de contrôle. Sa capacité et le protocole utilisé conditionnent les échanges entre puces ; si la communication limite le flux de données, ajouter des unités de calcul ne garantit pas une amélioration proportionnelle dans les tâches qui exigent un échange rapide des résultats. Les performances dépendent de la mise en œuvre.
UCIe est une norme d’interconnexion entre chiplets à l’intérieur d’un boîtier. Elle vise à définir une interface commune pour faciliter les conceptions modulaires et l’interopérabilité. Son existence ne signifie toutefois pas que n’importe quel chiplet de n’importe quel fournisseur peut être combiné avec un autre sans adaptation : les mises en œuvre, les protocoles et les choix d’architecture doivent être compatibles. L’interopérabilité est un objectif de conception, soumis aux contraintes techniques et commerciales de chaque produit.
Performances, coût et consommation : que peut-on en déduire ?
L’architecture permet de formuler des hypothèses, mais ne remplace pas les mesures. La séparation des blocs peut faciliter l’augmentation du nombre d’unités de calcul ou l’adaptation de la fabrication, mais les performances observées dépendent aussi des fréquences, du cache, de la mémoire, des limites thermiques, de la consommation et des charges de travail. Une configuration comportant davantage de puces peut être meilleure dans les tâches parallèles sans se distinguer dans celles où la latence ou les performances d’un petit nombre de cœurs sont déterminantes.
La même prudence s’applique aux performances par watt. Une liaison entre chiplets consomme de l’énergie, et le boîtier doit répartir la puissance et évacuer la chaleur. En parallèle, une architecture modulaire peut permettre de placer chaque fonction de façon appropriée et d’éviter de fabriquer tous les composants avec le procédé le plus avancé. Le bilan se fait à l’échelle du produit complet, et non en comptant simplement ses blocs.
Pour comparer des processeurs, il est préférable d’utiliser des tests portant sur les mêmes tâches, dans des configurations et des conditions comparables, et d’observer à la fois les performances et la consommation du système. L’architecture peut aider à expliquer les différences entre deux produits, mais elle ne permet pas de déduire un avantage général sans résultats mesurés. Le nombre de cœurs ou de chiplets donne du contexte, mais ne remplace pas les tests.
Logiciels et évolutivité
La conception du processeur et le logiciel déterminent la façon dont les fils d’exécution sont répartis sur les cœurs disponibles. L’application doit aussi offrir suffisamment de parallélisme pour exploiter plusieurs cœurs : ajouter des ressources ne transforme pas automatiquement une tâche séquentielle en tâche parallèle.
Sur un ordinateur grand public, l’exécution dépend du processeur, du système d’exploitation et des logiciels, ainsi que du modèle et de la charge de travail. L’évolutivité utile dépend de la tâche, pas seulement de l’ajout de ressources.
Pour choisir un produit, l’étiquette « chiplet » ne devrait pas faire oublier les critères pratiques : performances dans les applications utilisées, consommation, température, prix, compatibilité de la plateforme et résultats de tests indépendants. Dans une fiche technique, le nombre de puces est un indice sur l’organisation interne, pas un classement direct de la qualité.
Que surveiller dans les prochaines générations ?
Les technologies de packaging et les normes de liaison aident à comprendre comment sont construits les systèmes comportant plusieurs puces. La documentation industrielle présente des interconnexions 2,5D et 3D ainsi que des propositions d’interfaces die-to-die comme UCIe. Ce sont des éléments d’architecture, pas la preuve que tous les fabricants adopteront le même schéma ou que la prochaine génération sera nécessairement plus rapide ou plus efficace.
Pour évaluer une annonce, trois questions sont utiles : quelles fonctions ont été séparées ; quelle technologie relie les puces et comment la mémoire et le cache sont organisés ; enfin, quels tests du produit montrent les effets sur des applications réelles ? Il convient aussi de distinguer une norme publiée de sa mise en œuvre concrète, et une capacité annoncée d’un résultat mesuré. Cette approche évite de confondre intégration accrue et amélioration automatique.
La conception à chiplets élargit les possibilités de fabrication et d’organisation des processeurs, mais transfère une partie de la complexité vers l’interconnexion, le packaging et la coordination du système. Sa valeur se vérifie pour chaque produit : la modularité et la flexibilité peuvent constituer de réels avantages, tandis que le coût, les performances et la consommation doivent être évalués selon la mise en œuvre concrète.