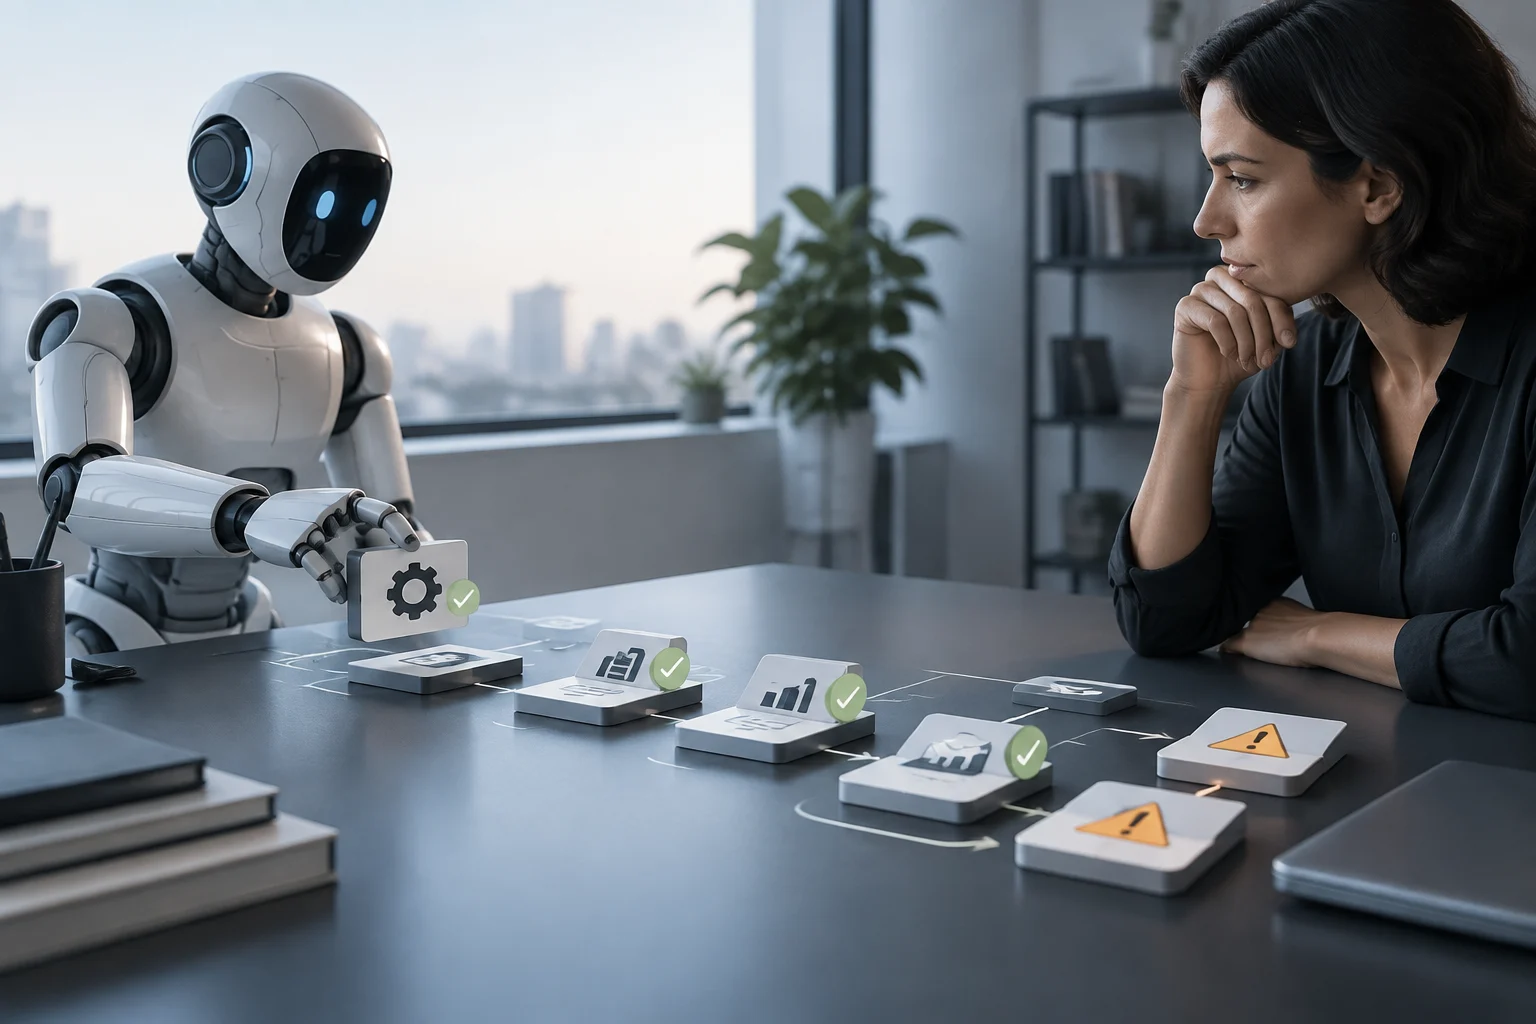
De l’automatisation classique aux agents d’IA
De manière générale, l’automatisation consiste à utiliser la technologie pour effectuer des tâches en réduisant l’intervention manuelle. Dans ses formes les plus familières, une règle prédéfinie déclenche une action déterminée : par exemple, déplacer des données entre des systèmes lorsqu’une condition est remplie. L’intelligence artificielle élargit ce champ en permettant de travailler avec des instructions en langage naturel et des entrées moins structurées. Cela ne signifie toutefois pas que tous les processus peuvent être automatisés de façon fiable. La tâche, les informations disponibles et la configuration du système influent sur ce qu’il peut accomplir. IBM décrit l’automatisation comme l’application de la technologie à la réalisation de tâches avec peu d’intervention humaine.
Dans le contexte de l’IA, un agent peut associer un modèle, des instructions et des outils pour avancer vers un objectif. La documentation d’OpenAI présente les agents comme des systèmes capables d’utiliser des outils et de coordonner plusieurs étapes, plutôt que de se limiter à produire une réponse textuelle. La différence pratique est qu’une réponse informe, tandis qu’une action peut modifier des données ou déclencher des processus. Évaluer une fonctionnalité suppose donc d’examiner à la fois ce que le modèle génère et les opérations qu’il est autorisé à effectuer. Une réponse fluide ne prouve pas, à elle seule, que le système a la permission d’agir ; inversement, la disponibilité d’outils ne garantit pas qu’une action sera appropriée ou correcte. OpenAI documente les agents et les outils dans son guide destiné aux développeurs.
Quelles tâches pourraient être déléguées
Dans une application réelle, les tâches qui s’y prêtent sont souvent bien délimitées : résumer des informations, classer des demandes, préparer des brouillons ou enchaîner des étapes courantes entre différents outils. Ce sont des exemples d’usages possibles, et non la garantie qu’une fonction particulière les permet ou les exécutera correctement. Les capacités réelles dépendent de l’intégration, des informations disponibles et des actions autorisées par la personne qui configure le système. La documentation d’OpenAI sur les agents décrit l’utilisation d’outils dans ces flux, mais ne constitue pas une certification universelle des résultats. Une tâche qui semble simple en théorie peut rester inadaptée si ses données d’entrée sont incomplètes ou si son résultat est difficile à vérifier.
Il est utile de distinguer la préparation d’une action de son exécution. Un système peut produire un brouillon qu’une personne examinera sans avoir l’autorisation de l’envoyer, ou consulter des informations sans pouvoir les modifier. Cette distinction peut réduire les conséquences d’une interprétation erronée et permettre de commencer par des tâches à moindre risque. Avant toute délégation, précisez le résultat attendu, repérez les outils concernés et décidez de la conduite à tenir si des informations manquent ou si une instruction est ambiguë. Ces décisions délimitent mieux la tâche ; elles ne garantissent pas une exécution sans erreur.
Autorisations et points de contrôle
Le périmètre de l’automatisation ne dépend pas uniquement du modèle : il dépend aussi des outils connectés et des autorisations qui leur sont associées. Une intégration permettant d’écrire, d’envoyer ou de supprimer des données peut avoir des conséquences différentes de celles d’un outil en lecture seule. Le guide d’OpenAI situe les outils dans l’architecture des agents ; cela conduit à une décision opérationnelle importante : n’accorder que les capacités nécessaires à la tâche. Il s’agit d’une recommandation de conception, et non de l’affirmation que tous les produits mettent en œuvre les mêmes contrôles. Il faut vérifier les autorisations et les contrôles disponibles dans le logiciel concerné et dans le processus où il sera utilisé.
Pour les processus sensibles, une vérification humaine avant une action externe peut servir de garde-fou. Il peut également être utile de limiter le flux à des étapes réversibles ou d’exiger une confirmation lorsqu’une information importante doit être modifiée. La supervision doit se situer là où une erreur aurait des conséquences, au lieu de se réduire à la vérification d’un échantillon en fin de processus. La configuration précise dépend du logiciel et du processus ; les sources citées ne proposent aucune règle unique garantissant la sécurité dans tous les cas. Un point de contrôle n’est utile que si une personne peut comprendre l’action proposée et a la possibilité concrète de l’approuver, de la refuser ou de la corriger avant l’étape qui entraîne des conséquences.
Fiabilité : mesurer le processus, pas la promesse
Une démonstration isolée ne permet pas de savoir si une automatisation fonctionnera de façon constante. Pour évaluer une tâche, il faut définir à l’avance ce qui constitue une réussite, tester les situations habituelles et exceptionnelles, puis consigner les erreurs, les omissions et les corrections. Cette évaluation doit avoir lieu dans l’environnement prévu et avec des données adaptées. On ne peut pas la déduire d’une description commerciale ni de la simple existence d’une fonctionnalité d’agent. Les tests doivent reproduire le flux de travail effectivement envisagé, plutôt qu’une version plus facile qui omet des étapes ou des conditions pertinentes.
La documentation technique aide à comprendre les capacités annoncées, mais ne constitue pas une évaluation indépendante des performances. Par exemple, un échange d’assistance sur Microsoft Q&A au sujet de l’automatisation du navigateur dans Azure rapporte la question d’un utilisateur concernant une sortie vide ; de par sa nature, il ne suffit pas à conclure sur le comportement général du service. Le fil Microsoft Q&A est un cas individuel, et non une étude systématique. Pour décider, il importe de tester le flux réel et de comparer les résultats à une procédure manuelle ou à une référence vérifiée. Cette comparaison doit porter sur les résultats qui comptent pour la tâche, y compris les omissions et les corrections nécessaires, plutôt que de considérer la fin sans incident d’une exécution comme une preuve de fiabilité.
Risques, données et limites des éléments disponibles
La délégation de tâches peut exposer des informations à des outils externes ou entraîner des changements indésirables si les instructions, le contexte ou les autorisations ne sont pas clairement délimités. La gestion des accès, la vérification des résultats et la possibilité d’arrêter ou d’annuler des actions doivent être examinées pour chaque déploiement. Il ne faut pas supposer qu’un agent saura toujours distinguer une instruction légitime d’une entrée trompeuse, ni que sa réponse est correcte simplement parce que le flux s’est terminé sans erreur technique. Un processus peut s’achever comme prévu tout en produisant un résultat inadapté : la fin technique et la réussite de la tâche ne sont donc pas équivalentes.
Les documents consultés permettent de décrire des concepts et des orientations de mise en œuvre, mais ne confirment ni annonce récente ni capacité précise récemment lancée. Ils ne fournissent pas non plus de comparaison indépendante de la précision entre produits ni suffisamment de données pour quantifier les économies ou les taux d’erreur. Cet article est donc un guide d’évaluation, et non une actualité portant sur une évolution de produit. Cette limite compte pour interpréter la portée du propos : toute affirmation concernant une fonctionnalité particulière doit être vérifiée dans la documentation à jour de son fournisseur. Des conseils généraux sur les agents ne permettent pas d’établir le comportement, les mesures de protection ou les performances mesurées de chaque service.
Liste pratique avant d’automatiser
Avant de confier une tâche à un agent, il est utile de répondre à quelques questions précises. Les réponses aident à définir le résultat visé et à examiner plus clairement le périmètre, les actions et les vérifications envisagés. Elles fournissent aussi aux personnes responsables du processus une base pour décider s’il faut le tester, conserver une approbation humaine ou maintenir une exécution manuelle. Avant d’accorder l’accès aux outils ou de mettre le flux en service, posez-vous les questions suivantes :
- Quel résultat vérifiable doit-il produire, et quels cas sont hors périmètre ?
- Quelles informations consultera-t-il, et quelles actions pourra-t-il effectuer ?
- Quelles opérations nécessitent une approbation humaine, et comment une erreur sera-t-elle corrigée ?
- Comment le flux sera-t-il testé avec des cas normaux, exceptionnels et des données sensibles ?
- Qui examinera les résultats et décidera d’étendre, de modifier ou de retirer l’automatisation ?
Commencez par une tâche délimitée et à faible impact, conservez une solution manuelle et n’élargissez le périmètre que si les tests et les contrôles le justifient. La question utile n’est pas de savoir si l’IA peut automatiser en théorie, mais si une tâche précise peut l’être avec des autorisations, une supervision et des critères de réussite adaptés. Cette décision doit s’appuyer sur le flux de travail réel et sur les éléments issus de ses tests, et non uniquement sur une description générale des agents ou une démonstration de ce qu’un outil sait faire.