Choisir une tâche adaptée pour commencer
Commencez par une tâche fréquente et bien délimitée, dont le résultat est facile à vérifier, comme la préparation de réponses à des questions courantes. L’automatisation classique convient mieux lorsque les entrées, les règles et les résultats sont définis. Si le travail nécessite d’interpréter un texte ou de produire une réponse adaptée au contexte, l’IA générative peut intervenir à cette étape.
Avant de connecter des outils, notez le déroulement actuel, les informations nécessaires à chaque étape et les risques possibles. Évaluez les conséquences possibles d’une erreur et choisissez, pour un premier essai, un processus où elle est réversible et peut être repérée par une personne avant d’affecter quelqu’un.
Écartez les tâches qui impliquent des décisions sensibles, un accès étendu à des données personnelles ou des actions irréversibles. Le but initial n’est pas d’automatiser le processus de bout en bout, mais d’isoler une petite étape dont le résultat peut être vérifié. Si vous ne pouvez pas décrire ce qui constitue une réponse acceptable, vous ne disposez pas encore d’un critère d’évaluation clair pour le flux.
Distinguer les règles de la génération
Décomposez le travail en étapes et affectez à chacune l’outil le plus adapté. Des règles fixes peuvent détecter l’arrivée d’un message, enregistrer une entrée ou l’orienter vers une boîte donnée. L’IA générative peut résumer le texte, repérer le sujet probable ou préparer une réponse en langage naturel. Confiez les étapes prévisibles aux règles et réservez le modèle à l’interprétation ou à la rédaction.
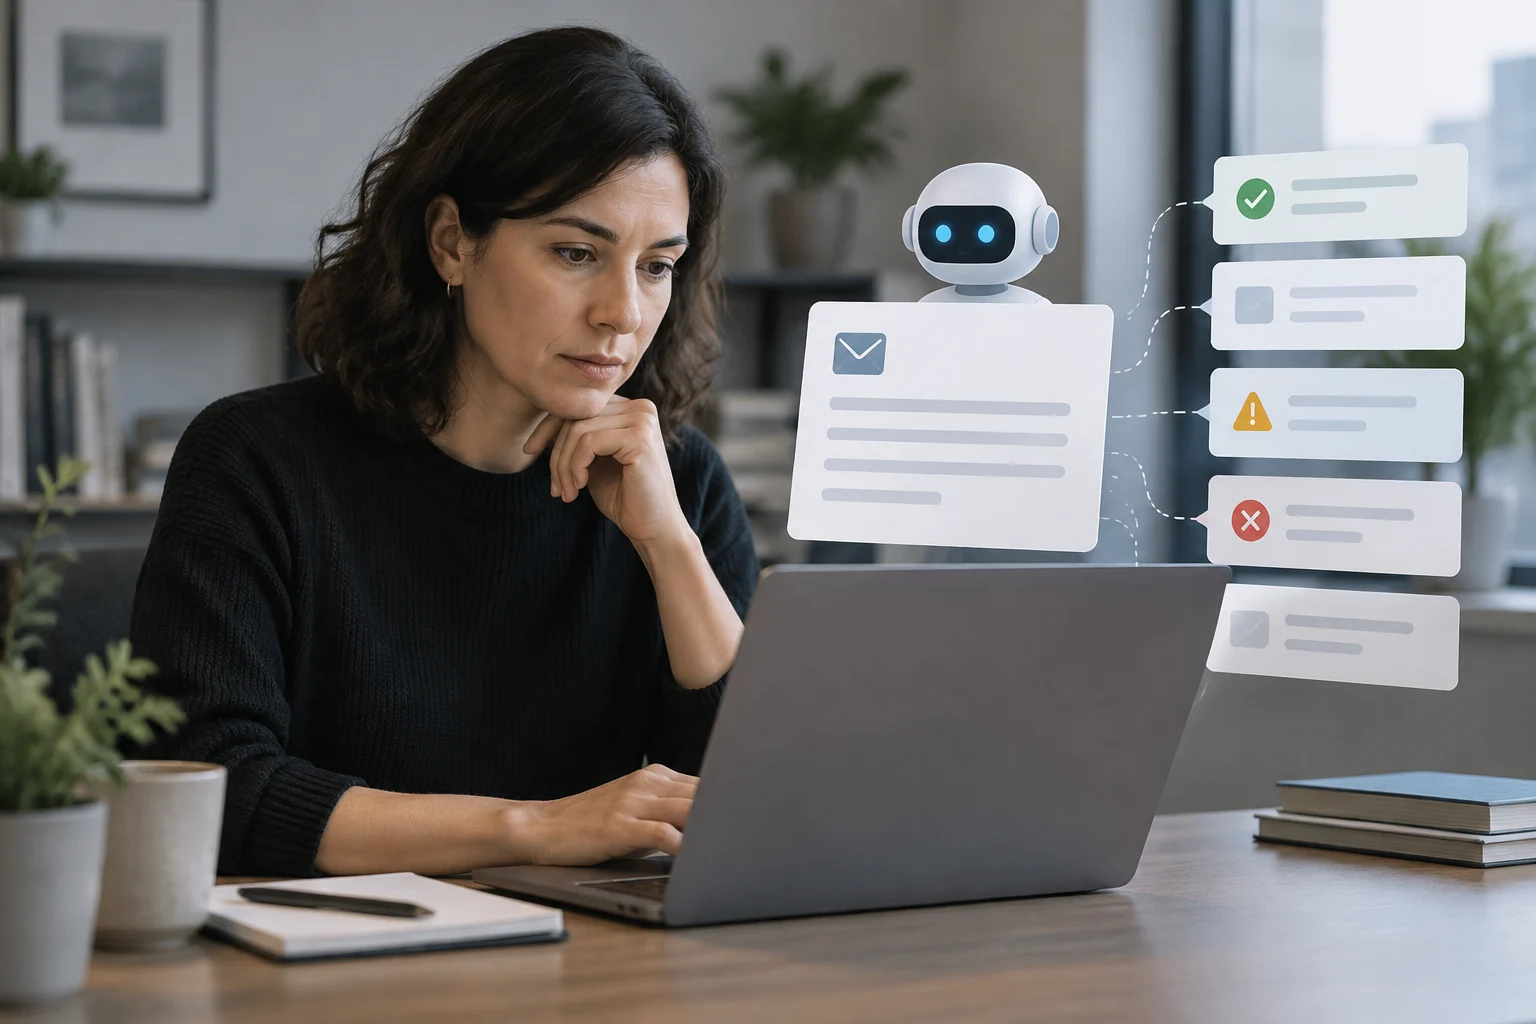
Une séquence simple pourrait consister à recevoir une demande, supprimer ou remplacer les données inutiles, classer le sujet, générer un brouillon, le présenter à une personne, puis enregistrer le résultat approuvé. La classification du modèle est une proposition, pas une certitude : si la catégorie ne convient pas ou si des informations manquent, le flux doit permettre de signaler l’incertitude et de transmettre le cas pour examen.
Le résultat généré peut varier même lorsque l’entrée ressemble à une précédente. Il ne faut donc pas compter sur le modèle pour répéter toujours la même formulation, ni utiliser son texte comme instruction automatique sans contrôles. Toute étape qui modifie des données ou concerne une autre personne doit prévoir une condition explicite, un moyen de s’interrompre et un responsable identifiable.
Mettre en place une automatisation assistée par l’IA
Parcours de démarrage : les règles gèrent les actions prévisibles, l’IA aide à interpréter ou rédiger, et une personne contrôle le résultat avant toute action externe.
-
Cibler
Une tâche délimitée et vérifiable
-
Répartir
Règles pour exécuter, IA pour interpréter ou rédiger
-
Générer
Un résultat provisoire
-
Contrôler
Validation humaine avant l’action
-
Tester et interrompre
Cas fictifs, recours manuel si nécessaire
Exemple de démarche, à adapter aux risques, aux données et aux outils utilisés.
Concevoir une première version avec validation humaine
Encadrez la tâche du modèle avec des consignes précises : indiquez ce qu’il doit extraire, le ton à employer, les informations qu’il ne doit pas inventer et la marche à suivre en cas de données insuffisantes. Demandez une réponse organisée en champs — sujet, résumé, brouillon et questions en suspens, par exemple — pour présenter le résultat clairement. Une structure définie facilite la vérification, mais ne garantit pas l’exactitude du contenu.
La validation humaine doit avoir lieu avant l’envoi d’une réponse, la modification d’un registre important ou le déclenchement d’un autre processus. La personne chargée de vérifier doit pouvoir consulter le message pertinent, le brouillon et les champs extraits, puis modifier, rejeter ou transmettre le cas. L’approbation doit être une action réelle, et non une case cochée automatiquement ou une formalité sans temps consacré à la vérification.
Prévoyez une solution de repli sûre en cas d’erreur technique ou de résultat douteux. Si le modèle ne répond pas, renvoie des informations incomplètes ou produit un format inattendu, le processus doit s’arrêter ou revenir au traitement manuel. Ne transformez pas une sortie vide en réponse automatique et ne prenez pas l’incertitude signalée par le système pour une preuve de fiabilité du reste de ses résultats.
Tester le flux avant son utilisation réelle
Testez le flux avec des exemples fictifs et variés, sans données de clients ni de collègues. Incluez des demandes claires, des messages ambigus, des requêtes hors périmètre, des informations contradictoires et des cas qui ne devraient pas recevoir de réponse automatique. L’objectif est de vérifier le comportement face aux exceptions, et pas seulement de confirmer que le flux fonctionne avec un exemple idéal.
Consignez les résultats attendus et comparez-les à ceux du système : catégorie, résumé, brouillon et décision de s’arrêter ou de transmettre le cas. Examinez séparément les erreurs et les omissions : une réponse bien rédigée peut contenir des informations inventées, tandis qu’une réponse courte peut avoir perdu un détail important. Ajustez les consignes et les règles, puis répétez les tests qui ont échoué.
Désactivez les envois et les modifications externes pendant les essais. Utilisez une copie des données ou un environnement de test, vérifiez que les journaux sont enregistrés au bon endroit et que les erreurs peuvent être retracées. Ne passez à un essai limité en conditions réelles que si une procédure de validation existe et qu’un retour au processus manuel est clairement prévu.
Réduire les données et les autorisations
Ne transmettez au modèle que les informations nécessaires à la tâche. Si un brouillon peut être préparé sans nom, adresse e-mail, adresse postale ni autre identifiant, excluez ces éléments ou remplacez-les avant de traiter le texte. La minimisation des données réduit l’exposition, mais ne remplace pas les règles de confidentialité, de sécurité et de conservation applicables à l’équipe et à l’outil utilisé.
Connectez uniquement les applications indispensables et accordez au flux des autorisations limitées. Une tâche de rédaction de réponses n’a pas forcément besoin d’envoyer des messages, de supprimer des registres ou d’accéder à un dossier entier. Dans la mesure du possible, séparez la génération du brouillon de l’action finale et vérifiez qui peut consulter les entrées, les résultats et les journaux d’exécution.
Avant d’utiliser des informations confidentielles, vérifiez que les conditions de l’outil et les politiques de l’organisation autorisent cet usage. Ne collez pas de données sensibles dans un service personnel ou non autorisé, même pour un essai. Pour limiter les risques, accordez à chaque outil uniquement les accès nécessaires et vérifiez les autorisations avant de connecter une application ou une source externe.
Mesurer les résultats et définir quand s’arrêter
Comparez le processus assisté au processus manuel sur une période et avec des cas équivalents. Comptabilisez le temps de préparation, de vérification et de correction, et pas uniquement celui que le modèle met à générer du texte. Le gain net inclut le travail de supervision : si la vérification et la réparation des brouillons prennent plus de temps que leur rédaction, le flux n’atteint pas son objectif.
Suivez des indicateurs simples : proportion de brouillons acceptés sans modification, corrections nécessaires, erreurs importantes, cas transmis et durée totale par demande. Distinguez les problèmes qu’une meilleure consigne pourrait résoudre de ceux qui exigent de revoir le périmètre ou d’abandonner le cas d’usage. Une amélioration de la vitesse ne remplace ni la qualité, ni la sécurité, ni la satisfaction des personnes concernées.
Définissez à l’avance quand mettre le flux en pause : par exemple, si les erreurs importantes se multiplient, si des données non autorisées apparaissent ou s’il n’est plus possible de vérifier le résultat avant d’agir. Conservez une procédure manuelle et désignez une personne responsable de la remise en service. Une automatisation utile doit aussi pouvoir s’arrêter sans bloquer le travail quotidien.
Exemple : préparer un brouillon pour une question fréquente
Imaginez une petite équipe qui reçoit souvent des questions sur les horaires, les démarches ou les conditions publiées. Un flux de travail peut associer des règles à des outils d’IA générative pour aider à traiter les demandes. La personne chargée de la vérification examine le résultat avant qu’une réponse soit communiquée.
La personne responsable vérifie que le brouillon répond à la question, n’ajoute pas de conditions inexistantes et ne révèle pas les informations d’une autre personne. Si la demande comporte une exception, nécessite un avis ou ne correspond pas aux informations de référence, elle peut être modifiée ou transmise. Le modèle aide à préparer le texte ; la personne décide quoi communiquer et procède à l’envoi.
Au départ, limitez cet exemple à quelques questions dont les réponses sont connues et dont le contenu n’est pas sensible. Notez les modifications apportées par les personnes chargées de la vérification ainsi que les cas nécessitant une transmission. Si le système confond les sujets ou ajoute des informations non étayées, réduisez le périmètre ou revenez au traitement manuel ; n’élargissez pas les autorisations pour compenser une tâche mal définie.