Définition canonique : ce qui constitue un système d'IA
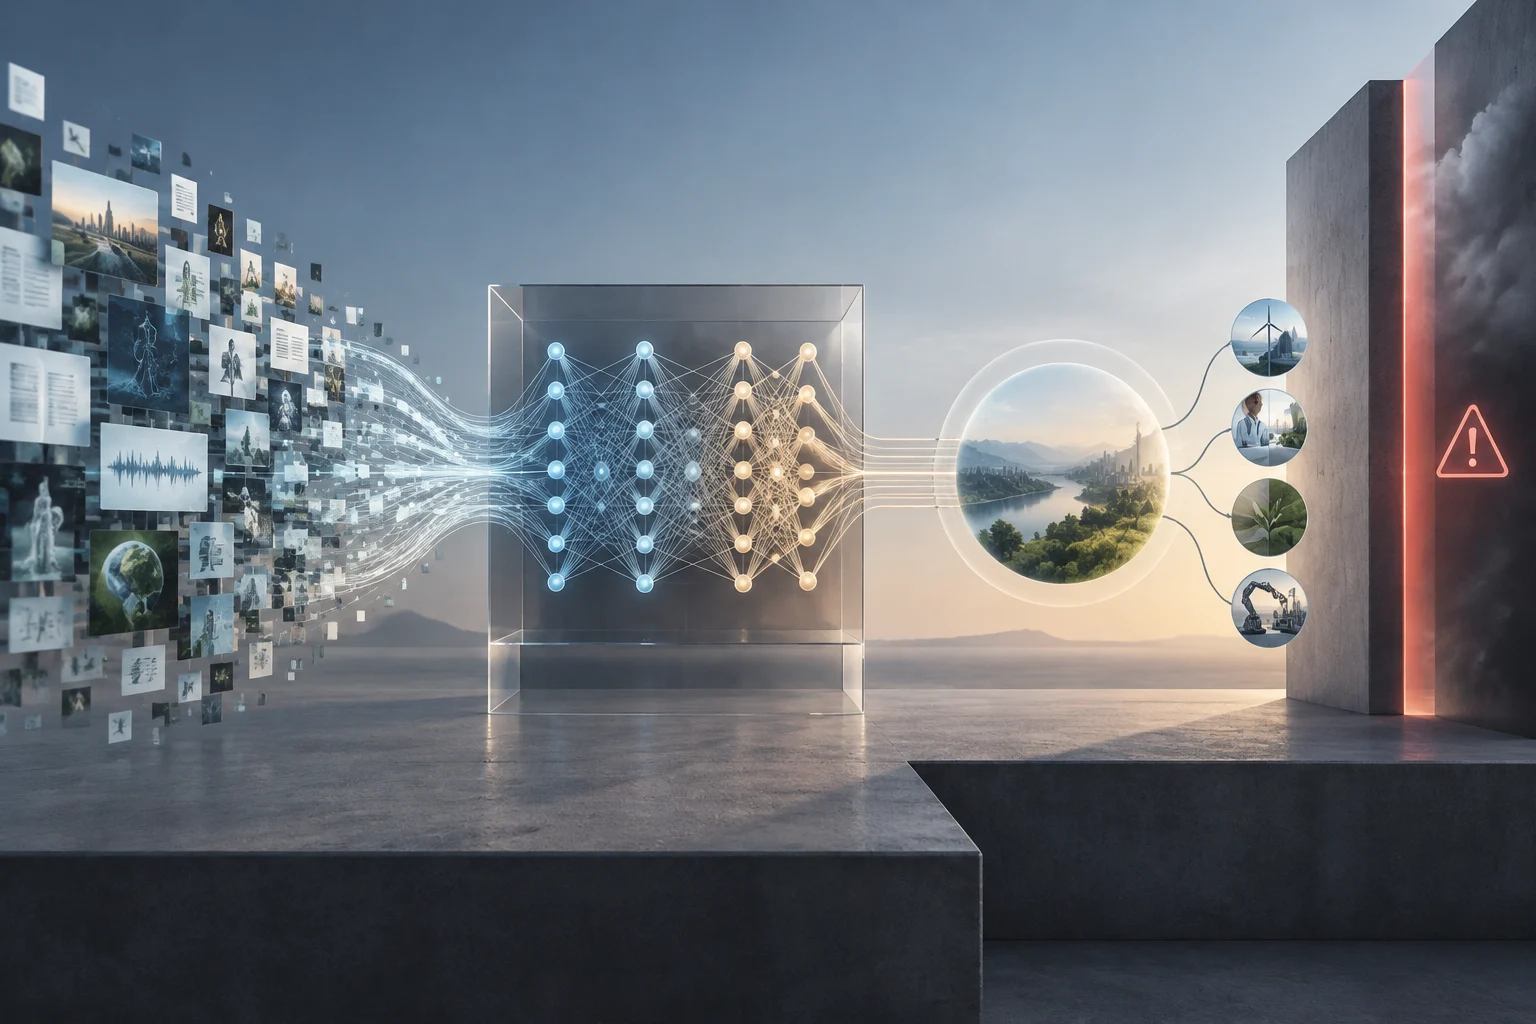
L'intelligence artificielle est définie comme le domaine de l'informatique dédié à la création de systèmes capables d'effectuer des tâches qui nécessitent traditionnellement l'intelligence humaine, comme la perception, le raisonnement, l'apprentissage et la compréhension du langage naturel. Cette définition, soutenue par des organismes comme l'Union européenne et les entreprises technologiques, établit qu'il ne s'agit pas d'une technologie unique, mais d'un ensemble de méthodes permettant aux machines de traiter l'information et de prendre des décisions.
Le Règlement européen sur l'intelligence artificielle (AI Act), entré en vigueur en février 2025, offre un cadre juridique pour classer ces systèmes selon leur niveau de risque. La réglementation distingue entre les systèmes à usage général et spécifique, établissant des obligations pour les fournisseurs et les utilisateurs. Cette réglementation vise à garantir que le développement de l'IA soit transparent, sûr et respectueux des droits fondamentaux, marquant un standard mondial pour l'industrie.
Différence avec la programmation traditionnelle
Contrairement à un programme traditionnel, où chaque règle est préprogrammée explicitement par un développeur, un système d'IA apprend des motifs à partir de données. Dans la programmation classique, si le critère change, le code doit être modifié manuellement. En IA, le système ajuste ses paramètres internes lorsqu'il est exposé à de nouveaux exemples, ce qui lui permet de s'adapter à des situations non prévues dans sa conception initiale.
Mécanismes de fonctionnement : de la donnée à la décision
Le fonctionnement d'un système d'IA repose sur l'apprentissage automatique (machine learning), un sous-ensemble de l'IA où les systèmes identifient des motifs dans de grands volumes de données sans être explicitement programmés pour chaque cas. Le processus commence par la collecte de données, utilisées pour entraîner un modèle mathématique. Ce modèle ajuste ses paramètres internes jusqu'à ce que ses prédictions s'alignent avec les résultats attendus dans le jeu de données d'entraînement.
Une fois entraîné, le modèle entre dans la phase d'inférence, moment où le système applique les motifs appris à de nouvelles données pour générer une réponse ou une décision. Par exemple, un modèle entraîné avec des images d'animaux peut identifier une race de chien en temps réel, même s'il n'a jamais vu cette image spécifique auparavant. La qualité de l'inférence dépend directement de la quantité et de la pertinence des données utilisées dans l'entraînement.
Le cycle de vie du modèle
Le développement d'un système d'IA suit un cycle itératif qui inclut la collecte de données, l'entraînement, la validation, le déploiement et le retour d'information. La validation est cruciale pour mesurer la précision du modèle sur des données qu'il n'a pas vues pendant l'entraînement, évitant le surapprentissage. Le retour d'information permet de mettre à jour le modèle avec de nouvelles données, améliorant ses performances au fil du temps.
Types d'apprentissage automatique
Au sein de l'apprentissage automatique, il existe trois approches principales qui se distinguent par la manière dont les données sont structurées et dont le modèle reçoit ses instructions. Le choix de la méthode dépend de la nature du problème et de la disponibilité de données étiquetées. Chaque approche a des applications spécifiques et des exigences distinctes en matière de qualité et de volume d'informations d'entrée.
Le tableau suivant compare les trois types principaux d'apprentissage automatique, en mettant en évidence leurs caractéristiques, exemples d'application et exigences de données :
| Type d'apprentissage | Description | Exemple d'application | Exigences de données |
|---|---|---|---|
| Supervisé | Le modèle apprend à partir de données étiquetées avec la bonne réponse. | Détection du spam dans les e-mails. | Données étiquetées (entrée et sortie attendue). |
| Non supervisé | Le modèle identifie des motifs ou des regroupements dans des données non étiquetées. | Segmentation des clients en marketing. | Données non étiquetées, grands volumes. |
| Par renforcement | Le modèle apprend par essai-erreur, recevant des récompenses ou des pénalités. | Robots de navigation ou jeux d'échecs. | Environnement simulé ou réel avec retour continu. |
L'apprentissage supervisé est le plus courant dans les applications commerciales, car il permet d'évaluer objectivement la précision du modèle. Le non supervisé est utile lorsque la structure des données est inconnue ou que l'on cherche à découvrir des relations cachées. L'apprentissage par renforcement est employé dans des environnements dynamiques où l'action de l'agent a des conséquences immédiates mesurables.
IA faible, IA forte et IA générative
Le domaine de l'IA est traditionnellement divisé en deux branches : l'intelligence artificielle faible (ou étroite) et l'intelligence artificielle forte (ou générale). L'IA faible est conçue pour effectuer des tâches spécifiques, comme la reconnaissance vocale dans un assistant virtuel ou la recommandation de produits sur une plateforme de commerce électronique. La plupart des applications actuelles appartiennent à cette catégorie, car elles sont plus faciles à développer et à évaluer.
L'IA forte (AGI, en anglais) aspire à émuler l'intelligence humaine dans sa totalité, permettant à la machine de raisonner, s'adapter et apprendre de manière similaire à une personne. Ce type d'IA est encore en phase de recherche et n'a pas été atteint par aucun système commercial. La distinction est importante pour éviter des attentes irréalistes sur les capacités actuelles de la technologie.
IA générative vs. IA analytique
Ces dernières années, l'IA générative a pris de l'importance, un sous-ensemble de l'IA qui crée du nouveau contenu (texte, images, code) à partir des motifs appris. Contrairement à l'IA analytique, qui classe ou prédit, l'IA générative produit des sorties créatives. Des modèles comme GPT-4 d'OpenAI sont des exemples d'IA générative, utilisés pour rédiger des textes, générer du code ou créer des images. Cette capacité a élargi la portée de l'IA dans les secteurs créatifs et le développement logiciel.
Usages pratiques et exemples expliqués
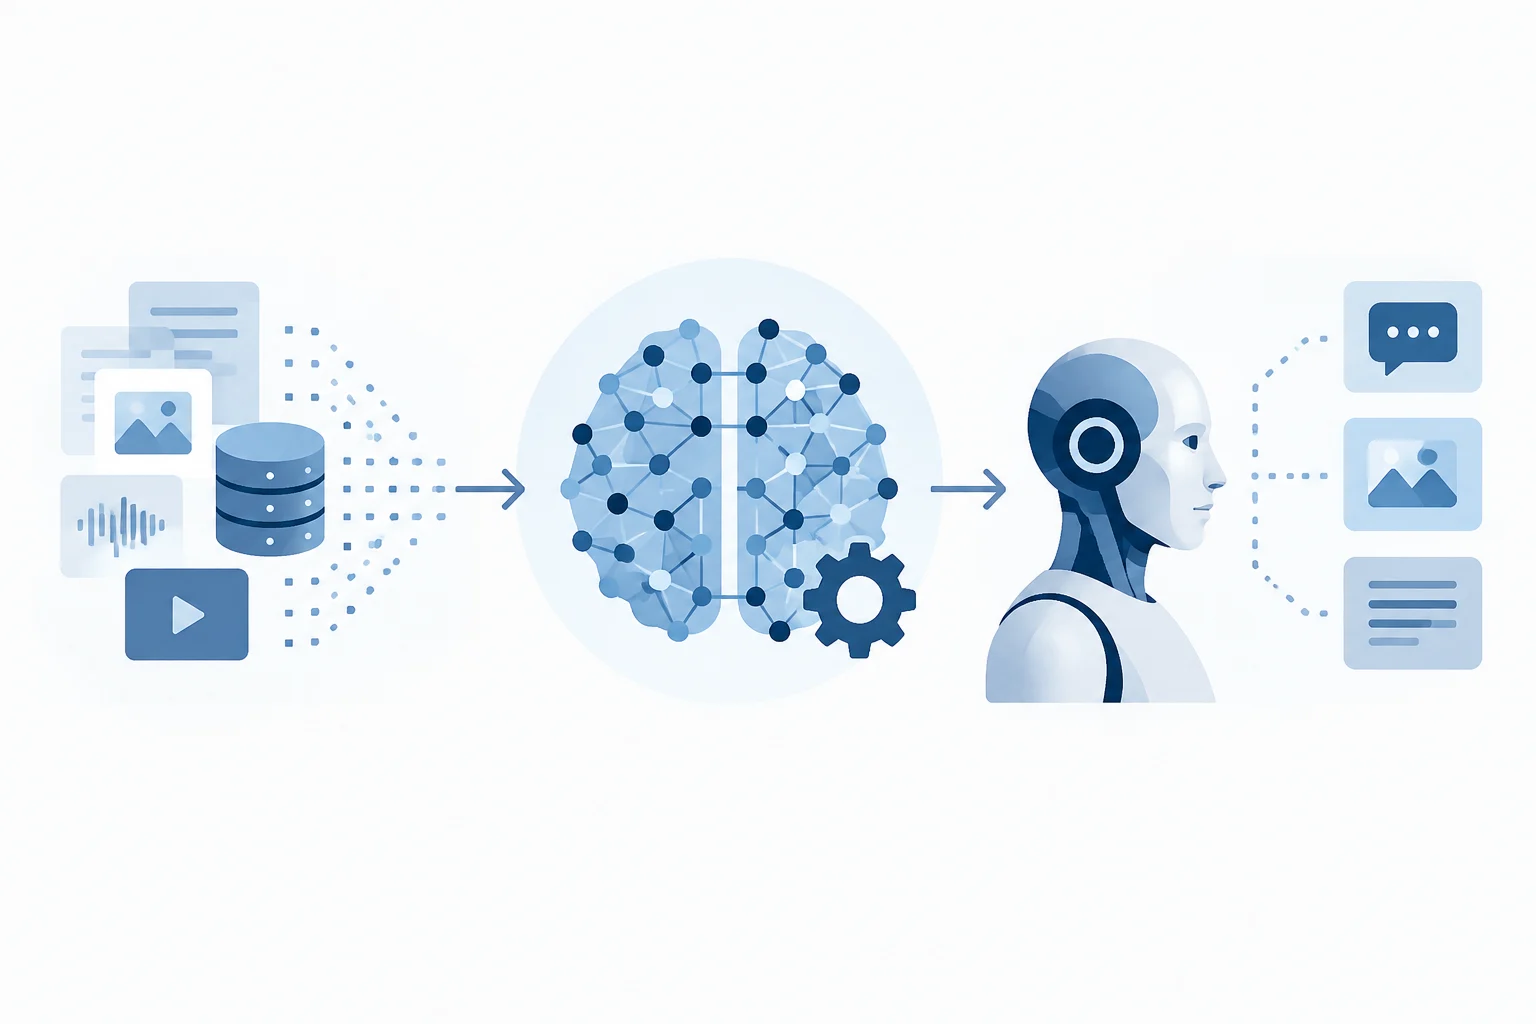
L'intelligence artificielle est appliquée dans divers secteurs, de la santé à l'industrie. Dans le domaine médical, les systèmes d'IA aident au diagnostic par imagerie, analysant des radiographies ou des IRM pour détecter des anomalies qui pourraient échapper à l'œil humain. Ces systèmes ne remplacent pas le médecin, mais agissent comme un outil d'aide qui accélère le processus et réduit la charge de travail.
Dans le secteur financier, l'IA est utilisée pour la détection de la fraude, analysant les transactions en temps réel pour identifier des motifs suspects. Dans le commerce électronique, les moteurs de recommandation suggèrent des produits en se basant sur l'historique d'achats et le comportement de l'utilisateur. Dans l'industrie, l'IA optimise la chaîne d'approvisionnement, prédit les pannes de machines et automatise les processus de contrôle qualité.
Exemple : diagnostic médical
Un système d'IA entraîné avec des milliers d'images de rétines peut détecter des signes de diabète ou de glaucome avec une précision comparable à celle d'un spécialiste. Le modèle analyse l'image et génère une probabilité de maladie, que le médecin examine et confirme. Cette approche permet d'étendre la capacité de diagnostic dans les zones où les spécialistes sont rares, améliorant l'accès aux soins.
Limites, risques et nécessité de supervision
Malgré ses avantages, l'IA présente des risques significatifs qui doivent être gérés. L'un des plus notables est l'hallucination, phénomène par lequel un modèle génératif invente des informations inexistantes ou incorrectes, les présentant avec la même confiance que les données réelles. Cela se produit parce que le modèle prédit le mot ou l'élément le plus probable suivant, sans vérifier la véracité des informations.
Un autre risque important est le biais dans les données d'entraînement. Si les données utilisées pour entraîner un modèle ne sont pas représentatives de la population cible, les recommandations du système peuvent favoriser ou nuire à certains groupes. Par exemple, un modèle de recrutement entraîné avec des données historiques biaisées peut perpétuer la discrimination de genre ou de race. La supervision humaine est essentielle pour détecter et corriger ces biais.
Dépendance et effacement du jugement
La confiance excessive dans les systèmes d'IA peut conduire à la dépendance technologique, où les professionnels adoptent les suggestions du système sans les examiner de manière critique. Cela est particulièrement préoccupant dans des secteurs critiques comme la santé ou la justice, où une erreur peut avoir des conséquences graves. La formation des utilisateurs et la mise en œuvre de protocoles de vérification sont essentielles pour atténuer ce risque.
Glossaire de base des termes clés
Pour comprendre l'IA, il est utile de se familiariser avec certains termes techniques. Un modèle est la représentation mathématique que le système utilise pour faire des prédictions. Un jeu de données (dataset) est la collection d'informations avec laquelle le modèle est entraîné. L'inférence est le processus d'application du modèle entraîné à de nouvelles données pour obtenir une réponse.
L'entraînement est la phase où le modèle ajuste ses paramètres pour minimiser l'erreur dans les données d'entraînement. La validation est le processus d'évaluation du modèle avec des données qu'il n'a pas vues pendant l'entraînement, pour mesurer sa capacité de généralisation. Le surapprentissage se produit lorsque le modèle mémorise les données d'entraînement au lieu d'apprendre des motifs généraux, réduisant ses performances sur de nouvelles données.
Importance de la qualité des données
La qualité des données est déterminante pour la réussite d'un système d'IA. Des données incomplètes, bruitées ou biaisées peuvent conduire à des modèles imprécis ou injustes. La gouvernance des données implique d'établir des processus pour garantir la qualité, la confidentialité et la sécurité des informations utilisées dans l'entraînement et l'inférence. Sans une base de données solide, même l'algorithme le plus avancé ne fonctionnera pas correctement.