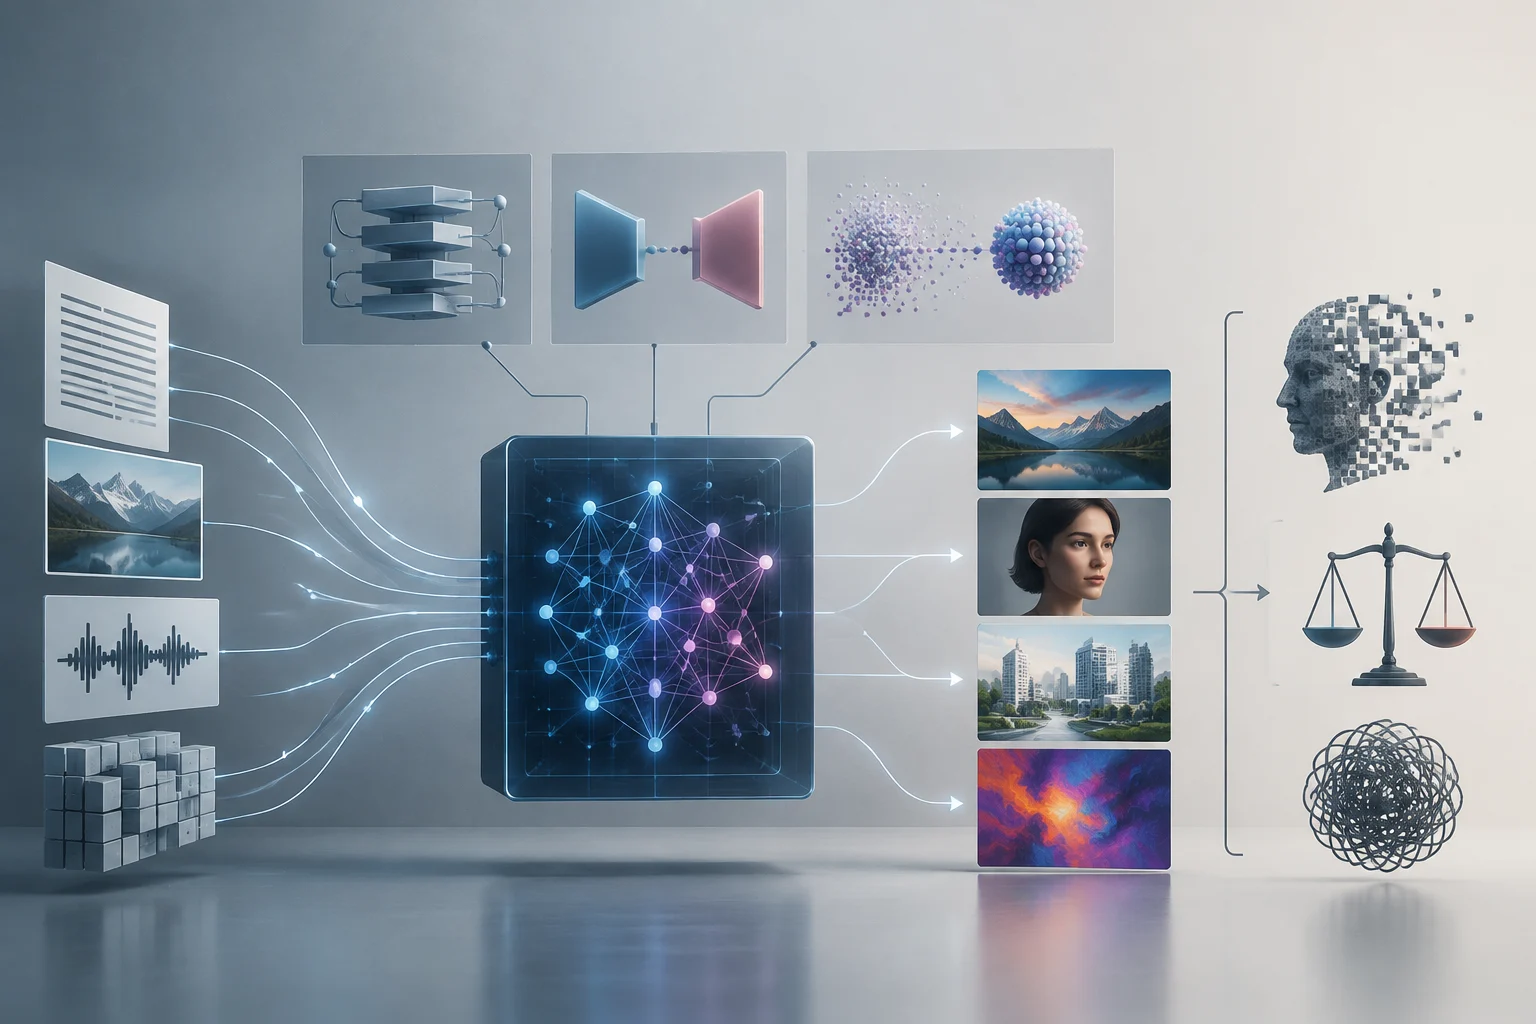
Définition et distinction par rapport à l'IA traditionnelle
L'IA générative est un sous-domaine de l'intelligence artificielle conçu pour créer du contenu nouveau et original, comme du texte, des images, de l'audio, de la vidéo ou du code, à partir de motifs appris dans de grands ensembles de données. Contrairement à l'IA analytique ou prédictive, qui classe des données ou prédit des résultats sur la base d'informations existantes, l'IA générative synthétise des informations inédites qui n'étaient pas explicitement présentes dans son entraînement. Cette capacité de synthèse marque une frontière claire avec les systèmes traditionnels, qui se limitent à traiter ce qui existe déjà.
Cette distinction est fondamentale pour comprendre sa valeur pratique. Alors qu'un système d'IA traditionnel pourrait prédire la probabilité de fraude dans une transaction, un système génératif pourrait rédiger le rapport d'audit ou générer un exemple synthétique d'une transaction frauduleuse pour entraîner d'autres modèles. La capacité de production de contenu la positionne comme un outil de création, et non seulement d'analyse, élargissant la portée des applications commerciales et créatives.
Le terme englobe une variété de techniques, mais leur dénominateur commun est l'utilisation de modèles d'apprentissage profond entraînés sur d'énormes volumes de données. Ces modèles ne « comprennent » pas le contenu au sens humain, mais capturent des relations statistiques et structurelles qui leur permettent de générer des sorties cohérentes et plausibles. Cette mécanisation de la créativité dépend entièrement de la qualité et de la diversité des données d'entraînement, ce qui souligne l'importance de la curation des données dans le développement de ces systèmes.
Architectures techniques : LLMs, GANs et modèles de diffusion
Il existe trois familles principales de modèles qui propulsent l'IA générative actuelle, chacune optimisée pour des types de données et des mécanismes de fonctionnement distincts. Le choix de l'architecture dépend du type de contenu à générer et des exigences de qualité et de vitesse. Comprendre ces différences techniques est clé pour sélectionner l'outil approprié pour chaque tâche spécifique.
Modèles de Langue de Grande Échelle (LLMs)
Les LLMs sont la base de la plupart des outils de texte conversationnels. Ils utilisent l'architecture des transformeurs pour traiter des séquences de mots et prédire le jeton suivant le plus probable. Leur entraînement repose sur l'apprentissage auto-supervisé sur des billions de mots, ce qui leur permet de capturer le contexte, les nuances et les structures grammaticales complexes. Cette capacité de modélisation de contexte long est ce qui leur confère leur polyvalence dans les tâches de rédaction et d'analyse.
Réseaux Adversariaux Génératifs (GANs)
Les GANs consistent en deux réseaux de neurones en compétition : un générateur qui crée des données et un discriminateur qui évalue leur authenticité. Ce processus adversarial permet de générer des images très réalistes, bien que leur entraînement puisse être instable et sujet au mode d'effondrement, où le générateur produit une gamme limitée de variations. La dynamique compétitive entre les deux réseaux est le moteur qui impulse l'amélioration continue de la qualité visuelle.
Modèles de Diffusion
Ces modèles apprennent à inverser un processus d'ajout de bruit. Pendant l'entraînement, les données sont corrompues par du bruit gaussien étape par étape ; lors de la génération, le modèle part d'un bruit pur et l'élimine progressivement jusqu'à former une image ou un audio cohérent. Actuellement, ils sont la technologie dominante dans la génération d'images de haute qualité à partir de texte, offrant une stabilité supérieure par rapport aux GANs dans de nombreux scénarios.
Comparatif des architectures génératives
Le tableau suivant résume les différences clés entre les trois architectures principales, facilitant la compréhension de leurs applications typiques et de leurs mécanismes de fonctionnement. Cette vue comparative aide à identifier rapidement quelle technologie est la plus adaptée à un objectif concret.
| Architecture | Type de sortie principal | Mécanisme de fonctionnement | Cas d'usage typiques |
|---|---|---|---|
| LLMs | Texte, code | Prédiction de jetons basée sur les transformeurs | Chatbots, rédaction, programmation |
| GANs | Images, audio | Compétition entre générateur et discriminateur | Synthèse faciale, art abstrait |
| Diffusion | Images, vidéo, audio | Inversion d'un processus de bruit graduel | Génération d'images depuis le texte, édition |
Note : Les LLMs peuvent également générer du code et d'autres formats structurés, bien que leur force principale soit le langage naturel. Les modèles de diffusion ont surpassé les GANs en qualité d'image dans les benchmarks récents.
Le processus de génération : du prompt à la sortie
Le flux de travail de base de l'IA générative suit une séquence logique : entrée, traitement et sortie. L'utilisateur fournit une entrée (prompt) en langage naturel ou dans un autre format, que le modèle analyse pour identifier des motifs correspondant à son entraînement. La qualité de l'entrée influence directement la pertinence de la sortie, ce qui fait de la formulation du prompt une compétence technique essentielle.
Le modèle utilise ces motifs pour compiler une sortie. Dans le cas des LLMs, cela implique de prédire répétitivement le mot ou le jeton suivant jusqu'à compléter la réponse. Dans les modèles de diffusion, cela implique d'itérer des étapes de débruitage. Un aspect crucial est que la sortie est non déterministe : pour des entrées identiques, le modèle peut générer des résultats différents à chaque exécution, en raison de la nature probabiliste de la génération. Cette variabilité introduit un élément d'imprévisibilité qui doit être géré.
Cette variabilité est une caractéristique, et non une erreur, car elle permet la créativité et la diversité dans les sorties. Cependant, cela implique également que la supervision humaine est nécessaire pour garantir la précision et l'adéquation du contenu généré aux objectifs spécifiques de l'utilisateur. La reproductibilité limitée exige que les utilisateurs valident activement les résultats avant leur utilisation finale.
Limites inhérentes : hallucinations et biais
La limitation la plus documentée de l'IA générative est l'hallucination, qui se produit lorsque le modèle produit un contenu incorrect, trompeur ou sans base dans les données réelles. Cela se produit parce que les modèles prédisent le mot suivant le plus probable grammaticalement, et non le plus factuellement correct. Une réponse peut sembler cohérente et convaincante, mais être complètement fausse, ce qui pose des risques significatifs dans les contextes où la précision est critique.
D'autres limites incluent les biais d'entraînement. Si les données utilisées pour entraîner le modèle contiennent des biais sociaux, culturels ou de genre, le modèle les répliquera dans ses sorties. De plus, le manque d'accès à des sources vérifiées en temps réel signifie que le modèle ne peut pas croiser les informations, ce qui augmente le risque d'erreurs factuelles. Ces biais peuvent perpétuer des stéréotypes s'ils ne sont pas atténués par des techniques de fine-tuning ou de filtrage des données.
Le coût computationnel est également une barrière significative. L'entraînement et l'exécution de modèles à grande échelle nécessitent une infrastructure matérielle spécialisée et une énergie considérable. Enfin, le besoin de supervision humaine est critique : l'IA générative ne doit pas être considérée comme une source de vérité autonome, mais comme un outil d'assistance nécessitant une validation par des experts. La gestion des risques doit être intégrale pour aborder ces limites techniques et éthiques.
Applications pratiques et considérations éthiques
Malgré ses limites, l'IA générative a des applications transformatrices dans de nombreux secteurs. Dans le développement logiciel, elle accélère l'écriture et le débogage du code. Dans le marketing, elle génère des variations de copy et des créatifs visuels. Dans l'éducation, elle personnalise les explications et crée du matériel didactique adapté au niveau de l'étudiant. Ces applications démontrent le potentiel de l'IA pour augmenter la productivité et la personnalisation dans divers domaines.
L'utilisation responsable de ces outils exige de considérer des aspects éthiques tels que la propriété intellectuelle, la transparence sur l'origine du contenu et la prévention de la désinformation. Les organisations doivent établir des politiques claires sur l'utilisation de l'IA générative, y compris la vérification des sorties et l'attribution appropriée lorsque du contenu généré par IA est utilisé. La gouvernance des données est fondamentale pour assurer la conformité réglementaire et l'éthique dans l'utilisation de ces technologies.
L'intégration de l'IA générative dans les flux de travail doit être progressive et supervisée. Les professionnels doivent développer une littératie en IA pour comprendre ce que l'outil peut et ne peut pas faire, et comment interpréter ses sorties de manière critique. Cette compétence technique et éthique est de plus en plus précieuse sur le marché du travail actuel, car elle permet aux utilisateurs de maximiser la valeur de l'IA tout en minimisant ses risques.