Definizione e distinzione rispetto all'IA tradizionale
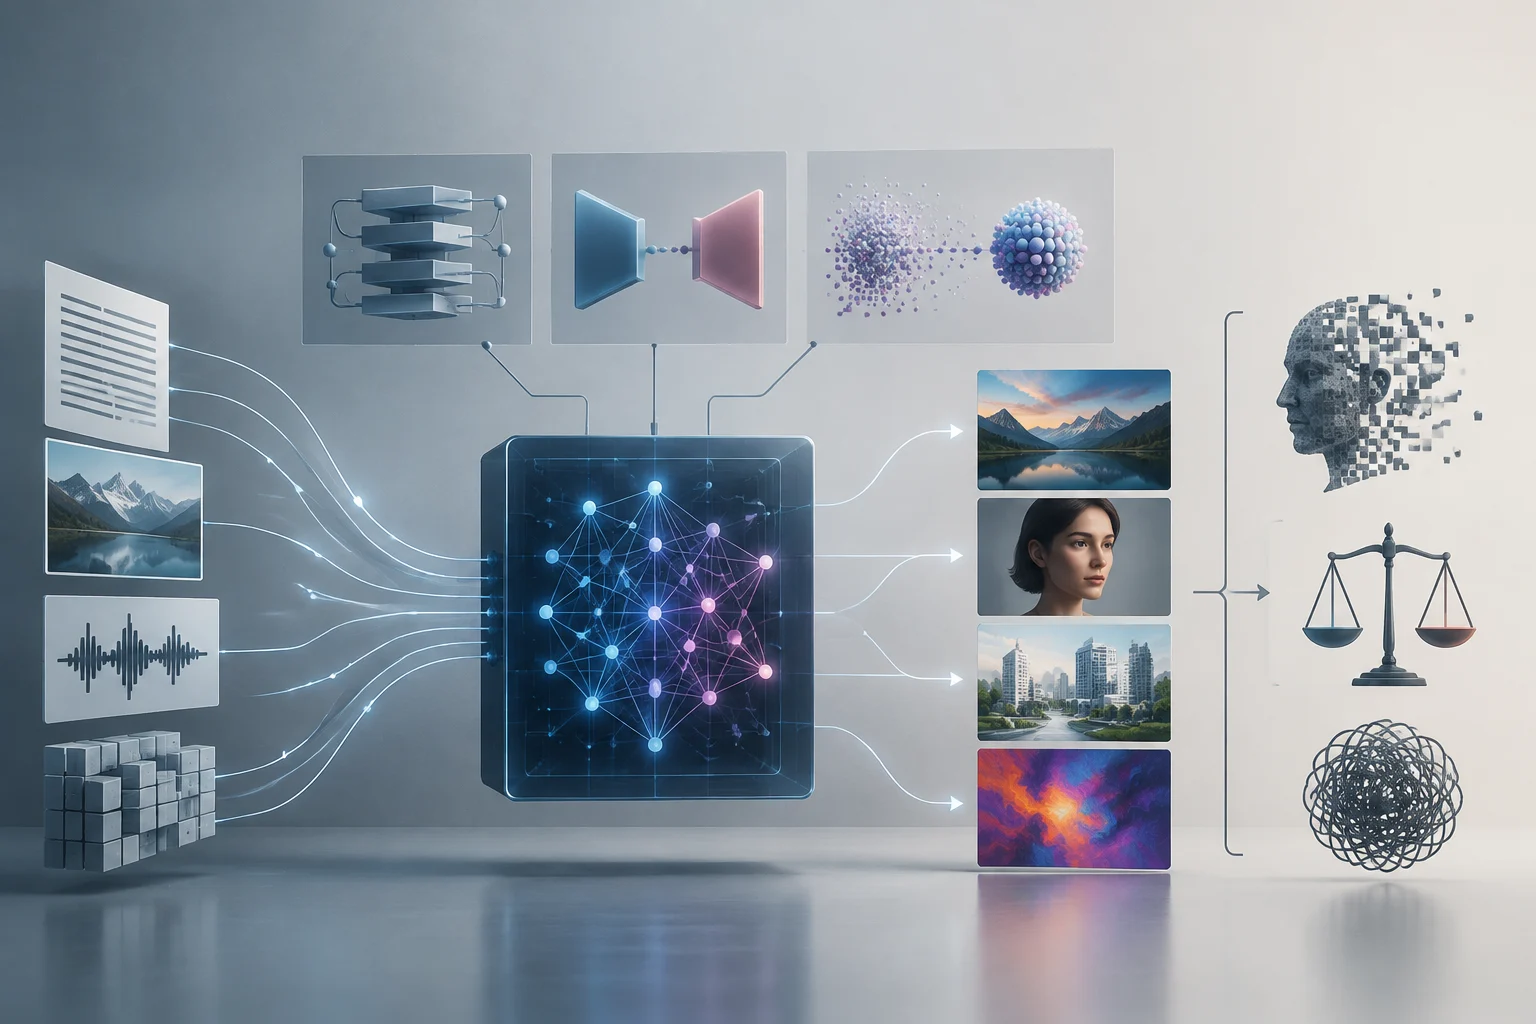
L'IA generativa è un sotto-campo dell'intelligenza artificiale progettato per creare contenuti nuovi e originali, come testo, immagini, audio, video o codice, a partire da modelli appresi in grandi insiemi di dati. A differenza dell'IA analitica o predittiva, che classifica i dati o prevede risultati basandosi su informazioni esistenti, l'IA generativa sintetizza informazioni inedite che non erano esplicitamente presenti nel suo addestramento. Questa capacità di sintesi segna un confine chiaro con i sistemi tradizionali, che si limitano a elaborare ciò che già esiste.
Questa distinzione è fondamentale per comprenderne il valore pratico. Mentre un sistema di IA tradizionale potrebbe prevedere la probabilità di frode in una transazione, un sistema generativo potrebbe redigere il rapporto di audit o generare un esempio sintetico di una transazione fraudolenta per addestrare altri modelli. La capacità di produzione di contenuti la posiziona come uno strumento di creazione, non solo di analisi, ampliando la portata delle applicazioni aziendali e creative.
Il termine abbraccia una varietà di tecniche, ma il loro denominatore comune è l'uso di modelli di deep learning addestrati su enormi volumi di dati. Questi modelli non 'comprendono' il contenuto nel senso umano, ma catturano relazioni statistiche e strutturali che consentono loro di generare output coerenti e plausibili. Questa meccanizzazione della creatività dipende interamente dalla qualità e dalla diversità dei dati di addestramento, sottolineando l'importanza della curatela dei dati nello sviluppo di questi sistemi.
Architetture tecniche: LLM, GAN e modelli di diffusione
Esistono tre famiglie principali di modelli che guidano l'attuale IA generativa, ciascuna ottimizzata per tipi di dati e meccanismi di funzionamento diversi. La scelta dell'architettura dipende dal tipo di contenuto da generare e dai requisiti di qualità e velocità. Comprendere queste differenze tecniche è la chiave per selezionare lo strumento giusto per ogni compito specifico.
Modelli di Linguaggio di Grande Scala (LLM)
Gli LLM sono la base della maggior parte degli strumenti di testo conversazionali. Utilizzano l'architettura dei transformer per elaborare sequenze di parole e prevedere il token successivo più probabile. Il loro addestramento si basa sull'apprendimento auto-supervisionato su trilioni di parole, consentendo loro di catturare contesto, sfumature e strutture grammaticali complesse. Questa capacità di modellazione del contesto lungo è ciò che conferisce loro la loro versatilità nei compiti di scrittura e analisi.
Reti Generative Adversarial (GAN)
Le GAN consistono in due reti neurali in competizione: un generatore che crea dati e un discriminatore che ne valuta l'autenticità. Questo processo avversariale consente di generare immagini molto realistiche, anche se il loro addestramento può essere instabile e soggetto al collasso di modalità, dove il generatore produce un intervallo limitato di variazioni. La dinamica competitiva tra entrambe le reti è il motore che spinge il miglioramento continuo della qualità visiva.
Modelli di Diffusione
Questi modelli imparano a invertire un processo di aggiunta di rumore. Durante l'addestramento, i dati vengono corrotti con rumore gaussiano passo dopo passo; durante la generazione, il modello parte da rumore puro e lo elimina gradualmente fino a formare un'immagine o un audio coerente. Attualmente, sono la tecnologia dominante nella generazione di immagini di alta qualità a partire dal testo, offrendo una stabilità superiore rispetto alle GAN in molti scenari.
Confronto delle architetture generative
La tabella seguente riassume le differenze chiave tra le tre architetture principali, facilitando la comprensione delle loro applicazioni tipiche e dei meccanismi di funzionamento. Questa visione comparativa aiuta a identificare rapidamente quale tecnologia è più adatta a un obiettivo concreto.
| Architettura | Tipo di output principale | Meccanismo di funzionamento | Casi d'uso tipici |
|---|---|---|---|
| LLM | Testo, codice | Previsione di token basata su transformer | Chatbot, scrittura, programmazione |
| GAN | Immagini, audio | Competizione tra generatore e discriminatore | Sintesi facciale, arte astratta |
| Diffusione | Immagini, video, audio | Inversione di un processo di rumore graduale | Generazione di immagini da testo, editing |
Nota: Gli LLM possono anche generare codice e altri formati strutturati, anche se la loro forza principale è il linguaggio naturale. I modelli di diffusione hanno superato le GAN in qualità di immagine nei benchmark recenti.
Il processo di generazione: dal prompt all'output
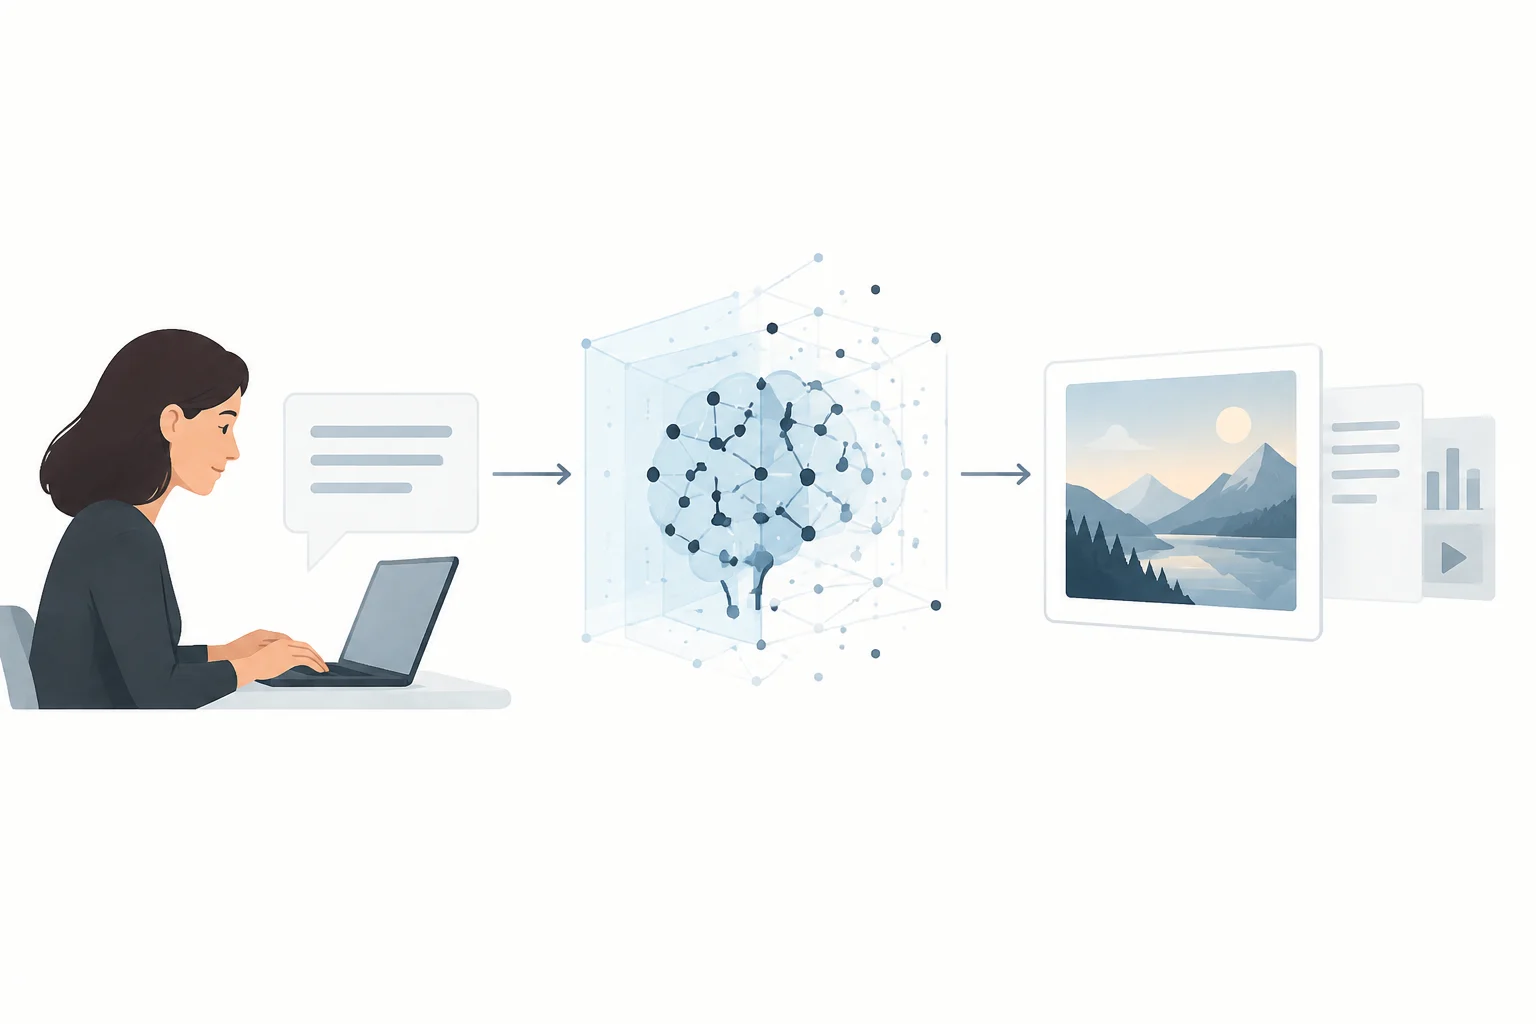
Il flusso di lavoro di base dell'IA generativa segue una sequenza logica: input, elaborazione e output. L'utente fornisce un input (prompt) in linguaggio naturale o in un altro formato, che il modello analizza per identificare modelli corrispondenti al suo addestramento. La qualità dell'input influisce direttamente sulla pertinenza dell'output, rendendo la formulazione del prompt una competenza tecnica essenziale.
Il modello utilizza questi modelli per compilare un output. Nel caso degli LLM, ciò implica prevedere ripetutamente la parola o il token successivo fino a completare la risposta. Nei modelli di diffusione, implica iterare passi di denoising. Un aspetto cruciale è che l'output è non deterministico: per input identici, il modello può generare risultati diversi in ogni esecuzione, a causa della natura probabilistica della generazione. Questa variabilità introduce un elemento di imprevedibilità che deve essere gestito.
Questa variabilità è una caratteristica, non un errore, poiché consente creatività e diversità negli output. Tuttavia, implica anche che la supervisione umana è necessaria per garantire l'accuratezza e l'adeguatezza del contenuto generato agli obiettivi specifici dell'utente. La ripetibilità limitata richiede che gli utenti validino attivamente i risultati prima dell'uso finale.
Limiti intrinseci: allucinazioni e bias
Il limite più documentato dell'IA generativa è l'allucinazione, che si verifica quando il modello produce contenuti errati, fuorvianti o privi di base nei dati reali. Questo accade perché i modelli prevedono la parola successiva più probabile grammaticalmente, non quella più fattualmente corretta. Una risposta può sembrare coerente e convincente, ma essere completamente falsa, il che pone rischi significativi in contesti in cui l'accuratezza è critica.
Altri limiti includono i bias di addestramento. Se i dati utilizzati per addestrare il modello contengono bias sociali, culturali o di genere, il modello li replicherà nei suoi output. Inoltre, la mancanza di accesso a fonti verificate in tempo reale significa che il modello non può confrontare le informazioni, aumentando il rischio di errori fattuali. Questi bias possono perpetuare stereotipi se non mitigati tramite tecniche di fine-tuning o filtraggio dei dati.
Il costo computazionale è anche una barriera significativa. Addestrare ed eseguire modelli su larga scala richiede infrastrutture hardware specializzate ed energia considerevole. Infine, la necessità di supervisione umana è critica: l'IA generativa non deve essere considerata una fonte di verità autonoma, ma uno strumento di assistenza che richiede validazione da parte di esperti. La gestione del rischio deve essere integrale per affrontare questi limiti tecnici ed etici.
Applicazioni pratiche e considerazioni etiche
Nonostante i suoi limiti, l'IA generativa ha applicazioni trasformatrici in molti settori. Nello sviluppo software, accelera la scrittura e il debug del codice. Nel marketing, genera varianti di copy e creativi visivi. Nell'istruzione, personalizza le spiegazioni e crea materiale didattico adattato al livello dello studente. Queste applicazioni dimostrano il potenziale dell'IA per aumentare la produttività e la personalizzazione in vari campi.
L'uso responsabile di questi strumenti richiede di considerare aspetti etici come la proprietà intellettuale, la trasparenza sull'origine dei contenuti e la prevenzione della disinformazione. Le organizzazioni devono stabilire politiche chiare sull'uso dell'IA generativa, inclusa la verifica degli output e l'attribuzione adeguata quando si utilizza contenuto generato dall'IA. La governance dei dati è fondamentale per garantire la conformità normativa e l'etica nell'uso di queste tecnologie.
L'integrazione dell'IA generativa nei flussi di lavoro deve essere graduale e supervisionata. I professionisti devono sviluppare l'alfabetizzazione in IA per capire cosa può e cosa non può fare lo strumento e come interpretare criticamente i suoi output. Questa competenza tecnica ed etica è sempre più preziosa nel mercato del lavoro attuale, poiché consente agli utenti di massimizzare il valore dell'IA minimizzandone i rischi.