Definition und Abgrenzung zur traditionellen KI
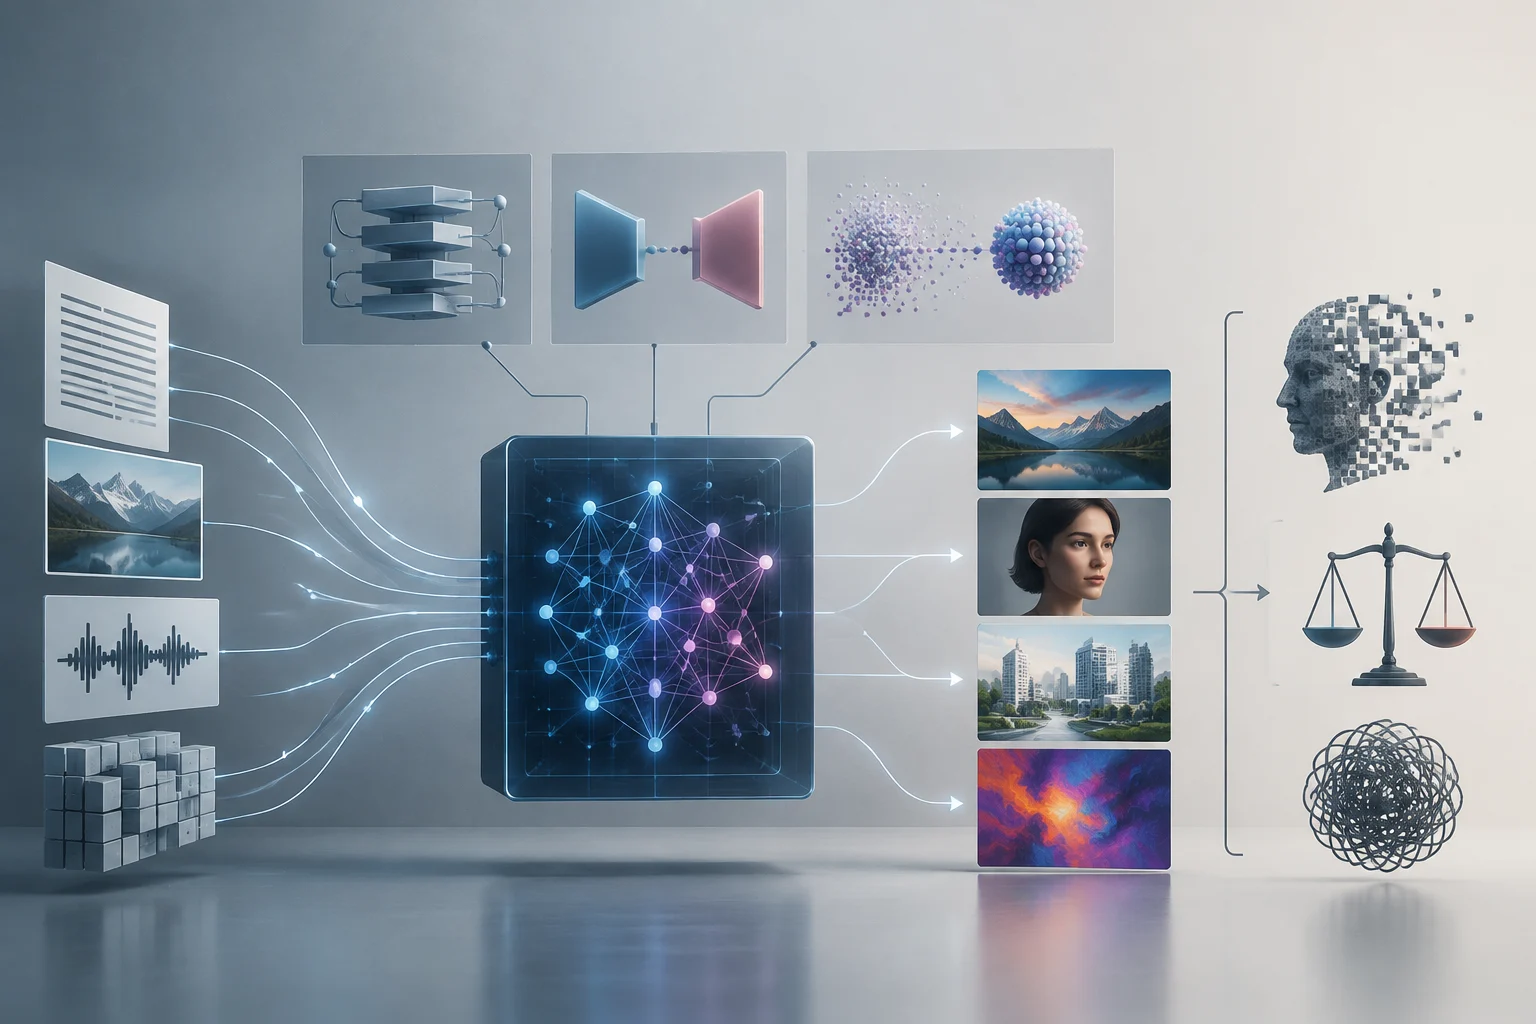
Generative KI ist ein Teilgebiet der künstlichen Intelligenz, das entwickelt wurde, um neue und originelle Inhalte wie Text, Bilder, Audio, Video oder Code auf der Grundlage von Mustern zu erstellen, die in großen Datensätzen gelernt wurden. Im Gegensatz zur analytischen oder prädiktiven KI, die Daten klassifiziert oder Ergebnisse auf Basis vorhandener Informationen vorhersagt, synthetisiert die generative KI neuartige Informationen, die in ihrem Training nicht explizit vorhanden waren. Diese Synthesefähigkeit markiert eine klare Grenze zu den traditionellen Systemen, die sich auf die Verarbeitung dessen beschränken, was bereits existiert.
Diese Unterscheidung ist grundlegend, um ihren praktischen Wert zu verstehen. Während ein traditionelles KI-System die Wahrscheinlichkeit von Betrug in einer Transaktion vorhersagen könnte, könnte ein generatives System den Prüfbericht verfassen oder ein synthetisches Beispiel einer betrügerischen Transaktion generieren, um andere Modelle zu trainieren. Die Fähigkeit zur Inhaltsproduktion positioniert sie als Werkzeug der Erstellung und nicht nur der Analyse und erweitert den Umfang der geschäftlichen und kreativen Anwendungen.
Der Begriff umfasst eine Vielzahl von Techniken, aber ihr gemeinsamer Nenner ist die Verwendung von Deep-Learning-Modellen, die mit enormen Datenmengen trainiert wurden. Diese Modelle 'verstehen' den Inhalt nicht im menschlichen Sinne, sondern erfassen statistische und strukturelle Beziehungen, die es ihnen ermöglichen, kohärente und plausible Ausgaben zu erzeugen. Diese Mechanisierung der Kreativität hängt vollständig von der Qualität und Vielfalt der Trainingsdaten ab, was die Bedeutung der Datenkuratierung bei der Entwicklung dieser Systeme unterstreicht.
Technische Architekturen: LLMs, GANs und Diffusionsmodelle
Es gibt drei Hauptfamilien von Modellen, die die heutige generative KI antreiben, wobei jede für verschiedene Datentypen und Funktionsmechanismen optimiert ist. Die Wahl der Architektur hängt von der Art des zu generierenden Inhalts und den Anforderungen an Qualität und Geschwindigkeit ab. Das Verständnis dieser technischen Unterschiede ist der Schlüssel zur Auswahl des richtigen Werkzeugs für jede spezifische Aufgabe.
Large Language Models (LLMs)
LLMs sind die Grundlage der meisten konversationellen Textwerkzeuge. Sie verwenden die Transformer-Architektur, um Wortsequenzen zu verarbeiten und das wahrscheinlichste nächste Token vorherzusagen. Ihr Training basiert auf selbstüberwachtem Lernen über Billionen von Wörtern, was es ihnen ermöglicht, Kontext, Nuancen und komplexe grammatikalische Strukturen zu erfassen. Diese Fähigkeit zur Modellierung langen Kontexts verleiht ihnen ihre Vielseitigkeit in Schreib- und Analyseaufgaben.
Generative Adversarial Networks (GANs)
GANs bestehen aus zwei konkurrierenden neuronalen Netzen: einem Generator, der Daten erstellt, und einem Diskriminator, der deren Authentizität bewertet. Dieser adversariale Prozess ermöglicht die Generierung sehr realistischer Bilder, obwohl ihr Training instabil sein und zum Modus-Kollaps neigen kann, bei dem der Generator einen begrenzten Bereich von Variationen erzeugt. Die wettbewerbsorientierte Dynamik zwischen beiden Netzen ist der Motor, der die kontinuierliche Verbesserung der visuellen Qualität antreibt.
Diffusionsmodelle
Diese Modelle lernen, einen Prozess der Rauschzugabe umzukehren. Während des Trainings werden die Daten schrittweise mit Gauß-Rauschen korrupt gemacht; bei der Generierung startet das Modell mit reinem Rauschen und entfernt es allmählich, bis ein kohärentes Bild oder Audio entsteht. Derzeit sind sie die dominierende Technologie bei der Generierung hochwertiger Bilder aus Text und bieten in vielen Szenarien eine überlegene Stabilität gegenüber GANs.
Vergleich der generativen Architekturen
Die folgende Tabelle fasst die wichtigsten Unterschiede zwischen den drei Hauptarchitekturen zusammen und erleichtert das Verständnis ihrer typischen Anwendungen und Funktionsmechanismen. Dieser Vergleich hilft, schnell zu identifizieren, welche Technologie für ein konkretes Ziel am besten geeignet ist.
| Architektur | Hauptausgabetyp | Funktionsmechanismus | Typische Anwendungsfälle |
|---|---|---|---|
| LLMs | Text, Code | Token-Vorhersage basierend auf Transformatoren | Chatbots, Schreiben, Programmierung |
| GANs | Bilder, Audio | Wettbewerb zwischen Generator und Diskriminator | Gesichtssynthese, abstrakte Kunst |
| Diffusion | Bilder, Video, Audio | Umkehrung eines graduellen Rauschprozesses | Bildgenerierung aus Text, Bearbeitung |
Hinweis: LLMs können auch Code und andere strukturierte Formate generieren, obwohl ihre Hauptstärke die natürliche Sprache ist. Diffusionsmodelle haben GANs in der Bildqualität in jüngsten Benchmarks übertroffen.
Der Generierungsprozess: Vom Prompt zur Ausgabe
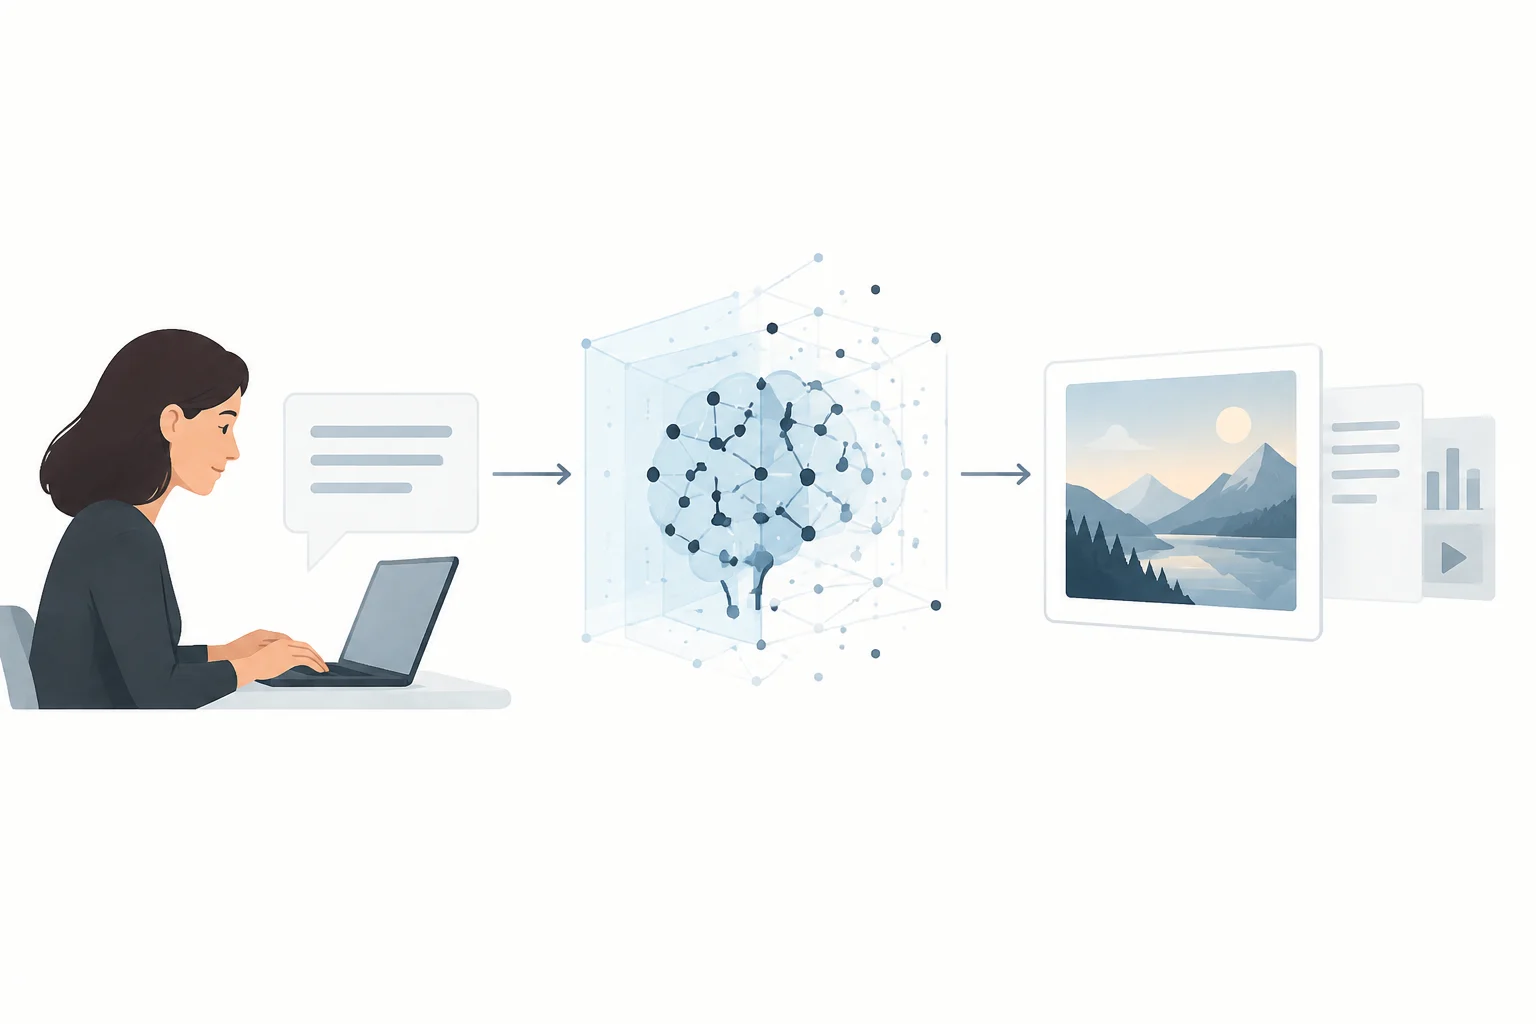
Der grundlegende Arbeitsablauf der generativen KI folgt einer logischen Sequenz: Eingabe, Verarbeitung und Ausgabe. Der Benutzer gibt eine Eingabe (Prompt) in natürlicher Sprache oder einem anderen Format ein, die das Modell analysiert, um Muster zu identifizieren, die mit seinem Training übereinstimmen. Die Qualität der Eingabe beeinflusst direkt die Relevanz der Ausgabe, was die Formulierung des Prompts zu einer wesentlichen technischen Fähigkeit macht.
Das Modell verwendet diese Muster, um eine Ausgabe zu kompilieren. Im Fall von LLMs bedeutet dies, wiederholt das nächste Wort oder Token vorherzusagen, bis die Antwort abgeschlossen ist. Bei Diffusionsmodellen bedeutet dies, Denoising-Schritte zu iterieren. Ein entscheidender Aspekt ist, dass die Ausgabe nicht deterministisch ist: Bei identischen Eingaben kann das Modell bei jeder Ausführung unterschiedliche Ergebnisse erzeugen, aufgrund der probabilistischen Natur der Generierung. Diese Variabilität führt zu einem Element der Unvorhersehbarkeit, das verwaltet werden muss.
Diese Variabilität ist ein Merkmal und kein Fehler, da sie Kreativität und Vielfalt in den Ausgaben ermöglicht. Sie impliziert jedoch auch, dass menschliche Aufsicht erforderlich ist, um die Genauigkeit und Eignung des generierten Inhalts für die spezifischen Ziele des Benutzers zu gewährleisten. Die begrenzte Reproduzierbarkeit erfordert, dass Benutzer die Ergebnisse vor der endgültigen Verwendung aktiv validieren.
Inhärente Einschränkungen: Halluzinationen und Verzerrungen
Die am besten dokumentierte Einschränkung der generativen KI ist die Halluzination, die auftritt, wenn das Modell falsche, irreführende oder unbegründete Inhalte erzeugt. Dies geschieht, weil die Modelle das grammatisch wahrscheinlichste nächste Wort vorhersagen, nicht das faktisch korrekteste. Eine Antwort kann kohärent und überzeugend klingen, aber vollständig falsch sein, was in Kontexten, in denen Genauigkeit kritisch ist, erhebliche Risiken birgt.
Weitere Einschränkungen umfassen Trainingsverzerrungen. Wenn die Daten, die zum Training des Modells verwendet werden, soziale, kulturelle oder geschlechtsspezifische Verzerrungen enthalten, wird das Modell diese in seinen Ausgaben replizieren. Darüber hinaus bedeutet der Mangel an Zugriff auf verifizierte Echtzeitquellen, dass das Modell Informationen nicht abgleichen kann, was das Risiko faktischer Fehler erhöht. Diese Verzerrungen können Stereotype perpetuieren, wenn sie nicht durch Feinabstimmung oder Datenfilterungstechniken gemindert werden.
Die Rechenkosten sind auch eine erhebliche Hürde. Das Training und Ausführen von Modellen im großen Maßstab erfordert spezialisierte Hardware-Infrastruktur und beträchtliche Energie. Schließlich ist die Notwendigkeit menschlicher Aufsicht kritisch: Generative KI sollte nicht als autonome Quelle der Wahrheit betrachtet werden, sondern als Unterstützungswerkzeug, das eine Validierung durch Experten erfordert. Das Risikomanagement muss umfassend sein, um diese technischen und ethischen Einschränkungen zu adressieren.
Praktische Anwendungen und ethische Überlegungen
Trotz ihrer Einschränkungen hat die generative KI transformative Anwendungen in vielen Branchen. In der Softwareentwicklung beschleunigt sie das Schreiben und Debuggen von Code. Im Marketing generiert sie Copy-Varianten und visuelle Kreationen. In der Bildung personalisiert sie Erklärungen und erstellt Lehrmaterial, das dem Niveau des Schülers angepasst ist. Diese Anwendungen demonstrieren das Potenzial der KI, die Produktivität und Personalisierung in verschiedenen Bereichen zu steigern.
Die verantwortungsvolle Nutzung dieser Werkzeuge erfordert die Berücksichtigung ethischer Aspekte wie geistiges Eigentum, Transparenz über den Ursprung des Inhalts und die Verhinderung von Desinformation. Organisationen müssen klare Richtlinien für die Nutzung generativer KI festlegen, einschließlich der Validierung von Ausgaben und der angemessenen Zuschreibung, wenn KI-generierter Inhalt verwendet wird. Die Daten-Governance ist grundlegend, um die Einhaltung von Vorschriften und die Ethik bei der Nutzung dieser Technologien sicherzustellen.
Die Integration der generativen KI in Workflows sollte schrittweise und überwacht erfolgen. Fachleute müssen KI-Kompetenz entwickeln, um zu verstehen, was das Werkzeug kann und was nicht, und wie seine Ausgaben kritisch zu interpretieren sind. Diese technische und ethische Kompetenz ist auf dem heutigen Arbeitsmarkt immer wertvoller, da sie es Benutzern ermöglicht, den Wert der KI zu maximieren und gleichzeitig ihre Risiken zu minimieren.