Die Größe der Gewichte berechnen
Eine erste Schätzung geht von der Parameterzahl und dem Speicherplatz pro Parameter aus. Die ungefähre Formel lautet Parameter × Bits pro Parameter ÷ 8; das Ergebnis wird in Byte angegeben und bezeichnet nicht den gesamten Speicherbedarf für den Modellbetrieb. Beispielsweise entsprechen 7 Milliarden Parameter, die mit 32 Bit gespeichert werden, etwa 28 dezimalen GB an Gewichten. Bei 16 Bit sinkt die Schätzung auf etwa 14 GB.
Diese Zahlen beschreiben die statischen Gewichte und umfassen weder den KV-Cache noch Laufzeitpuffer oder den Speicherbedarf des Betriebssystems und anderer Anwendungen. Daher garantiert eine Modelldatei einer bestimmten Größe nicht, dass der Computer genügend Speicher zum Laden und zur Textgenerierung hat. Der tatsächliche Bedarf hängt auch von der Konfiguration und der Ausführungsmethode ab.
Quantisierung verringert den Speicherbedarf der Gewichte, indem sie mit geringerer Genauigkeit gespeichert werden, zum Beispiel in int8 oder int4, wobei möglichst viel Genauigkeit erhalten bleiben soll. Als rechnerischer Richtwert würden 7 Milliarden Werte mit vier Bit etwa 3,5 dezimalen GB entsprechen, bevor Metadaten und andere Kosten berücksichtigt werden. Das ist weder eine exakte Dateigröße noch eine genaue Angabe des Laufzeitspeichers: Methoden und Anforderungen unterscheiden sich je nach Modell, Hardware und Implementierung.
Eine geringere Genauigkeit kann einen Kompromiss bei der Qualität bedeuten. Hugging Face beschreibt verschiedene Quantisierungsmethoden mit Vor- und Nachteilen und weist darauf hin, dass die passende Option vom Anwendungsfall abhängt. Gehe nicht davon aus, dass jedes Modell und jede Aufgabe dieselbe Quantisierung gleich gut verträgt; teste das konkrete Format am besten mit den relevanten Aufgaben.
Kontext und KV-Cache
Während der Generierung speichert der KV-Cache Aufmerksamkeitsinformationen zu den verarbeiteten Tokens. Sein Speicherbedarf lässt sich nicht allein aus der Größe der Gewichte ableiten: Er hängt von Architektur und Konfiguration ab und steigt, wenn ein größerer Kontext verarbeitet wird. Deshalb können zwei Ausführungen desselben Modells unterschiedlich viel Speicher benötigen, wenn sie verschiedene Kontextlängen verwenden.
Ollama gibt für das Kontextfenster einen Standardwert von 4096 Tokens an und dokumentiert Möglichkeiten, ihn zu ändern. Der Standardwert des Servers lässt sich mit OLLAMA_CONTEXT_LENGTH festlegen; bei ollama run zeigt die Dokumentation /set parameter num_ctx 4096, und für die API den Parameter num_ctx. Der geeignete Wert hängt von der Aufgabe ab: Ein größerer Kontext ermöglicht möglicherweise die Verarbeitung weiterer Inhalte, kann aber auch den Speicherbedarf erhöhen.
Ollama ermöglicht außerdem, den Quantisierungstyp des KV-Caches über OLLAMA_KV_CACHE_TYPE auszuwählen. Laut Dokumentation muss dafür Flash Attention aktiviert sein; standardmäßig verwendet der Cache f16. q8_0 benötigt ungefähr halb so viel Speicher wie f16, bei einem als sehr gering beschriebenen Präzisionsverlust; q4_0 benötigt ungefähr ein Viertel, mit einem geringen bis mittleren Verlust, der bei langen Kontexten stärker auffallen kann. Die Auswirkungen auf die Qualität hängen vom Modell und von der Aufgabe ab.
Für den KV-Cache gibt es keine einzelne Speicherangabe, die für alle Modelle gilt. Ermittle vor der Dimensionierung das Modell, den vorgesehenen Kontext und die Cache-Konfiguration; überprüfe anschließend den Verbrauch auf dem Zielsystem. Ungefähre Angaben zu den Gewichten ersetzen diese Prüfung nicht.
Speicher addieren, ohne Schätzung und Bedarf zu verwechseln
Als Planungsgrundlage kannst du Gewichte + KV-Cache + Laufzeitspeicher berücksichtigen. Die Größe der Gewichte lässt sich mit der obigen Formel abschätzen, doch die verfügbaren Quellen nennen weder einen universellen Wert für Puffer noch eine allgemeine Regel, um die Summe in den erforderlichen RAM- oder VRAM-Bedarf umzurechnen. Der beobachtete Gesamtverbrauch hängt von Implementierung, Backend, Modell und Konfiguration ab.
Eine Tabelle hilft dabei, berechenbare Werte von zu messenden Werten zu unterscheiden:
| Komponente | Was sich schätzen lässt | Was überprüft werden sollte |
|---|---|---|
| Gewichte | Parameter × Bits pro Parameter ÷ 8, als Näherung | Modellgröße und Quantisierungsformat |
| KV-Cache | Ändert sich mit Kontext und Konfiguration | Speicherverbrauch beim vorgesehenen Kontext |
| Laufzeitspeicher | In den verfügbaren Quellen gibt es keinen universellen Wert | Tatsächlicher Runtime-Verbrauch und verfügbarer Spielraum |
| RAM und VRAM | Hängen davon ab, wo das Modell geladen wird | Von der verwendeten Anwendung angezeigte Verteilung |
Behandle die Berechnung der Gewichte in der Praxis nicht als garantierten Mindestbedarf. Lass Platz für das System und andere Anwendungen und miss eine tatsächliche Ausführung, bevor du den Kontext vergrößerst oder mehr Aufgaben parallel lädst. Ollama dokumentiert, dass parallele Anfragen den effektiven Kontext und die zusätzliche Speicherzuweisung vervielfachen können; die konkrete Auswirkung hängt von den Einstellungen und dem verfügbaren Speicher ab.
RAM, VRAM und Modellverteilung
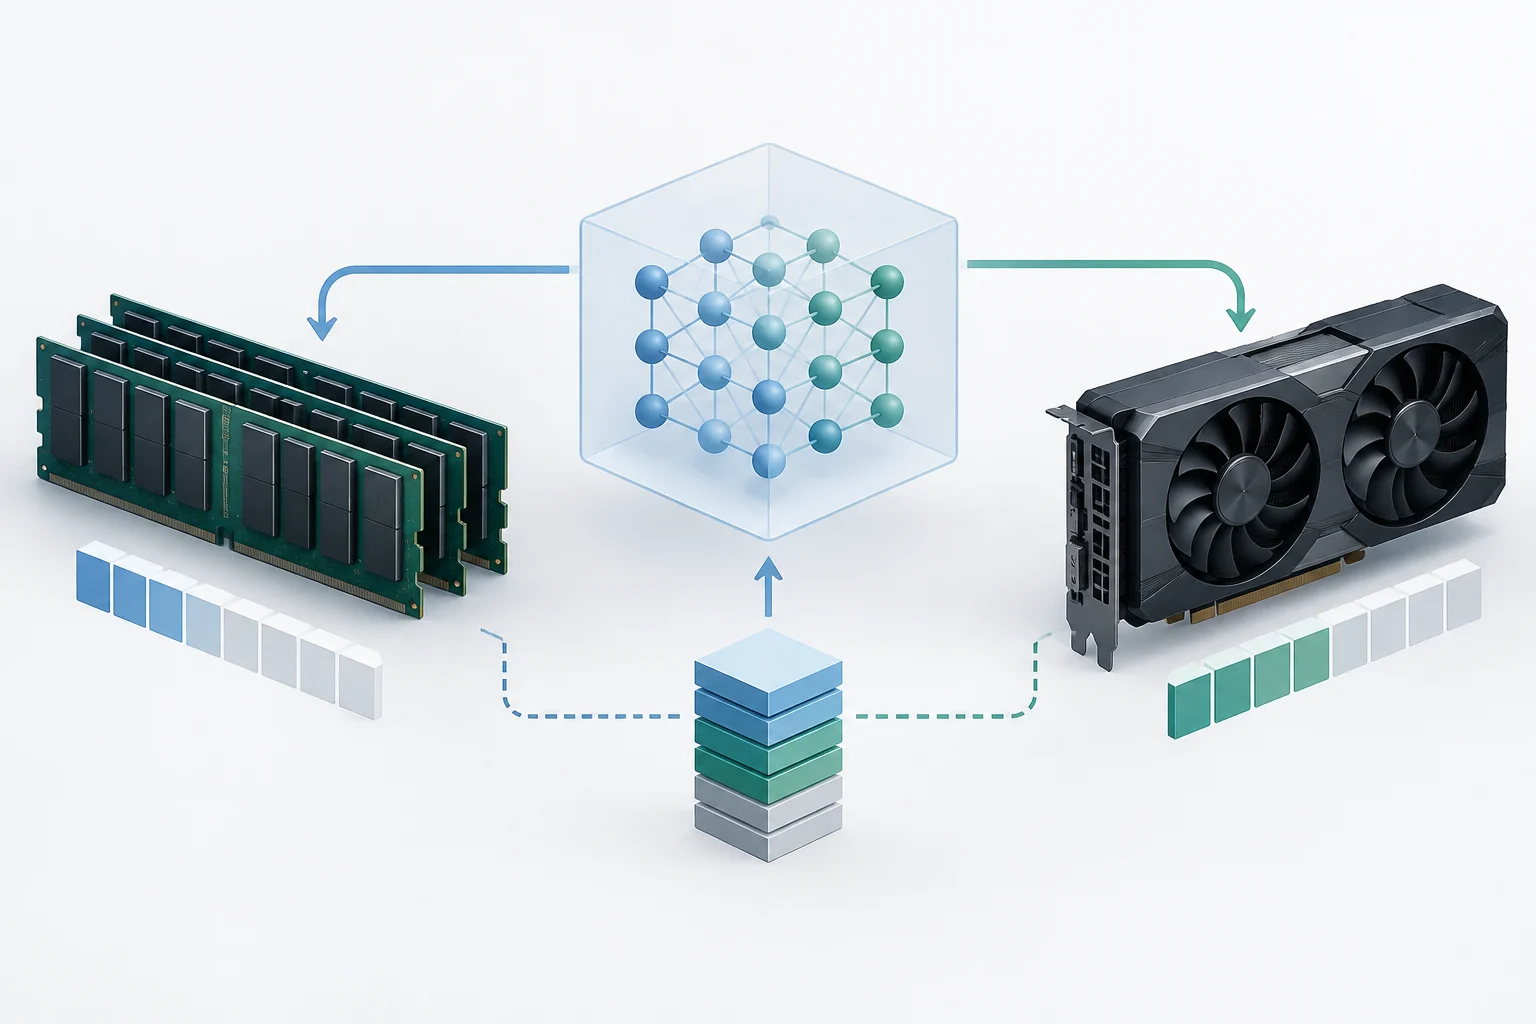
System-RAM und GPU-VRAM sind unterschiedliche Ressourcen. Je nach Runtime, Hardware und verfügbarem Speicher kann ein Modell in einen der beiden Speicher geladen oder auf beide verteilt werden. Allein aus der Größe der Gewichte lässt sich weder schließen, dass die Ausführung ausschließlich die GPU nutzt, noch dass sie auf jedem Computer schneller ist.
Um die Platzierung in Ollama zu prüfen, führe ollama ps aus und sieh dir die Spalte PROCESSOR an. Laut Dokumentation bedeutet 100% GPU, dass das Modell vollständig auf die GPU geladen wurde; 100% CPU bedeutet, dass es im Systemspeicher liegt; eine Angabe wie 48%\/52% CPU\/GPU zeigt eine Verteilung auf beide. Lies die Ausgabe als Beschreibung der Platzierung, nicht als Geschwindigkeitsmessung.
Der llama.cpp-Leitfaden zur Leistung erklärt, dass Diagnoseausgaben vor Beginn der Inferenz zeigen können, ob cuBLAS Arbeit auf die GPU auslagert. Zu den dokumentierten Beispielen gehören Zeilen, die an die GPU übergebene Layer und den verwendeten VRAM angeben. Wenn solche Meldungen erscheinen, wird laut Leitfaden die GPU genutzt; die konkrete Menge hängt von der Ausführung ab und ist keine allgemeine Anforderung.
Ollama erklärt, dass es beim Laden eines Modells den verfügbaren VRAM prüft: Passt das Modell vollständig auf eine GPU, wird es dort geladen; passt es nicht auf eine einzelne GPU, kann es auf die verfügbaren GPUs verteilt werden. Die Dokumentation verbindet das Laden auf eine einzelne GPU, sofern möglich, mit weniger Übertragungen über den PCI-Bus. Die tatsächliche Verteilung muss für jede Konfiguration geprüft werden.
Verbrauch prüfen und Konfiguration anpassen
Berechne zunächst einen Richtwert für die Gewichte und notiere den geplanten Kontext und Quantisierungstyp. Lade anschließend das Modell und prüfe mit ollama ps seine Größe und die Prozessor-Spalte. Wenn du llama.cpp mit CUDA verwendest, untersuche die Diagnosemeldungen beim Start, um festzustellen, ob Layer auf die GPU ausgelagert werden und wie viel VRAM als belegt gemeldet wird.
Auf NVIDIA-Systemen kann nvidia-smi dabei helfen, den belegten VRAM zu beobachten. Diese Anzeige und die Runtime-Werkzeuge beschreiben eine konkrete Ausführung; mache aus einer einzelnen Messung keinen allgemeingültigen Wert für andere Modelle, Kontexte oder Computer. Nähert sich der Verbrauch dem verfügbaren Speicher, verringere zuerst den Kontext oder prüfe Cache-Typ und Gewichtsquantisierung; miss danach erneut.
Für den Ollama-Kontext änderst du OLLAMA_CONTEXT_LENGTH oder verwendest num_ctx über die entsprechende Schnittstelle und folgst dabei der dokumentierten Methode für Server, Ausführung oder API. Für die Quantisierung des KV-Caches setzt du OLLAMA_KV_CACHE_TYPE und prüfst, ob Flash Attention aktiviert ist. q8_0 kommt infrage, wenn du Speicher mit einem als sehr gering beschriebenen Präzisionsverlust sparen möchtest; q4_0 solltest du vorsichtiger beurteilen, insbesondere bei langen Kontexten.
In llama.cpp steuert die Option -t N die Anzahl der Threads. Der Leitfaden empfiehlt, keinen zu hohen Wert zu verwenden, wenn die CPU überlastet wird, und zur Diagnose langsamer Generierung weniger Threads auszuprobieren. Dies ist weder eine Speichereinstellung noch eine garantierte Verbesserung: Das Ergebnis hängt von Rechner und Arbeitslast ab.
Ein praktischer Ablauf vor dem Start
Um den Speicherbedarf mit weniger Überraschungen zu bestimmen, gehst du in dieser Reihenfolge vor: Ermittle Parameterzahl und Genauigkeit der Gewichte; berechne ihre ungefähre Größe; lege einen realistischen Kontext fest; wähle, sofern die Konfiguration es erlaubt, einen Cache-Typ; und halte Spielraum für das System und andere Prozesse frei. Starte dann das Modell und vergleiche die Schätzung mit den verfügbaren Messwerkzeugen.
Passt die Ausführung nicht in den vorgesehenen Speicher, ändere jeweils nur eine Variable: Probiere einen kleineren Kontext, eine andere Gewichtsquantisierung oder, sofern aktiviert, eine Quantisierung des KV-Caches. Halte den beobachteten Verbrauch zusammen mit Modell und Konfiguration fest, damit der Vergleich aussagekräftig ist. Die beste Schätzung ist diejenige, die auf dem Zielsystem überprüft wurde, nicht ein isolierter Wert, der nur aus der Parameterzahl berechnet wurde.
Entscheidend ist, drei Dinge auseinanderzuhalten: wie viel Speicher die Parameter belegen, wie viel der laufende Betrieb zusätzlich benötigt und wo die einzelnen Teile liegen. Die erste Größe lässt sich mit einer einfachen Formel annähern; bei den anderen müssen Kontext und tatsächliches Runtime-Verhalten berücksichtigt werden. So wird vermieden, die Dateigröße eines Modells mit dem gesamten Speicherbedarf seiner Nutzung zu verwechseln.