Calcolare la dimensione dei pesi
Una prima stima parte dal numero di parametri e dallo spazio occupato da ciascuno. La formula approssimativa è parametri × bit per parametro ÷ 8; il risultato è espresso in byte, non nella memoria totale necessaria per eseguire il modello. Per esempio, 7 miliardi di parametri memorizzati a 32 bit corrispondono a circa 28 GB decimali di pesi. A 16 bit, la stima scende a circa 14 GB.
Questi numeri descrivono i pesi statici e non includono la KV cache, i buffer di esecuzione o la memoria necessaria al sistema operativo e alle altre applicazioni. Perciò, la dimensione di un file del modello non garantisce che il computer abbia memoria sufficiente per caricarlo e generare testo. Il fabbisogno finale dipende anche dalla configurazione e dal metodo di esecuzione.
La quantizzazione riduce la memoria occupata dai pesi memorizzandoli con precisione inferiore, per esempio in int8 o int4, cercando però di preservare quanto più possibile l’accuratezza. Come riferimento aritmetico, 7 miliardi di valori a quattro bit corrisponderebbero a circa 3,5 GB decimali prima di considerare metadati e altri costi. Non è una misura esatta del file né della memoria necessaria durante l’esecuzione: metodi e requisiti variano in base al modello, all’hardware e all’implementazione.
La riduzione della precisione può comportare un compromesso sulla qualità. Hugging Face descrive diversi metodi di quantizzazione con vantaggi e svantaggi e osserva che l’opzione adatta dipende dal caso d’uso. Non dare per scontato che tutti i modelli o tutte le attività tollerino allo stesso modo la medesima quantizzazione; conviene provare il formato specifico con le attività più importanti.
Contesto e KV cache
Durante la generazione, la KV cache conserva informazioni di attenzione relative ai token elaborati. Il suo consumo non si ricava soltanto dalla dimensione dei pesi: dipende dall’architettura e dalla configurazione e aumenta quando viene elaborato un contesto più ampio. Di conseguenza, due esecuzioni dello stesso modello possono richiedere quantità diverse di memoria se usano lunghezze di contesto differenti.
Ollama indica che la finestra di contesto predefinita è di 4096 token e documenta come modificarla. Il valore predefinito del server può essere impostato con OLLAMA_CONTEXT_LENGTH; usando ollama run, la documentazione mostra /set parameter num_ctx 4096, mentre per l’API indica il parametro num_ctx. Il valore adeguato dipende dall’attività: aumentare il contesto può consentire di elaborare più contenuti, ma può anche incrementare la memoria richiesta.
Ollama consente inoltre di selezionare il tipo di quantizzazione della KV cache tramite OLLAMA_KV_CACHE_TYPE. La documentazione specifica che questa opzione richiede Flash Attention attiva e che il valore predefinito della cache è f16. q8_0 usa circa la metà della memoria rispetto a f16, con una perdita di precisione descritta come molto ridotta; q4_0 usa circa un quarto, con una perdita da piccola a media che può risultare più evidente nei contesti lunghi. L’effetto sulla qualità dipende dal modello e dall’attività.
Non esiste un unico valore di memoria per la KV cache valido per tutti i modelli. Prima di dimensionare il sistema, individua il modello, il contesto previsto e la configurazione della cache; quindi verifica il consumo sul computer. Le stime approssimative dei pesi non sostituiscono questa verifica.
Sommare la memoria senza confondere stima e requisito
Come schema di pianificazione, considera pesi + KV cache + memoria di esecuzione. La dimensione dei pesi si può approssimare con la formula precedente, ma le fonti disponibili non forniscono un valore universale per i buffer né una regola generale per convertire quella somma nella RAM o VRAM necessaria. Il totale osservato dipende dall’implementazione, dal backend, dal modello e dalla configurazione.
Una tabella aiuta a distinguere ciò che si può calcolare da ciò che è opportuno misurare:
| Componente | Che cosa si può stimare | Che cosa verificare |
|---|---|---|
| Pesi | Parametri × bit per parametro ÷ 8, come approssimazione | Dimensione del modello e formato di quantizzazione |
| KV cache | Varia con il contesto e la configurazione | Uso della memoria durante l’esecuzione con il contesto previsto |
| Memoria di esecuzione | Le fonti disponibili non forniscono un valore universale | Consumo effettivo del runtime e margine disponibile |
| RAM e VRAM | Dipendono da dove viene caricato il modello | Distribuzione indicata dallo strumento utilizzato |
In pratica, evita di considerare il calcolo dei pesi come un requisito minimo garantito. Lascia spazio per il sistema e le altre applicazioni e misura un’esecuzione reale prima di aumentare il contesto o caricare più attività in parallelo. Ollama documenta che le richieste parallele possono moltiplicare il contesto effettivo e l’allocazione di memoria aggiuntiva; l’effetto concreto dipende dalle impostazioni e dalla memoria disponibile.
RAM, VRAM e distribuzione del modello
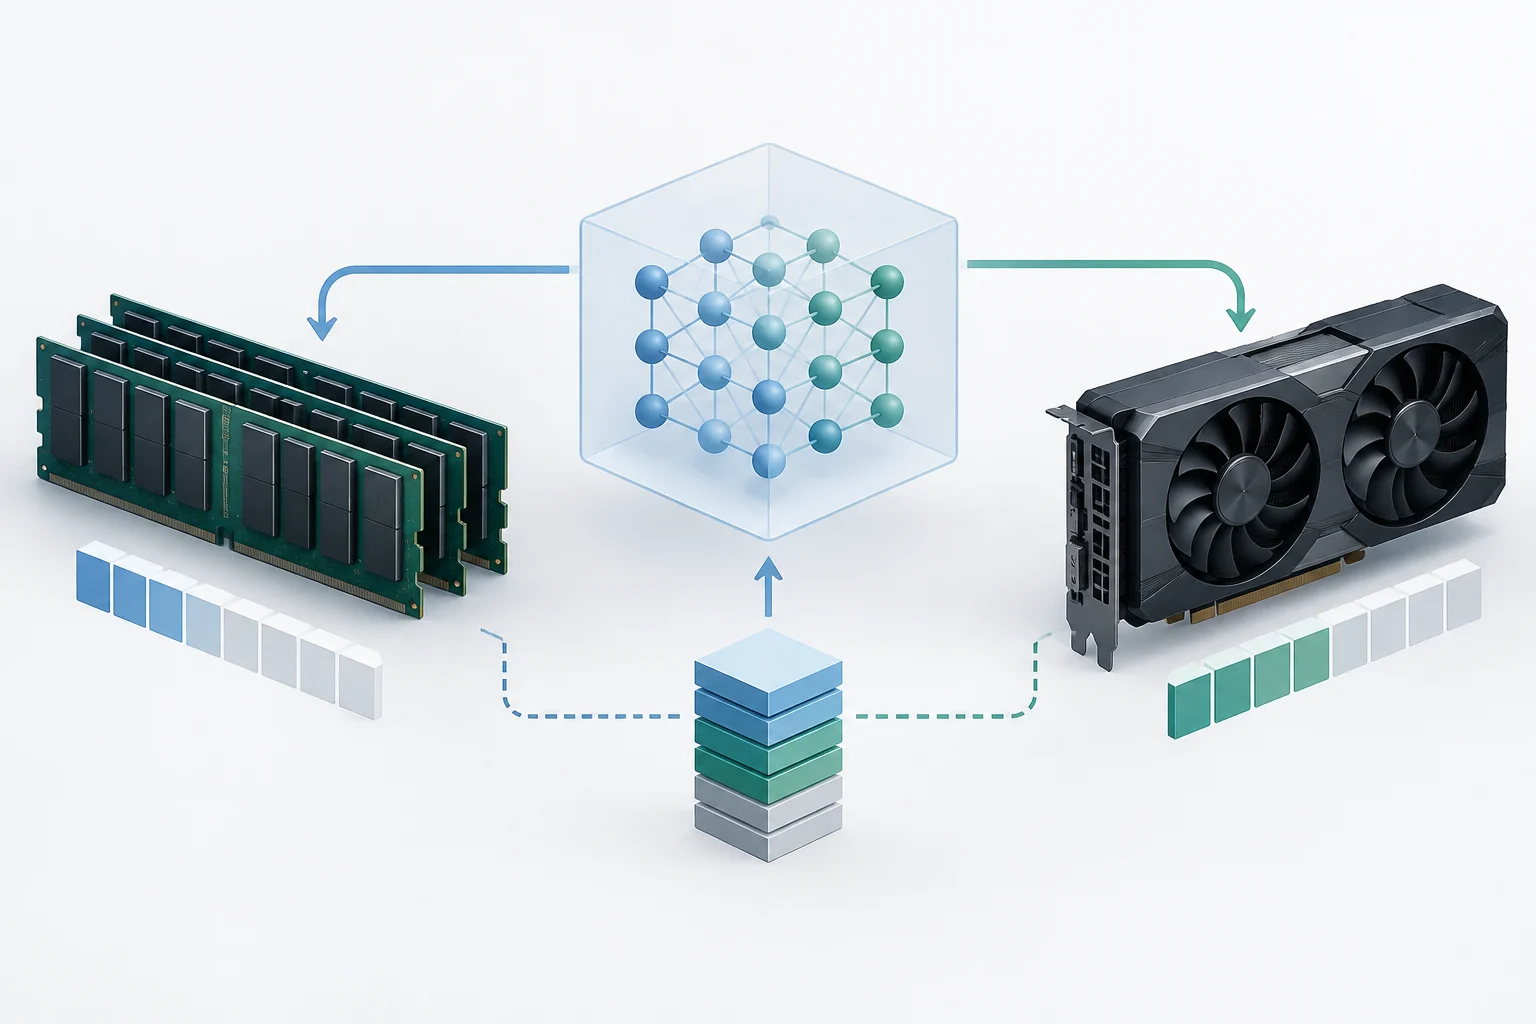
La RAM di sistema e la VRAM della GPU sono risorse distinte. A seconda del runtime, dell’hardware e della memoria disponibile, un modello può essere caricato in una delle due oppure suddiviso tra entrambe. La sola dimensione dei pesi non permette di concludere che l’esecuzione userà esclusivamente la GPU o sarà più veloce su qualsiasi computer.
Per verificare la posizione in Ollama, esegui ollama ps e consulta la colonna PROCESSOR. Secondo la documentazione, 100% GPU significa che il modello è stato caricato interamente sulla GPU; 100% CPU indica che è stato caricato nella memoria di sistema; una dicitura come 48%\/52% CPU\/GPU indica che è stato distribuito tra entrambe. Interpreta l’output come una descrizione del caricamento, non come una misurazione della velocità.
In llama.cpp, la guida alle prestazioni indica che, prima dell’inizio dell’inferenza, l’output diagnostico può mostrare se cuBLAS sta trasferendo lavoro alla GPU. Tra gli esempi documentati figurano righe che indicano i layer inviati alla GPU e la VRAM utilizzata. Quando compaiono questi messaggi, la guida segnala che la GPU è in uso; la quantità specifica dipende dall’esecuzione e non va considerata un requisito generale.
Ollama spiega che, quando carica un modello, valuta la VRAM disponibile: se il modello entra interamente in una GPU, lo carica lì; se non entra in una sola GPU, può distribuirlo tra le GPU disponibili. La documentazione associa, quando possibile, il caricamento su un’unica GPU a un minor numero di trasferimenti sul bus PCI. La distribuzione effettiva va verificata per ogni configurazione.
Verificare l’uso e regolare la configurazione
Per prima cosa, calcola un valore di riferimento per i pesi e annota il contesto e il tipo di quantizzazione che intendi usare. Poi carica il modello e consulta ollama ps per verificarne la dimensione e la colonna del processore. Se usi llama.cpp con CUDA, esamina i messaggi diagnostici all’avvio per controllare se i layer vengono trasferiti alla GPU e quanta VRAM risulta utilizzata.
Nei sistemi NVIDIA, nvidia-smi può aiutare a osservare la VRAM occupata. Questa lettura e gli strumenti del runtime descrivono una specifica esecuzione; non trasformare una misurazione occasionale in un valore universale per altri modelli, contesti o computer. Se il consumo si avvicina alla memoria disponibile, riduci prima il contesto oppure rivedi il tipo di cache e la quantizzazione dei pesi, quindi misura di nuovo.
Per il contesto di Ollama, modifica OLLAMA_CONTEXT_LENGTH oppure usa num_ctx tramite l’interfaccia corrispondente, seguendo il metodo documentato per server, esecuzione o API. Per quantizzare la KV cache, imposta OLLAMA_KV_CACHE_TYPE e verifica che Flash Attention sia attiva. Valuta q8_0 se vuoi ridurre la memoria con una perdita di precisione descritta come molto ridotta; considera q4_0 con maggiore cautela, soprattutto nei contesti lunghi.
In llama.cpp, l’opzione -t N controlla il numero di thread. La guida consiglia di evitare un valore eccessivamente alto se la CPU è sovraccarica e propone di provare con meno thread per diagnosticare una generazione lenta. Non è un’impostazione della memoria né un miglioramento garantito: il risultato dipende dalla macchina e dal carico.
Una procedura pratica prima dell’esecuzione
Per dimensionare la memoria con meno sorprese, procedi in questo ordine: individua il numero di parametri e la precisione dei pesi; calcola la loro dimensione approssimativa; imposta un contesto realistico; scegli il tipo di cache, se la configurazione lo consente; e lascia margine per il sistema e gli altri processi. Poi esegui il modello e confronta la stima con gli strumenti disponibili.
Se l’esecuzione non rientra nella memoria prevista, cambia una variabile alla volta: prova un contesto più breve, un’altra quantizzazione dei pesi oppure, se attiva, la quantizzazione della KV cache. Registra l’uso osservato insieme al modello e alla configurazione, così il confronto sarà utile. La stima migliore è quella convalidata sul computer di destinazione, non un valore isolato calcolato soltanto dal numero di parametri.
Il criterio essenziale è distinguere tre aspetti: quanto occupano i parametri, quanta memoria aggiunge l’esecuzione e dove viene collocata ciascuna parte. Il primo valore si può approssimare con una formula semplice; per gli altri occorre considerare il contesto e verificare il comportamento del runtime. In questo modo si evita di confondere la dimensione di un modello con la memoria totale necessaria per usarlo.