Calcular o tamanho dos pesos
Uma primeira estimativa considera o número de parâmetros e o espaço ocupado por cada um. A fórmula aproximada é parâmetros × bits por parâmetro ÷ 8; o resultado é expresso em bytes, não corresponde à memória total necessária para executar o modelo. Por exemplo, 7 bilhões de parâmetros armazenados a 32 bits equivalem a cerca de 28 GB decimais de pesos. A 16 bits, a estimativa cai para cerca de 14 GB.
Esses números descrevem os pesos estáticos e não incluem o KV cache, os buffers de execução nem a memória necessária para o sistema operacional e outros aplicativos. Portanto, o tamanho de um arquivo de modelo não garante que o computador tenha memória suficiente para carregá-lo e gerar texto. A demanda final também depende da configuração e do método de execução.
A quantização reduz a memória ocupada pelos pesos ao armazená-los com menor precisão, por exemplo em int8 ou int4, embora procure preservar o máximo possível da exatidão. Como referência aritmética, 7 bilhões de valores a quatro bits corresponderiam a cerca de 3,5 GB decimais antes de considerar metadados e outros custos. Essa não é uma medida exata do arquivo nem da memória necessária durante a execução: os métodos e requisitos variam conforme o modelo, o hardware e a implementação.
A redução de precisão pode envolver uma troca na qualidade. A Hugging Face descreve diferentes métodos de quantização, com vantagens e desvantagens, e observa que a opção adequada depende do caso de uso. Não presuma que todos os modelos ou tarefas toleram igualmente a mesma quantização; vale a pena testar o formato específico nas tarefas mais importantes.
Contexto e KV cache
Durante a geração, o KV cache conserva informações de atenção dos tokens processados. Seu consumo não pode ser calculado apenas com base no tamanho dos pesos: depende da arquitetura e da configuração, e aumenta quando se processa um contexto maior. Por isso, duas execuções do mesmo modelo podem exigir quantidades diferentes de memória se usarem comprimentos de contexto distintos.
Ollama informa que sua janela de contexto padrão é de 4096 tokens e documenta maneiras de alterá-la. O padrão do servidor pode ser definido com OLLAMA_CONTEXT_LENGTH; ao usar ollama run, a documentação mostra /set parameter num_ctx 4096, e, para a API, o parâmetro num_ctx. O valor adequado depende da tarefa: aumentar o contexto pode permitir processar mais conteúdo, mas também pode elevar a memória necessária.
Ollama também permite selecionar o tipo de quantização do KV cache por meio de OLLAMA_KV_CACHE_TYPE. A documentação informa que essa opção exige que Flash Attention esteja habilitada e que o padrão do cache é f16. q8_0 usa aproximadamente metade da memória de f16, com uma perda de precisão descrita como muito pequena; q4_0 usa aproximadamente um quarto, com uma perda pequena ou média que pode ser mais perceptível em contextos longos. O efeito na qualidade depende do modelo e da tarefa.
Não existe um único valor de memória para o KV cache que sirva para todos os modelos. Antes de dimensionar o sistema, identifique o modelo, o contexto previsto e a configuração do cache; depois, confirme o consumo no computador. As estimativas aproximadas dos pesos não substituem essa verificação.
Somar a memória sem confundir estimativa e requisito
Como esquema de planejamento, considere pesos + KV cache + memória de execução. O tamanho dos pesos pode ser estimado com a fórmula anterior, mas as fontes disponíveis não apresentam um valor universal para os buffers nem uma regra geral para converter essa soma na RAM ou VRAM necessária. O total observado depende da implementação, do backend, do modelo e da configuração.
Uma tabela ajuda a separar o que pode ser calculado daquilo que convém medir:
| Componente | O que é possível estimar | O que convém verificar |
|---|---|---|
| Pesos | Parâmetros × bits por parâmetro ÷ 8, como aproximação | Tamanho do modelo e formato de quantização |
| KV cache | Varia com o contexto e a configuração | Uso de memória ao executar o contexto previsto |
| Memória de execução | As fontes disponíveis não apresentam um valor universal | Consumo real do runtime e margem disponível |
| RAM e VRAM | Dependem de onde o modelo é carregado | Distribuição informada pela ferramenta utilizada |
Na prática, evite tratar o cálculo dos pesos como um requisito mínimo garantido. Reserve espaço para o sistema e outros aplicativos e meça uma execução real antes de aumentar o contexto ou carregar mais tarefas em paralelo. Ollama documenta que solicitações paralelas podem multiplicar o contexto efetivo e a alocação adicional de memória; o efeito concreto depende das configurações e da memória disponível.
RAM, VRAM e distribuição do modelo
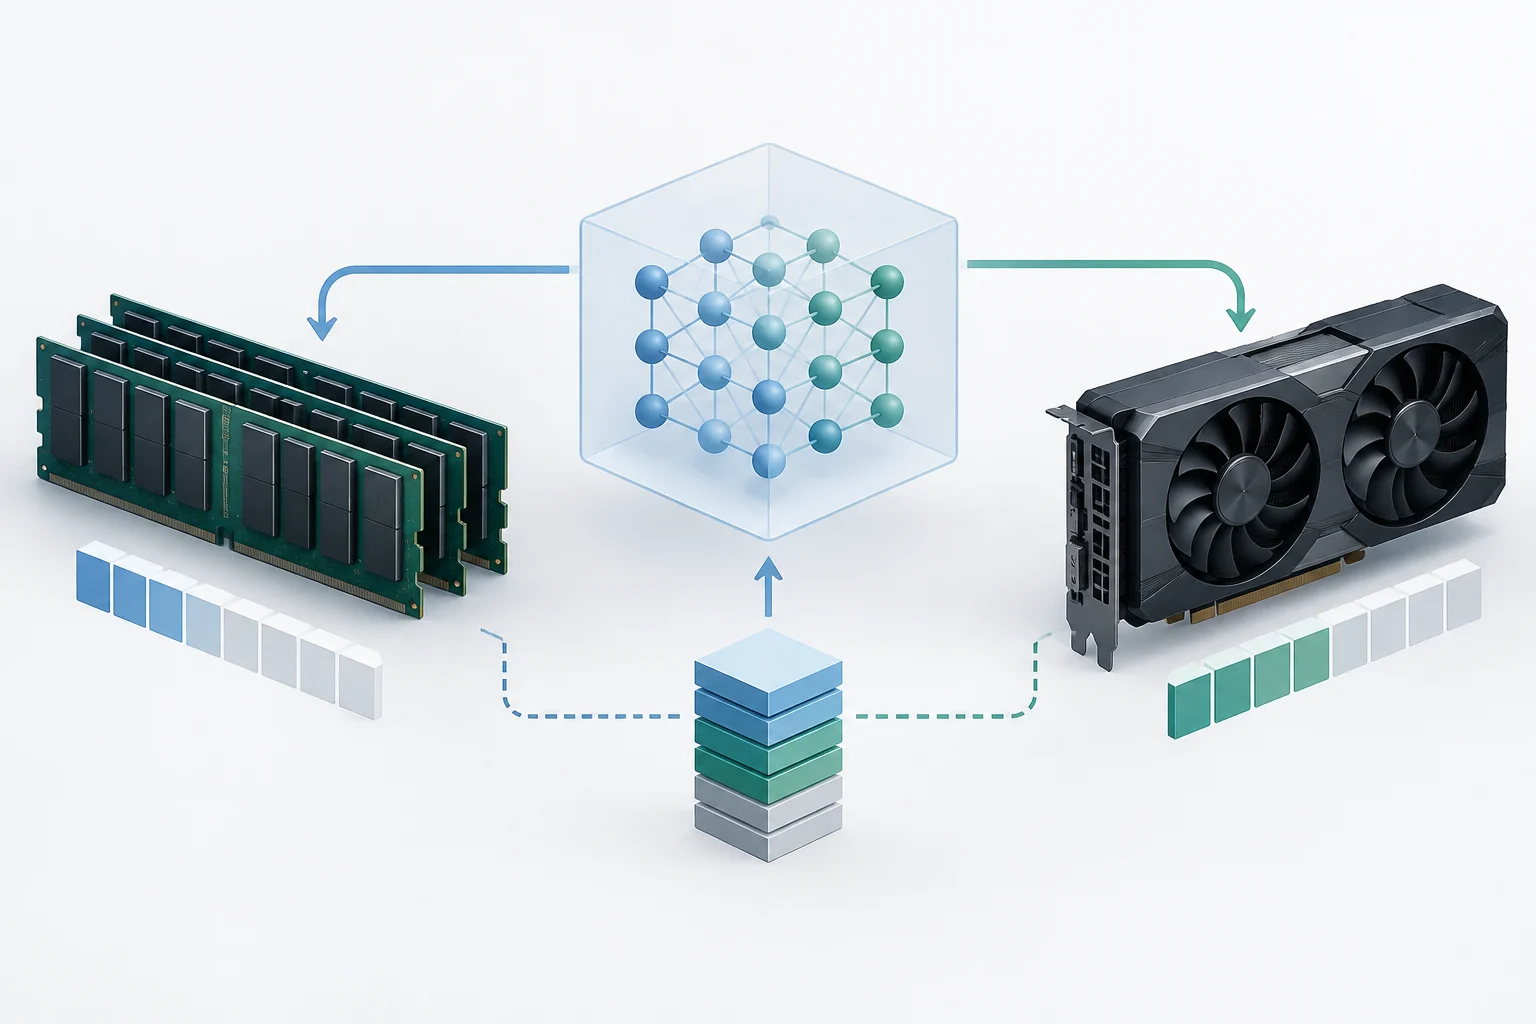
A RAM do sistema e a VRAM da GPU são recursos distintos. Dependendo do runtime, do hardware e da memória disponível, um modelo pode ser carregado em uma delas ou distribuído entre as duas. O tamanho dos pesos, por si só, não permite concluir que a execução usará exclusivamente a GPU nem que será mais rápida em qualquer computador.
Para verificar a localização no Ollama, execute ollama ps e consulte a coluna PROCESSOR. Segundo a documentação, 100% GPU significa que o modelo foi carregado totalmente na GPU; 100% CPU indica que foi carregado na memória do sistema; e uma indicação como 48%\/52% CPU\/GPU significa que foi distribuído entre ambas. Interprete a saída como uma descrição do carregamento, não como uma medição de velocidade.
No llama.cpp, o guia de desempenho informa que, antes do início da inferência, a saída de diagnóstico pode mostrar se o cuBLAS está transferindo trabalho para a GPU. Entre os exemplos documentados estão linhas que informam as camadas enviadas à GPU e a VRAM utilizada. Quando essas mensagens aparecem, o guia indica que a GPU está sendo usada; a quantidade concreta depende da execução e não deve ser considerada um requisito geral.
Ollama explica que, ao carregar um modelo, avalia a VRAM disponível: se o modelo couber inteiramente em uma GPU, ele será carregado nela; se não couber em uma única GPU, poderá ser distribuído entre as GPUs disponíveis. A documentação associa, quando possível, o carregamento em uma única GPU a menos transferências pelo barramento PCI. A distribuição real deve ser verificada em cada configuração.
Verificar o uso e ajustar a configuração
Primeiro, calcule uma referência para os pesos e anote o contexto e o tipo de quantização que pretende usar. Em seguida, carregue o modelo e consulte ollama ps para verificar seu tamanho e a coluna do processador. Se usar llama.cpp com CUDA, examine as mensagens de diagnóstico na inicialização para confirmar se há camadas transferidas para a GPU e quanta VRAM aparece como utilizada.
Em sistemas NVIDIA, nvidia-smi pode ajudar a observar a VRAM ocupada. Essa leitura e as ferramentas do runtime refletem uma execução específica; não transforme uma medição pontual em um valor universal para outros modelos, contextos ou computadores. Se o consumo se aproximar da memória disponível, reduza primeiro o contexto ou revise o tipo de cache e a quantização dos pesos; depois, meça novamente.
Para o contexto do Ollama, altere OLLAMA_CONTEXT_LENGTH ou use num_ctx pela interface correspondente, seguindo o método documentado para servidor, execução ou API. Para quantizar o KV cache, configure OLLAMA_KV_CACHE_TYPE e verifique se Flash Attention está habilitada. Considere q8_0 se quiser reduzir a memória com uma perda de precisão descrita como muito pequena; avalie q4_0 com mais cautela, sobretudo em contextos longos.
No llama.cpp, a opção -t N controla o número de threads. O guia recomenda evitar um valor muito alto se a CPU ficar sobrecarregada e sugere testar menos threads para diagnosticar a geração lenta. Esse ajuste não é de memória nem garante uma melhoria: o resultado depende da máquina e da carga de trabalho.
Uma rotina prática antes de executar
Para dimensionar a memória com menos surpresas, siga esta ordem: identifique o número de parâmetros e a precisão dos pesos; calcule o tamanho aproximado deles; defina um contexto realista; escolha o tipo de cache, se a configuração permitir; e deixe uma margem para o sistema e os demais processos. Depois, execute o modelo e compare a estimativa com as ferramentas disponíveis.
Se a execução não couber na memória prevista, altere uma variável de cada vez: teste um contexto menor, outra quantização dos pesos ou, quando habilitada, a quantização do KV cache. Registre o uso observado junto com o modelo e a configuração para que a comparação seja útil. A melhor estimativa é a validada no computador de destino, não um valor isolado calculado apenas a partir do número de parâmetros.
O essencial é distinguir três coisas: quanto os parâmetros ocupam, quanto a execução acrescenta e onde cada parte fica armazenada. A primeira quantidade pode ser aproximada com uma fórmula simples; as demais exigem considerar o contexto e verificar o comportamento do runtime. Assim, evita-se confundir o tamanho do arquivo de um modelo com a memória total necessária para usá-lo.