O que significa inferência local
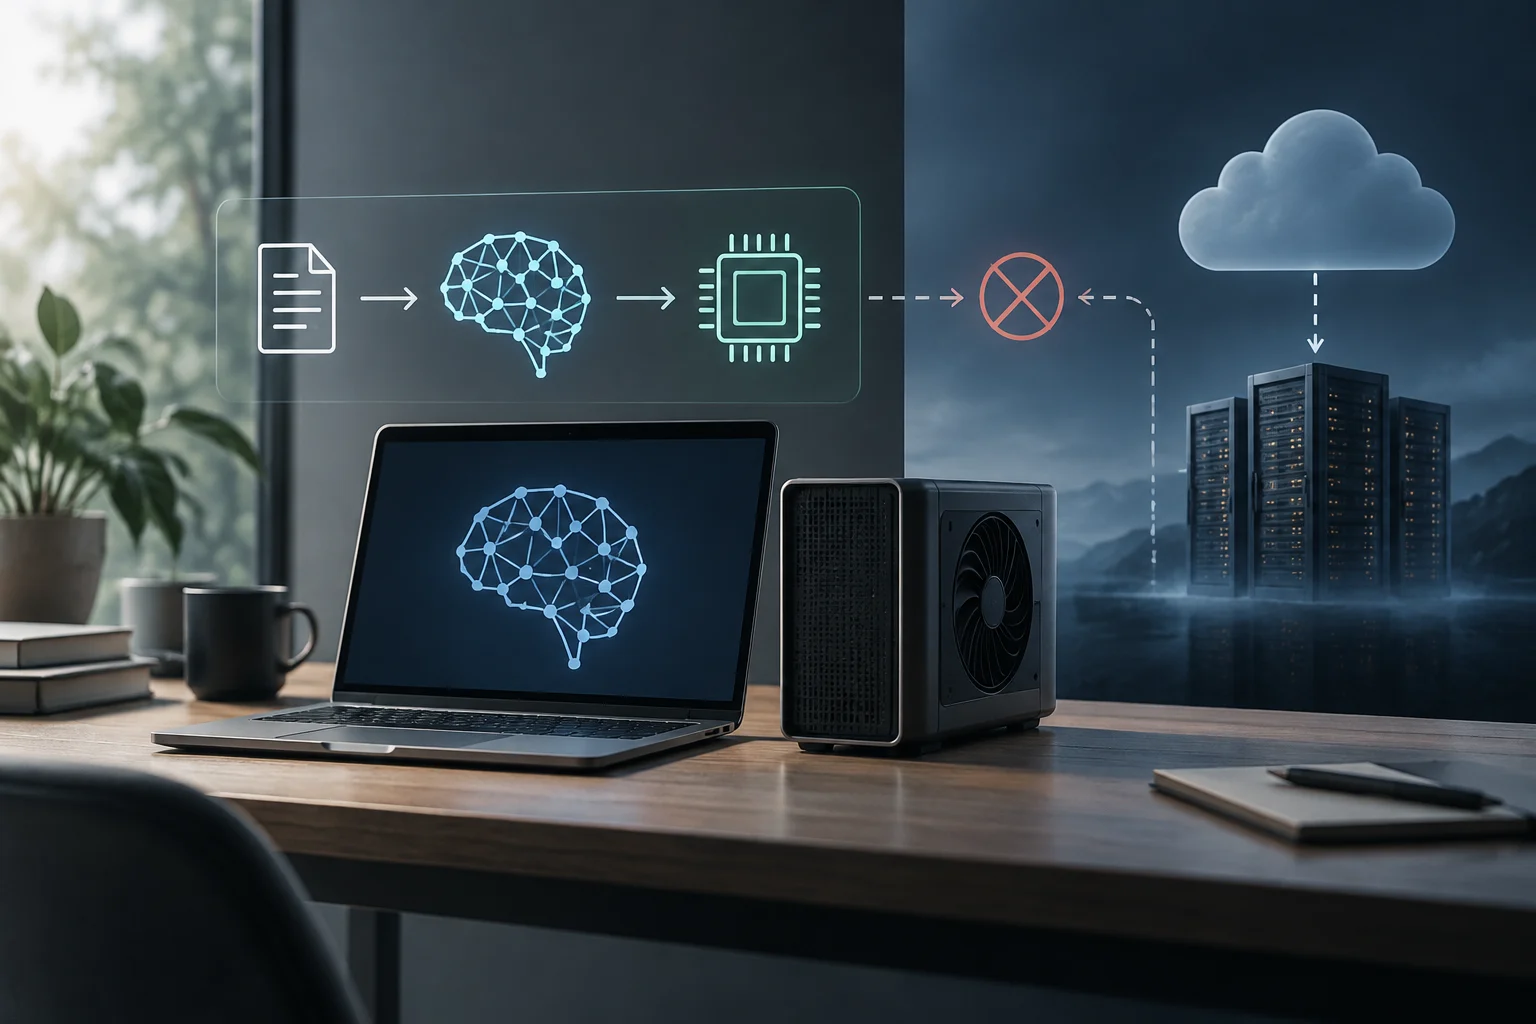
A inferência local consiste em executar um modelo de inteligência artificial no dispositivo do utilizador ou numa infraestrutura controlada pela sua organização. O modelo já foi treinado: recebe uma entrada, calcula uma resposta e devolve-a. Por exemplo, um assistente de texto pode gerar uma continuação; uma câmara pode classificar uma imagem.
A palavra local descreve o local onde o cálculo ocorre, não quem criou o modelo nem a forma como foi obtido. Um modelo de pesos abertos descarregado de um repositório pode ser executado num computador próprio; o mesmo pode acontecer com um modelo distribuído por um fornecedor. O essencial é que o pedido seja processado no dispositivo ou no ambiente local, em vez de ser enviado para um serviço remoto para gerar a resposta.
Não se deve confundir inferência com treino. Treinar ajusta os parâmetros do modelo com base em dados; inferir usa um modelo preparado para produzir um resultado perante uma nova entrada. A inferência pode incluir operações adicionais, como recuperar documentos ou chamar uma ferramenta, sem que essas tarefas alterem o significado básico do termo.
O percurso de um pedido
Numa aplicação local, começa-se por selecionar um modelo compatível e carregar os respetivos ficheiros para o armazenamento e a memória necessários. A aplicação prepara a entrada — por exemplo, converte uma imagem para a representação esperada por um modelo visual ou transforma texto em tokens — e o motor de execução distribui o cálculo pela CPU, GPU ou outros aceleradores disponíveis. Depois, a aplicação converte a saída interna em texto, etiquetas, pontuações ou outro resultado utilizável.
Dos dados à resposta
Num modelo de linguagem, o texto é dividido em tokens e processado com o contexto pertinente. O modelo calcula uma distribuição de possíveis tokens seguintes, e o método de geração seleciona um; o processo repete-se até a resposta estar concluída. O resultado depende dos pesos, mas também da configuração, do contexto e da estratégia de geração. O motor de inferência não substitui o modelo: fornece o ambiente que carrega e executa as suas operações.
Em visão computacional, o percurso pode começar com uma imagem captada por uma câmara. O programa adapta-a ao tamanho e formato de entrada necessários, executa o modelo e converte os tensores de saída em objetos detetados, categorias ou coordenadas. Em sistemas de edge, como uma câmara ou um equipamento industrial, o dispositivo pode depois enviar um alerta ou um resumo, em vez de transmitir continuamente os dados originais. Essa abordagem pode poupar largura de banda, embora dependa da forma como a aplicação foi construída e de eventuais transmissões por outros canais.
GPU, VRAM e RAM: que recursos limitam o modelo
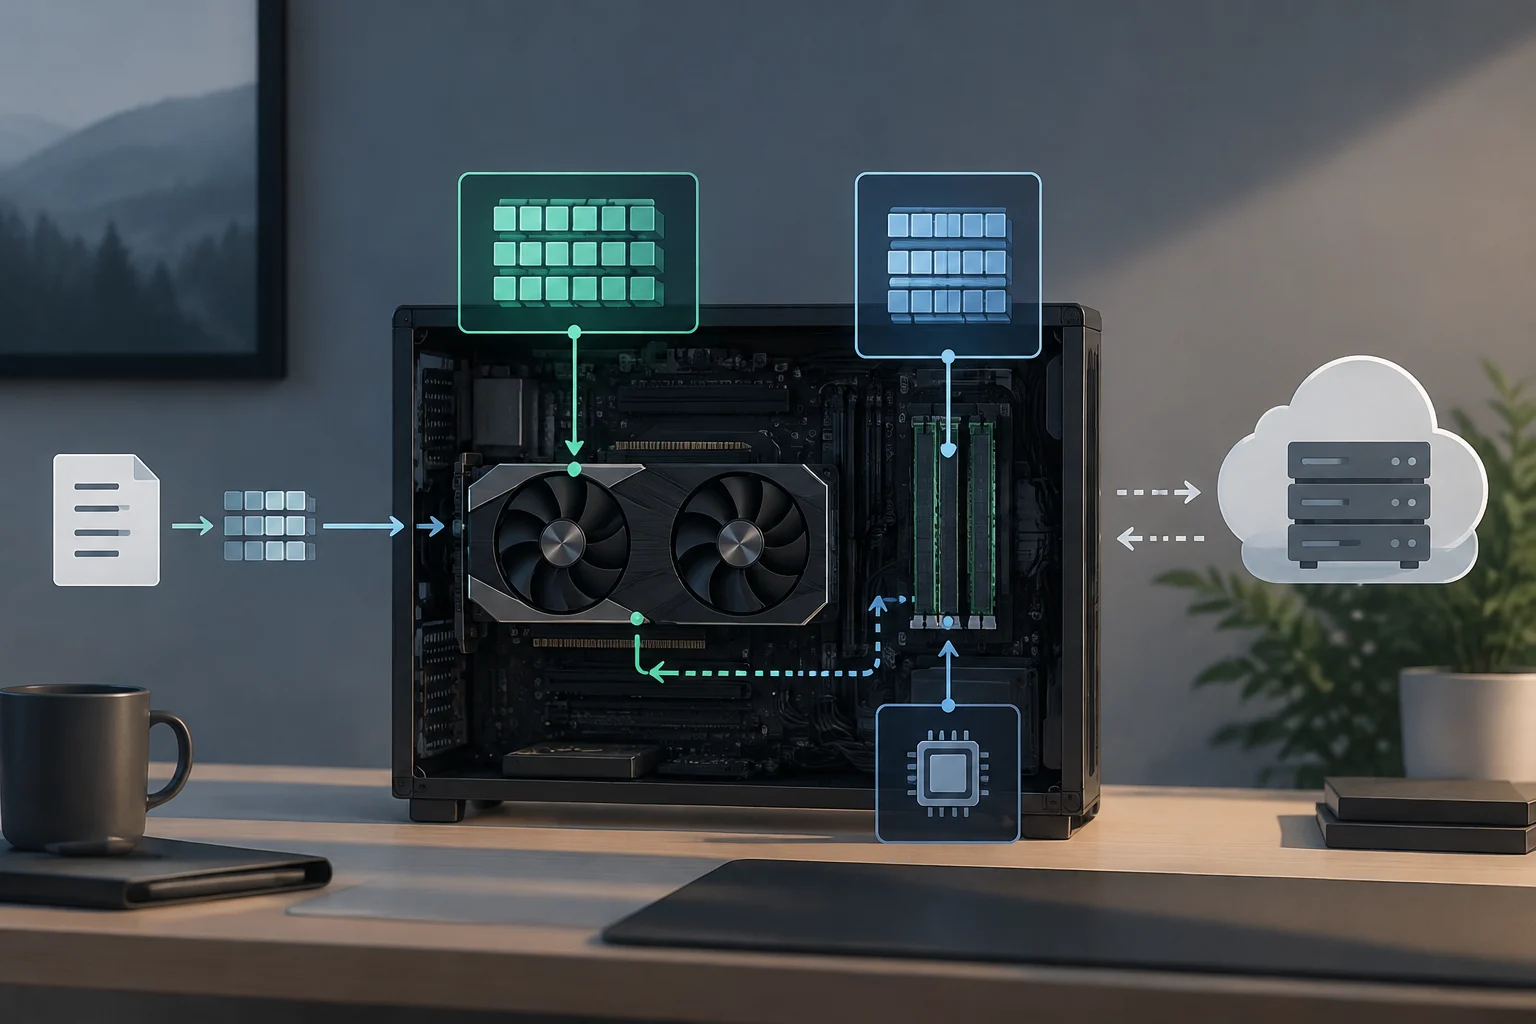
A viabilidade depende de o modelo e os dados de trabalho caberem na memória disponível e de o dispositivo conseguir executar os cálculos a uma velocidade adequada. Numa GPU dedicada, a VRAM armazena os pesos e outros dados necessários ao acelerador. A RAM do sistema aloja o processo, pode conter partes do modelo e permite a execução na CPU ou apoiar uma configuração em que o modelo não cabe totalmente na GPU. Estes recursos não são permutáveis sem custos: transferir dados entre memórias pode reduzir o desempenho.
A GPU pode acelerar operações paralelas comuns nas redes neuronais, mas não é um requisito universal. Um modelo pode ser executado numa CPU se o software e o formato o permitirem; normalmente será mais lento, mas não necessariamente impossível. Alguns dispositivos também têm uma NPU ou outros aceleradores, cuja utilização depende do suporte do motor de execução e do modelo. A compatibilidade do conjunto é tão importante como o nome do componente: o sistema operativo, o controlador, o formato do modelo e o motor têm de funcionar em conjunto.
O tamanho do ficheiro do modelo dá uma primeira indicação, mas não representa, por si só, toda a memória necessária durante a inferência. Também contam a precisão ou quantização dos pesos, o comprimento do contexto, o tamanho do lote e a memória temporária criada durante a execução. Num modelo de linguagem, um contexto mais longo pode aumentar o consumo de memória; por isso, é mais prudente deixar margem do que dimensionar o dispositivo exatamente ao tamanho do ficheiro descarregado.
Um guia de hardware da PromptQuorum apresenta uma regra indicativa para determinados modelos de linguagem quantizados: cerca de 4–5 GB para um modelo de 7 mil milhões de parâmetros em Q4_K_M e cerca de 40 GB para um modelo de 70 mil milhões nessa quantização. São estimativas para uma configuração específica, não requisitos universais nem uma garantia de velocidade: o formato, o contexto e o motor podem alterar o consumo real. Para escolher um equipamento, consulte as especificações do modelo e meça o desempenho com a carga de trabalho prevista.
Local ou cloud: diferenças que influenciam a decisão
Na inferência remota, a aplicação envia um pedido a um servidor através de uma API e recebe a resposta pela rede. O fornecedor gere o hardware do serviço; o utilizador evita instalar e manter o modelo nesse sistema, mas deve considerar a conectividade, as condições do serviço e o tratamento dos dados enviados. Com a inferência local, a organização assume a transferência, a implementação, a compatibilidade e a manutenção; o cálculo pode continuar sem ligação externa se a aplicação não depender de outros serviços.
| Critério | Inferência local | Inferência na cloud ou por API |
|---|---|---|
| Local do cálculo | Dispositivo ou infraestrutura local | Servidores remotos do fornecedor ou operador |
| Ligação durante o pedido | Pode funcionar sem Internet se o modelo e a aplicação estiverem disponíveis localmente | O pedido depende da ligação ao serviço |
| Dados de entrada | Podem permanecer no ambiente local; é necessário avaliar o resto da aplicação | São transmitidos ao serviço para processamento, conforme a configuração |
| Recursos e operação | O equipamento próprio limita a memória e a capacidade; o utilizador gere modelos e atualizações | O fornecedor disponibiliza capacidade e gere parte da infraestrutura |
| Custo | Hardware, eletricidade, armazenamento e manutenção; não equivale a custo zero | Pode ser cobrado por utilização ou capacidade, consoante o serviço |
A tabela resume diferenças de arquitetura; não garante privacidade, rapidez ou preço de um serviço específico. O envio de um pedido para a cloud não determina, por si só, durante quanto tempo será conservado nem quem poderá aceder-lhe: essas condições dependem do fornecedor, da configuração e do contrato.
A latência não tem um vencedor automático. O processamento local evita o percurso de rede até ao servidor, o que pode beneficiar uma aplicação interativa ou um dispositivo com ligação irregular. No entanto, uma GPU remota potente pode calcular mais depressa do que um equipamento modesto, enquanto um modelo local de grandes dimensões pode demorar demasiado para a utilização prevista. É importante distinguir o tempo de comunicação do tempo de cálculo e avaliar o percurso completo.
Os custos seguem uma lógica semelhante. Executar um modelo num equipamento que já existe evita uma tarifa por pedido se não for utilizado um serviço pago, mas não elimina os custos de compra, energia, apoio, substituição e manutenção. Na cloud, a despesa pode crescer com a utilização; em contrapartida, é possível aceder a recursos que não estão instalados em cada dispositivo. A decisão mais útil compara o custo total para uma carga de trabalho e um período definidos, sem equiparar “local” a gratuito ou “cloud” a mais caro.
Privacidade, segurança e limites práticos
O processamento local pode reduzir a necessidade de enviar o conteúdo do pedido para um fornecedor remoto. Isso reduz uma via de exposição, mas não garante privacidade por si só. A aplicação pode sincronizar registos, consultar um serviço externo ou enviar telemetria; as permissões do sistema, o acesso por outros utilizadores e a proteção do dispositivo também são relevantes.
A execução local transfere responsabilidades para a equipa que opera o dispositivo ou serviço. É preciso manter o modelo e o software atualizados, controlar quem pode aceder ao serviço local e verificar a origem e as condições de utilização dos modelos. Numa organização, instalar software nos próprios servidores também não significa que os dados estejam automaticamente isolados: a rede, as credenciais, os registos, as cópias de segurança e a configuração de cada componente são importantes.
Em termos de capacidade, o equipamento local costuma impor um limite prático ao tamanho e à complexidade do modelo, ao contexto que consegue processar e ao número de pedidos simultâneos. Um modelo mais pequeno pode servir bem para uma tarefa delimitada, mas não tem necessariamente o desempenho de um sistema remoto mais potente em todas as tarefas. A qualidade depende do modelo e do caso de utilização, não apenas do local onde é executado.
Há também custos de operação que não aparecem numa tarifa por token: preparar o ambiente, descarregar ficheiros, resolver incompatibilidades, acompanhar recursos e distribuir atualizações. A manutenção pode ser simples num dispositivo individual; numa frota empresarial, transforma-se numa tarefa de implementação e apoio. A inferência local oferece controlo sobre o ambiente, mas esse controlo implica trabalho técnico.
Motores de execução e ferramentas
As ferramentas locais ocupam camadas distintas. Um motor de inferência executa operações do modelo; uma aplicação de ambiente de trabalho pode acrescentar um catálogo, uma interface de conversa e controlos; e um servidor local oferece uma interface para outras aplicações enviarem pedidos. Antes de escolher, convém distinguir essas funções e verificar os formatos, aceleradores e sistemas operativos suportados por cada opção.
A Microsoft documenta o Foundry Local como uma ferramenta para descarregar e executar modelos compatíveis em dispositivos Windows, usando a aceleração de hardware disponível, ferramentas de linha de comandos e SDK para integração em aplicações. A documentação do Azure Local descreve, no contexto de uma implementação com Kubernetes, a gestão do ciclo de vida dos modelos e dos pontos finais. Não existe uma configuração universal única: o produto e o ambiente determinam os requisitos e a forma de administração.
Antes de adotar Ollama ou LM Studio num projeto, consulte a documentação oficial de cada ferramenta para verificar os sistemas operativos, formatos de modelo, aceleradores, interface local e condições de licença relevantes. A compatibilidade depende da ferramenta, do modelo e do ambiente concretos.
Uma avaliação inicial pode seguir passos concretos:
- Defina a tarefa e os dados que o modelo irá receber.
- Escolha um modelo cuja licença e capacidades sejam adequadas a essa utilização.
- Verifique o tamanho, o formato e os requisitos de memória publicados.
- Instale um motor compatível com o sistema e o hardware disponíveis.
- Avalie qualidade, velocidade, consumo e estabilidade com entradas representativas.
- Decida como serão protegidos o ponto de acesso, os registos e as atualizações.
Uma resposta gerada, por si só, não demonstra que a implementação seja adequada: também é necessário avaliar falhas, privacidade e manutenção.
Quando escolher inferência local ou uma abordagem híbrida
A inferência local é adequada quando a conectividade não é garantida, quando é importante processar dados perto do local onde são gerados ou quando a política da organização exige que determinado conteúdo permaneça num ambiente controlado. Uma câmara que deteta uma anomalia e envia apenas um alerta é um exemplo de processamento próximo da origem; um resumo de documentos internos pode ser outro, desde que a aplicação, o modelo e o armazenamento se mantenham dentro dos limites definidos pela organização.
A cloud pode ser mais adequada se for necessário um modelo ou uma capacidade que o hardware próprio não consegue oferecer, se a procura variar ou se a equipa não tiver tempo para operar modelos. Para uma aplicação usada em muitos dispositivos, também pode simplificar a implementação centralizada, embora acrescente dependência da rede, condições do fornecedor e gestão dos dados transmitidos.
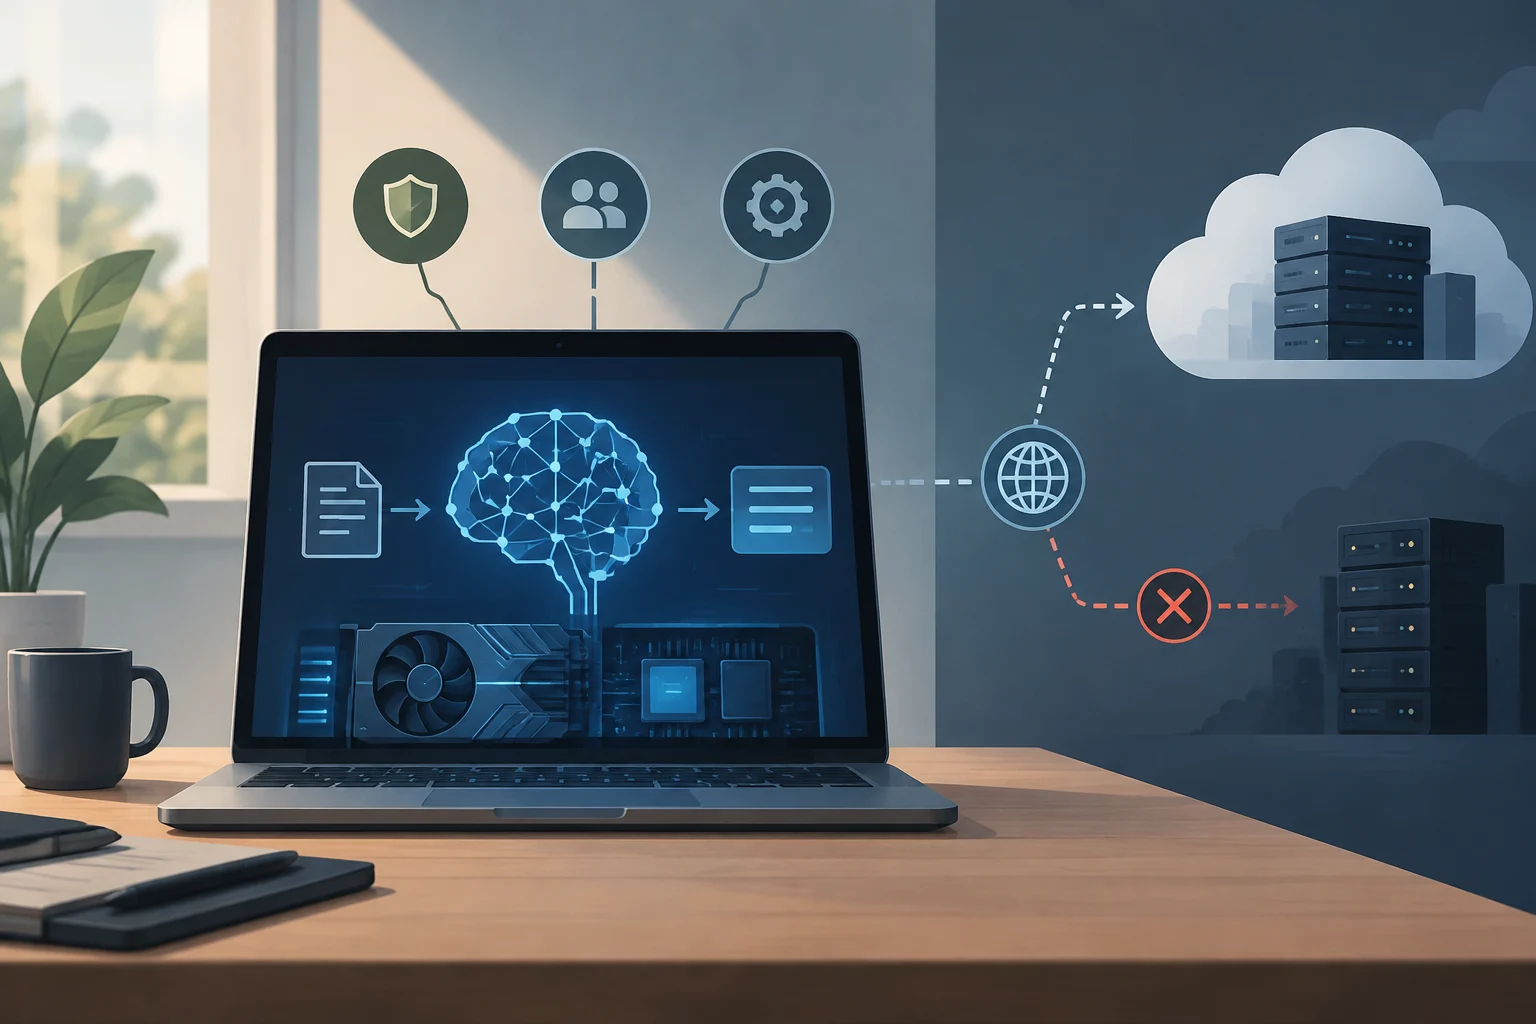
Uma abordagem híbrida distribui tarefas em função da disponibilidade, sensibilidade ou complexidade: tenta primeiro um modelo local e recorre a um serviço remoto quando a tarefa o exigir. A Google documenta para Android modos de encaminhamento que podem dar preferência ao dispositivo, dar preferência à cloud ou restringir a operação a um dos dois ambientes. O mecanismo de recurso alternativo deve ser explícito: se um pedido sensível puder sair do dispositivo, a aplicação deve informar o utilizador e respeitar a política definida.
Para tomar uma decisão, compare estas perguntas:
- Que dados entram e podem sair do ambiente local?
- Que nível de qualidade e que tempo de resposta a tarefa exige?
- O modelo cabe com margem na memória disponível?
- Quem mantém o software, os modelos e os controlos de acesso?
- Como varia o custo com a utilização e com o hardware já existente?
- O que deve acontecer se o modelo local não estiver disponível?
A resposta pode variar de tarefa para tarefa: não é necessário impor uma única arquitetura a todas as funções de uma aplicação. Um modelo local pode tratar tarefas rotineiras ou sensíveis, enquanto uma API remota responde a pedidos que excedem a sua capacidade, desde que o utilizador e a política permitam essa transferência.