O que significa IA no dispositivo
IA no dispositivo é o processamento de uma funcionalidade de inteligência artificial no próprio equipamento que a utiliza, como um telemóvel, computador ou navegador. Em termos técnicos, o modelo realiza aí a inferência: recebe uma entrada, calcula um resultado e devolve-o à aplicação. Consoante as capacidades do modelo, a entrada pode ser texto, imagem, áudio ou outro tipo de dado.
O termo descreve onde o cálculo é executado, não o tipo de inteligência do sistema nem quem o criou. Pode tratar-se de um modelo tradicional de aprendizagem automática ou de um modelo generativo; também pode ser uma função simples, como reconhecer texto numa imagem, ou uma tarefa linguística mais complexa. A execução local não significa, por si só, que todo o serviço, a aplicação ou os respetivos dados fiquem fora da Internet.
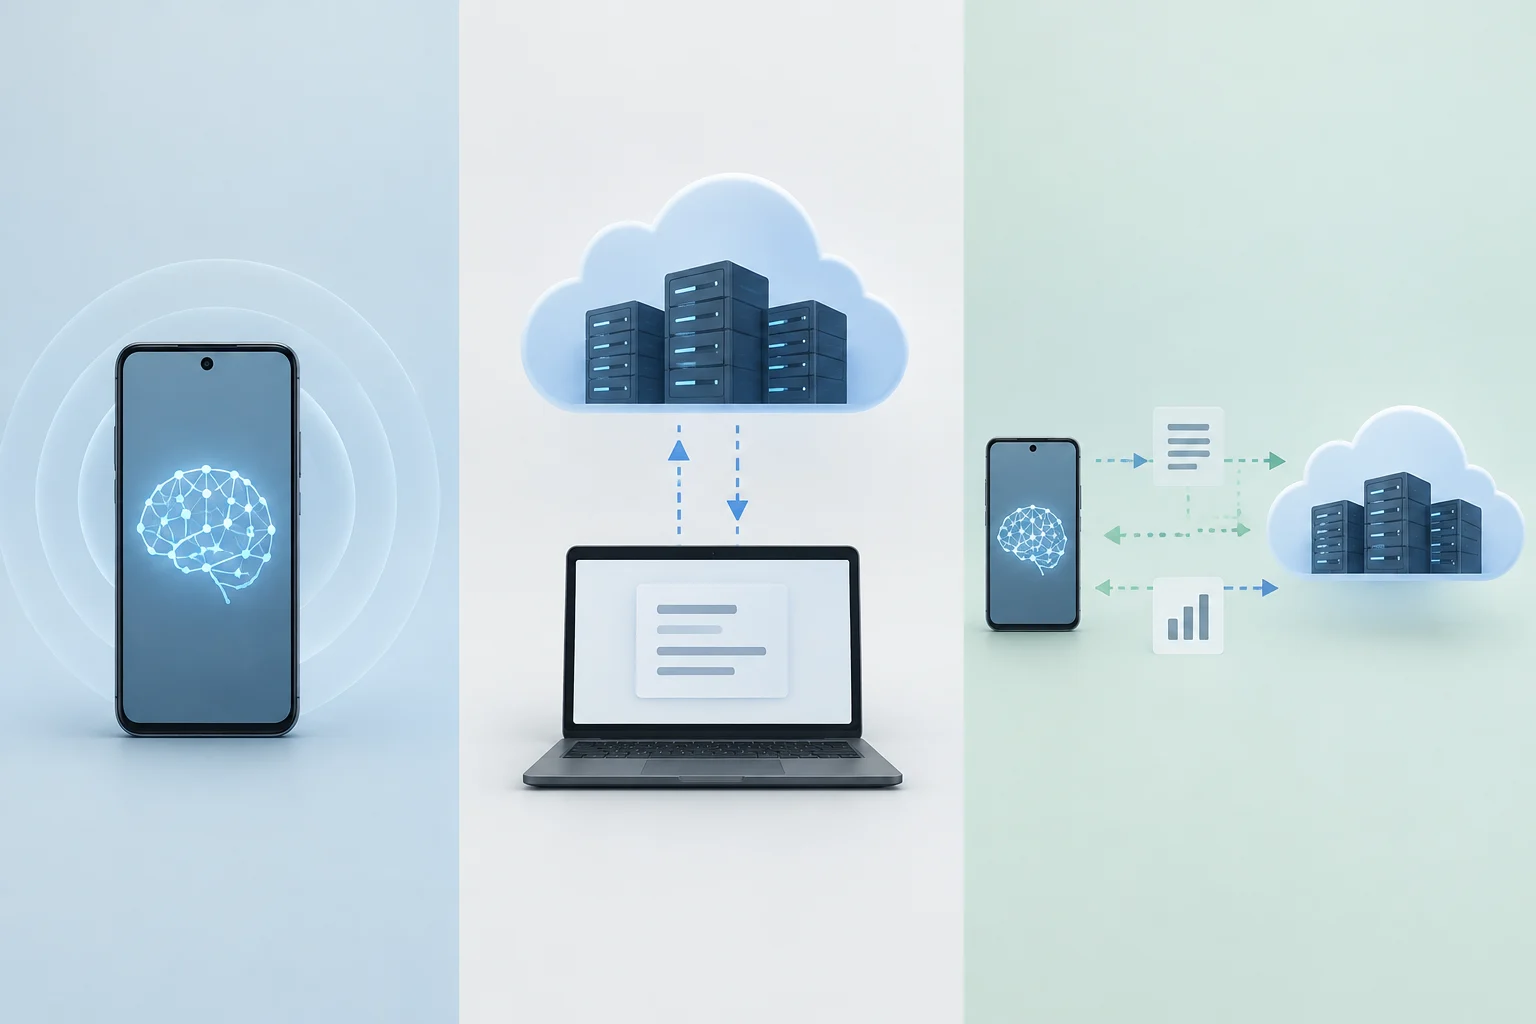
IA no dispositivo designa a inferência executada no equipamento do utilizador. IA na nuvem refere-se ao processamento realizado em servidores remotos, enquanto uma arquitetura híbrida pode combinar as duas vias. Convém verificar o percurso efetivo de cada funcionalidade, pois uma aplicação pode executar algumas etapas no dispositivo e outras num servidor.
Como o dispositivo processa um pedido
O processo básico começa quando uma aplicação prepara uma entrada — por exemplo, uma frase para resumir ou uma imagem para descrever — e a entrega a um modelo disponível localmente. O modelo transforma essa entrada em operações matemáticas e produz uma resposta; a aplicação apresenta-a ou utiliza-a para concluir uma tarefa. A inferência ocorre no dispositivo quando o cálculo não precisa de enviar o pedido a um servidor para ser resolvido.
O modelo pode estar integrado no sistema, ser descarregado em separado ou fazer parte da própria aplicação. Uma camada de software determina como o invocar e que recursos de hardware utilizar. No Android, por exemplo, a Google descreve o AICore como um serviço do sistema situado entre as aplicações e o Gemini Nano; a plataforma gere o acesso ao modelo e a respetiva distribuição. É um exemplo de arquitetura, não uma característica universal de todos os telemóveis.
No hardware, a CPU pode gerir o fluxo geral da aplicação e executar modelos compatíveis; a GPU pode acelerar cálculos paralelos e a NPU foi concebida para determinadas operações de aprendizagem automática. Nem todos os modelos usam a NPU: isso depende do dispositivo, do sistema, do formato do modelo e do software. No Windows, as ferramentas de inferência podem selecionar um acelerador compatível e, em certos casos, recorrer à CPU ou GPU se outra via não estiver disponível.
A memória disponível e a representação do modelo também são importantes. Um modelo maior ou uma entrada mais extensa podem exigir mais memória e tempo de cálculo. A quantização reduz a precisão numérica dos pesos para tornar alguns modelos mais compactos ou eficientes, com possíveis compromissos na qualidade. Assim, a presença de um acelerador não garante que qualquer modelo ou funcionalidade seja executado nele com bom desempenho.
IA local, IA na nuvem e inferência híbrida
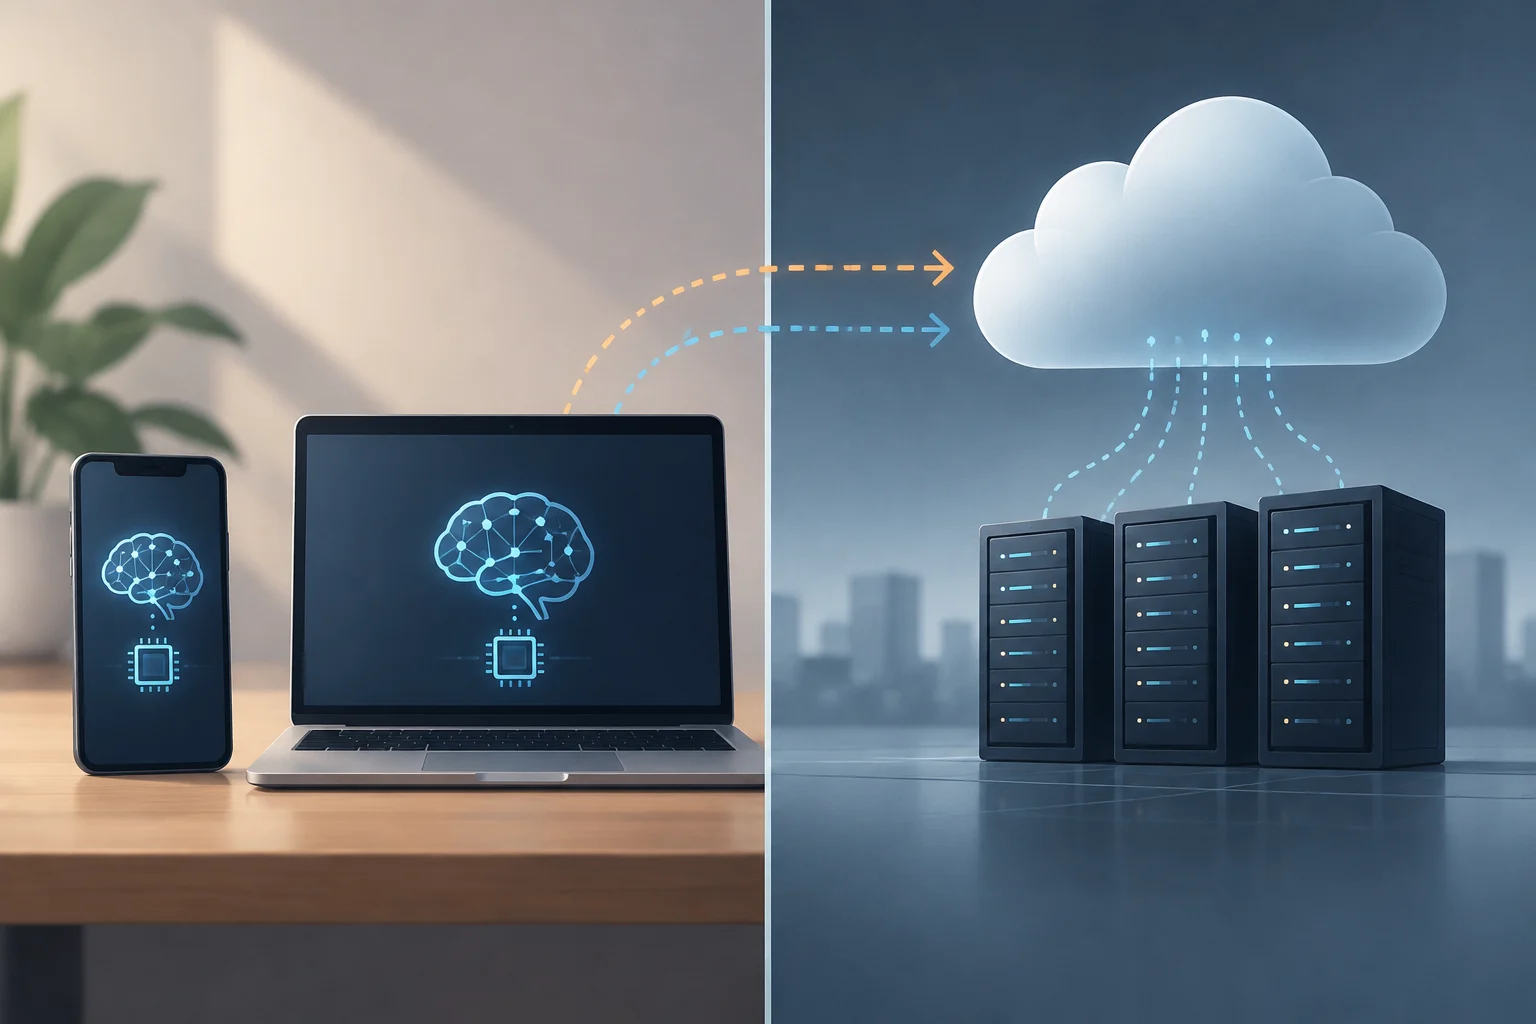
A distinção principal é onde a resposta é calculada. Numa via local, o modelo processa o pedido no dispositivo. Numa via na nuvem, a aplicação transmite dados para um serviço remoto que executa o modelo e devolve o resultado. Uma arquitetura híbrida pode dividir etapas entre os dois ambientes ou escolher uma via de acordo com a tarefa e as capacidades do equipamento.
| Aspeto | Processamento no dispositivo | Processamento na nuvem |
|---|---|---|
| Local do cálculo | No telemóvel, computador ou outro equipamento do utilizador | Nos servidores remotos do fornecedor |
| Ligação para a inferência | Pode funcionar sem ligação se o modelo e a funcionalidade já estiverem disponíveis | Normalmente requer ligação para enviar o pedido e receber a resposta |
| Latência potencial | Evita o percurso pela rede, embora dependa do hardware e do modelo | Acrescenta o tempo de comunicação ao processamento remoto |
| Dados | O pedido pode permanecer no dispositivo se a funcionalidade tiver sido concebida assim | Os dados enviados são processados fora do dispositivo, de acordo com o serviço e as respetivas políticas |
A tabela apresenta tendências, não garantias: uma aplicação pode sincronizar dados, descarregar modelos ou enviar telemetria mesmo quando uma inferência específica é local.
A inferência híbrida combina as duas vias. Uma aplicação pode primeiro tentar responder localmente e recorrer a um modelo remoto se o modelo local não estiver disponível, se o pedido ultrapassar os seus limites ou se o utilizador solicitar uma funcionalidade que exija serviços online. A documentação para programadores Android descreve este tipo de alternativa: certos pedidos podem ser encaminhados para modelos na nuvem quando o Gemini Nano não está disponível ou não é adequado.
Por isso, «local» e «nuvem» nem sempre são categorias exclusivas para uma aplicação inteira. Uma funcionalidade pode analisar texto no dispositivo e depois sincronizar o resultado; outra pode utilizar um modelo local para tarefas simples e um serviço remoto para pedidos mais complexos. A via pode variar consoante a funcionalidade, pelo que é mais útil perguntar o que acontece numa operação concreta do que atribuir uma única designação a toda a aplicação.
Que tarefas podem ser executadas localmente
As tarefas adequadas ao dispositivo costumam ter um âmbito definido e caber nos recursos disponíveis. Entre os exemplos documentados pelas plataformas estão transcrever ou traduzir voz, resumir textos curtos, reescrever mensagens, descrever imagens, reconhecer texto numa fotografia e gerar resultados estruturados. Também podem existir funcionalidades do sistema, como o reconhecimento de escrita manual ou a redução de ruído durante uma chamada.
Um exemplo prático é extrair texto de uma imagem. A câmara capta um sinal visual e um modelo de reconhecimento ótico de caracteres (OCR) identifica os caracteres; a aplicação pode apresentar o texto ou permitir copiá-lo. O Android disponibiliza APIs de reconhecimento de texto que podem processar imagens da câmara no dispositivo. Se a funcionalidade só precisar da imagem e do modelo local, pode funcionar sem enviar cada captura para um serviço remoto, embora o comportamento dependa da aplicação concreta.
Um caso de utilização documentado no Android é resumir gravações de voz: a aplicação Gravador Google Pixel utiliza o Gemini Nano para gerar resumos no dispositivo e sem ligação. Separadamente, as APIs de IA generativa do ML Kit permitem transcrever áudio falado para texto, traduzir voz e sintetizar voz a partir de texto. A disponibilidade destas funcionalidades depende da aplicação e de um dispositivo compatível.
Há também utilizações menos visíveis, como classificar conteúdos ou encontrar ficheiros pelo significado, em vez de procurar apenas correspondências exatas. Um modelo pode criar representações numéricas de textos ou imagens — embeddings — para que um índice local encontre elementos relacionados. Noutros casos, o sistema interpreta o conteúdo apresentado no ecrã para sugerir ações contextuais. O processamento local não garante que o resultado esteja correto: a qualidade depende do modelo e do contexto, e tarefas sensíveis podem exigir revisão humana.
Possíveis vantagens e limites de desempenho
A vantagem mais direta da inferência local é evitar parte do percurso pela rede: se o pedido for resolvido no dispositivo, a resposta não tem de esperar que uma solicitação chegue ao servidor e regresse. Isso pode reduzir a latência, mas não garante um cálculo rápido; um modelo exigente num equipamento modesto pode demorar mais do que um serviço remoto potente.
Uma funcionalidade local pode também funcionar sem ligação à Internet, como acontece com algumas tarefas do Gemini Nano no Android. A disponibilidade sem ligação depende da funcionalidade e do dispositivo; a transferência ou atualização de modelos e a sincronização de ficheiros podem exigir acesso à rede. Funcionar sem ligação numa tarefa não significa que toda a aplicação dispense a Internet.
O hardware impõe limites concretos: capacidade de cálculo, memória, espaço de armazenamento, temperatura e energia disponível. Uma NPU pode acelerar operações compatíveis e deixar outros recursos disponíveis, mas não elimina o custo de executar o modelo. Em tarefas prolongadas, o consumo e o aquecimento continuam a ser fatores relevantes; as especificações do fabricante, por si só, não permitem deduzir o desempenho de cada aplicação ou carga de trabalho.
O tamanho e a capacidade do modelo também condicionam o que pode fazer. Um modelo compacto pode responder rapidamente a tarefas delimitadas, mas ter menos capacidade para instruções longas, contextos extensos ou perguntas complexas. A Google assinala limites de hardware, tokens e capacidade do modelo para o Gemini Nano e propõe inferência híbrida quando é necessário um âmbito maior. A escolha prática é utilizar o modelo local quando resolve bem a tarefa com os recursos disponíveis e reservar a via remota para as funcionalidades que realmente precisem dela.
Privacidade e segurança: o que garantem e o que não garantem
O processamento local pode reduzir a quantidade de informação que uma funcionalidade precisa de transmitir: se um pedido for resolvido no dispositivo, não é necessário enviar essa entrada para um servidor para essa inferência. É uma característica do percurso dos dados, não uma certificação geral de privacidade. A aplicação pode ainda enviar outros dados, sincronizar conteúdos, registar atividade ou utilizar serviços remotos para outras funcionalidades.
A política de privacidade, os controlos da aplicação e as definições do sistema determinam que dados são recolhidos e para que fins. Também importa saber onde são guardados os dados de entrada, os resultados e os dados temporários, quem lhes pode aceder e se a aplicação os conserva depois do processamento. Perante uma decisão sensível, convém consultar as permissões pedidas, as definições da funcionalidade e a política do fornecedor, além de verificar se é possível desativá-la ou apagar os seus dados.
O processamento local não elimina riscos como uma aplicação maliciosa, um dispositivo comprometido, o acesso indevido a uma conta ou um resultado incorreto do modelo. A segurança depende também da aplicação e do dispositivo, não apenas do local onde ocorre a inferência.
Algumas plataformas oferecem controlos específicos para determinadas funcionalidades. A documentação da Microsoft sobre o Recall, por exemplo, descreve armazenamento local encriptado, ativação voluntária e controlos para pausar ou apagar dados; estas condições dizem respeito a essa funcionalidade e não devem ser generalizadas a toda a IA no dispositivo. As perguntas úteis são que dados a funcionalidade processa, onde os guarda, se saem do equipamento e que opções de controlo tem o utilizador.
Como avaliar uma funcionalidade antes de a utilizar
A designação «IA no dispositivo» pode servir de orientação, mas a decisão deve basear-se no comportamento da funcionalidade concreta. Verifique a compatibilidade indicada pelo fornecedor e consulte as definições de privacidade e a política da aplicação para perceber que dados são recolhidos, processados ou sincronizados. O funcionamento pode variar consoante o dispositivo, a aplicação e a funcionalidade.
Uma verificação prática pode centrar-se em quatro perguntas: Que entrada processa? Que partes são executadas localmente? O que acontece sem ligação? Que dados são conservados ou partilhados? Não presuma que o modo sem ligação está ativo apenas porque o modelo é executado localmente.
O dispositivo pode ser uma opção útil quando são importantes o acesso sem ligação, a resposta imediata ou a redução de determinadas transmissões. A nuvem é outra via de processamento, e uma aplicação pode combinar ambas. A decisão depende da utilização e dos dados, bem como do comportamento concreto da funcionalidade, e não apenas do seu nome comercial.
Em suma, IA no dispositivo significa que parte da inferência é realizada no equipamento do utilizador. Pode melhorar a disponibilidade e limitar o envio de dados nessa operação, mas os resultados dependem do hardware, do modelo e da conceção do software. A privacidade exige analisar o percurso completo dos dados; a capacidade local, por sua vez, deve ser avaliada em função da tarefa a realizar.