Qué significa IA en el dispositivo
La IA en el dispositivo es el procesamiento de una función de inteligencia artificial en el propio equipo que la utiliza: por ejemplo, un teléfono, un ordenador o un navegador. En términos técnicos, el modelo realiza allí la inferencia: recibe una entrada, calcula una salida y la devuelve a la aplicación. La entrada puede ser texto, una imagen, audio u otro tipo de dato, según las capacidades del modelo.
El término describe dónde se ejecuta el cálculo, no qué clase de inteligencia tiene el sistema ni quién lo fabricó. Puede tratarse de un modelo de aprendizaje automático tradicional o de uno generativo; también puede ser una función pequeña, como reconocer texto en una imagen, o una tarea de lenguaje más compleja. La ejecución local no implica por sí sola que todo el servicio, la aplicación o sus datos permanezcan fuera de Internet.
IA en el dispositivo describe la inferencia que se ejecuta en el equipo del usuario. IA local puede referirse de forma más amplia a procesamiento en un ordenador cercano o en la infraestructura de una organización, y inferencia local señala que el cálculo se realiza fuera de un servidor remoto. Conviene comprobar el recorrido concreto de cada función, porque una aplicación puede combinar etapas locales y remotas.
Cómo procesa una solicitud el dispositivo
El recorrido básico empieza cuando una aplicación prepara una entrada —por ejemplo, una frase que se quiere resumir o una imagen que se quiere describir— y la entrega a un modelo disponible localmente. El modelo transforma esa entrada en operaciones matemáticas y produce una respuesta; la aplicación la presenta o la usa para completar una tarea. La inferencia ocurre en el equipo cuando ese cálculo no necesita enviar la solicitud a un servidor para ser resuelto.
El modelo puede venir integrado en el sistema, descargarse por separado o ser parte de la propia aplicación. Una capa de software decide cómo invocarlo y qué recursos de hardware utilizar. En Android, por ejemplo, Google describe AICore como un servicio del sistema que actúa entre las aplicaciones y Gemini Nano; la plataforma administra el acceso al modelo y su distribución. Es un ejemplo de arquitectura, no una característica universal de todos los móviles.
En el hardware, la CPU puede gestionar el flujo general de la aplicación y ejecutar modelos compatibles; la GPU puede acelerar cálculos paralelos y la NPU está diseñada para ciertas operaciones de aprendizaje automático. No todo modelo usa la NPU: depende del dispositivo, el sistema, el formato del modelo y el software. En Windows, las herramientas de inferencia pueden seleccionar un acelerador compatible y, en ciertos casos, recurrir a CPU o GPU si otra ruta no está disponible.
También importan la memoria disponible y la representación del modelo. Un modelo más grande o una entrada más extensa pueden exigir más memoria y tiempo de cálculo. La cuantización reduce la precisión numérica de los pesos para hacer algunos modelos más compactos o eficientes, con posibles compromisos en calidad. Por eso, que un dispositivo tenga un acelerador no garantiza que cualquier modelo o función vaya a ejecutarse allí con buen rendimiento.
IA local, IA en la nube e inferencia híbrida
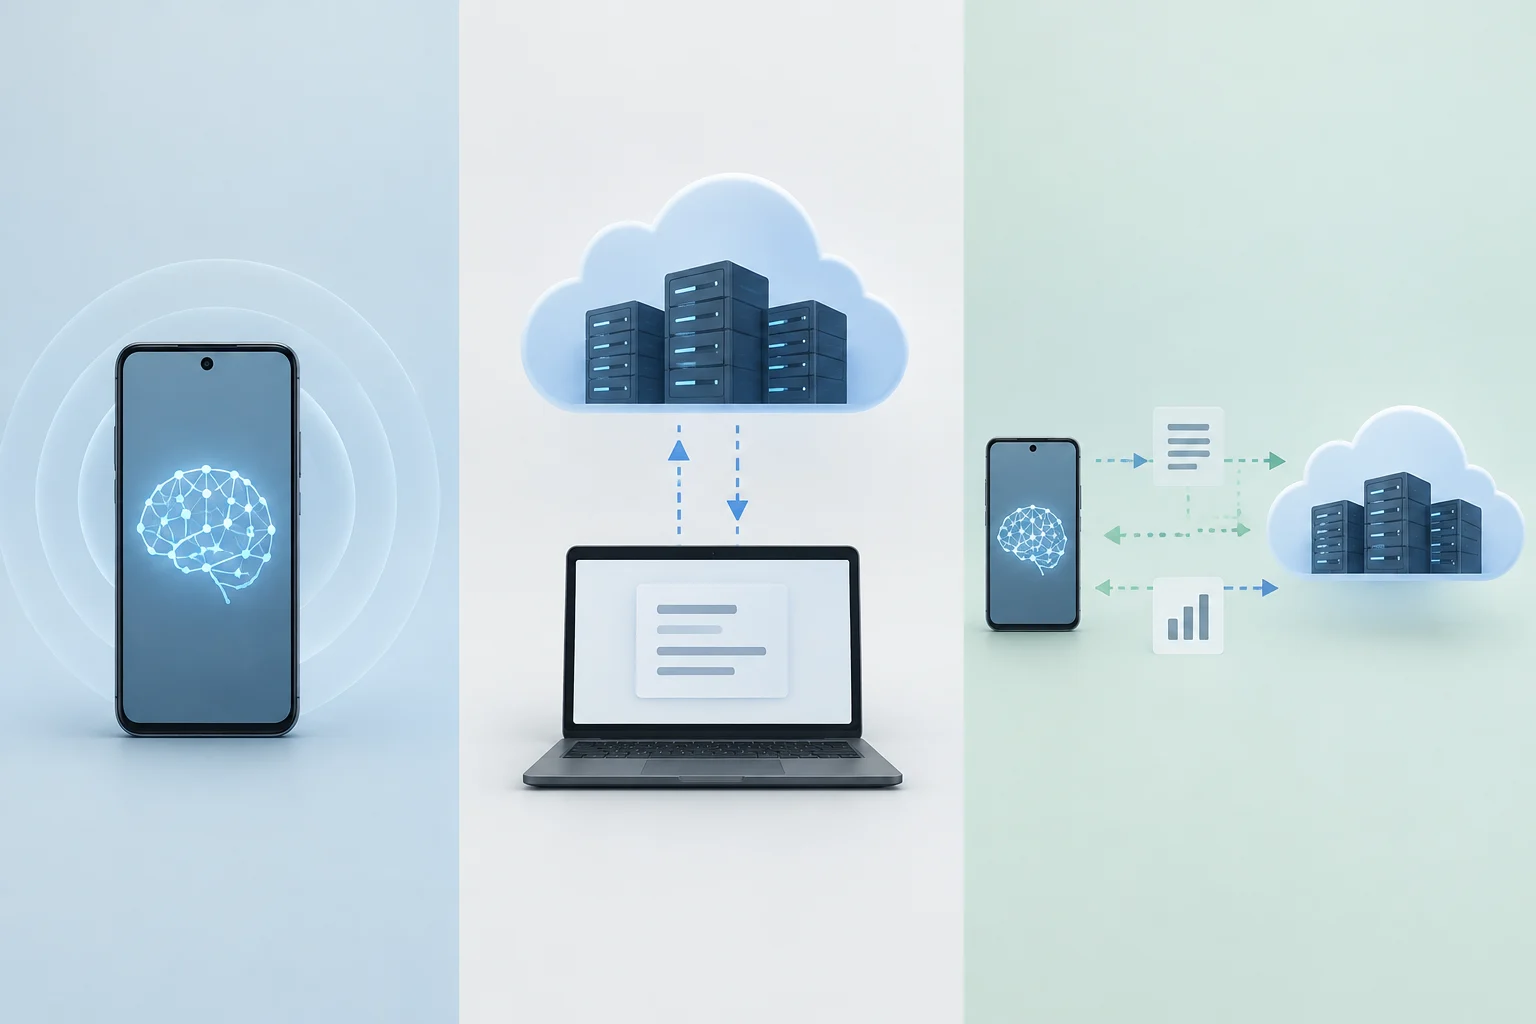
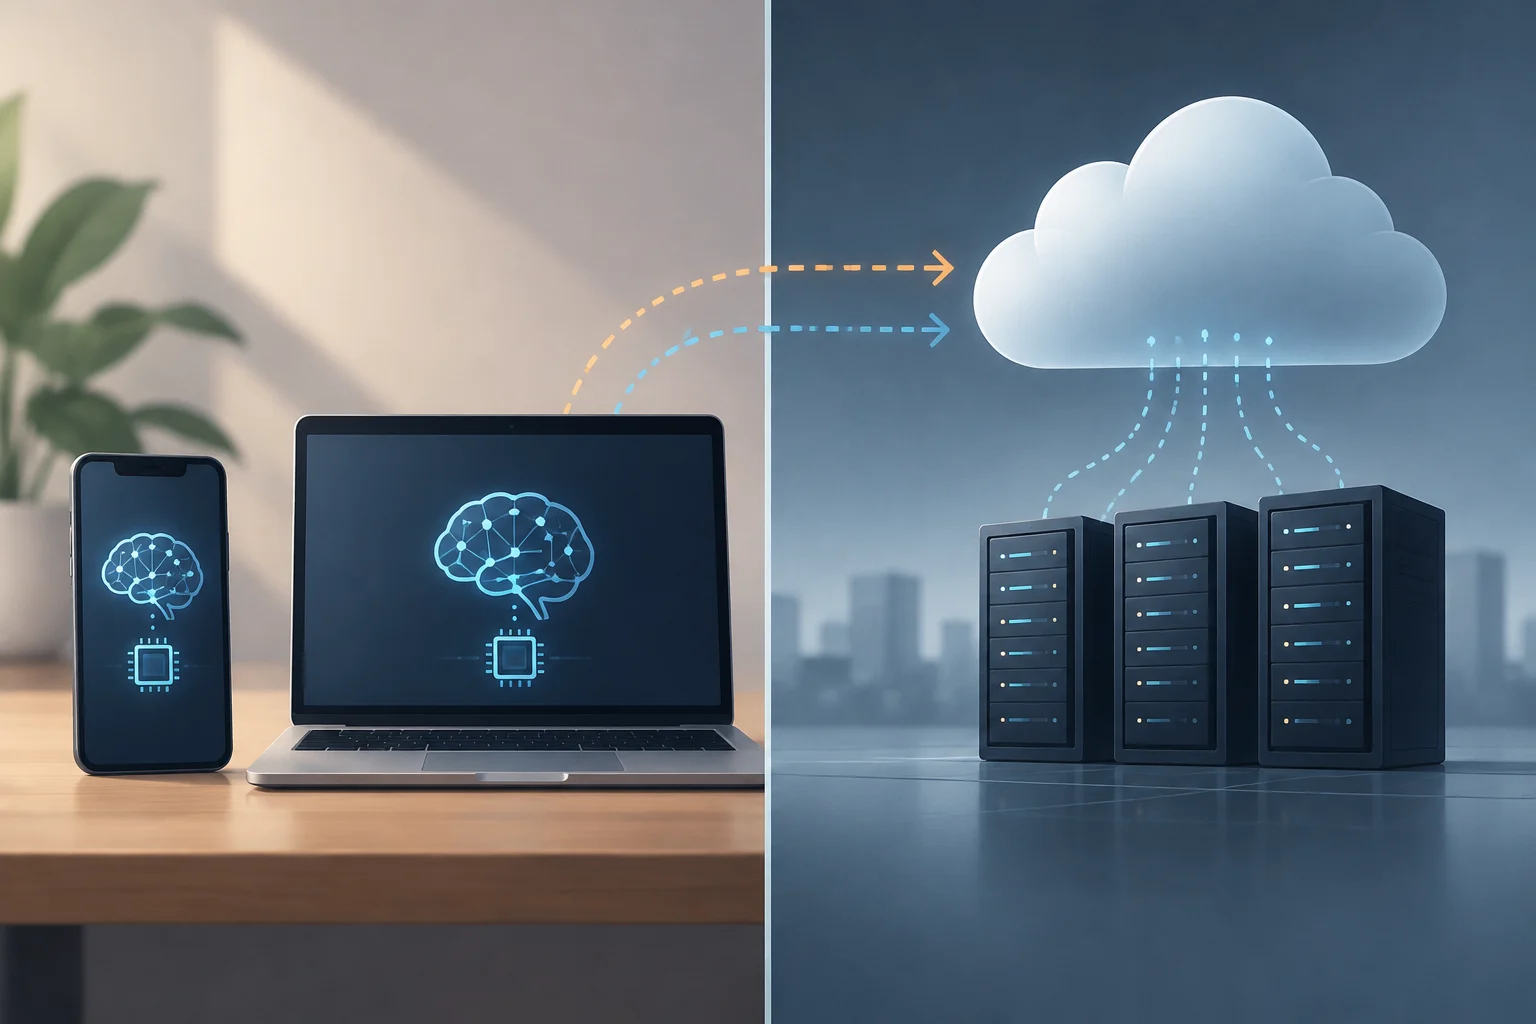
La distinción principal es el lugar donde se calcula la respuesta. En una ruta local, el modelo procesa la solicitud en el dispositivo. En una ruta en la nube, la aplicación transmite datos a un servicio remoto que ejecuta el modelo y devuelve el resultado. En una arquitectura híbrida, la aplicación puede repartir etapas entre ambos lados o elegir una ruta según la tarea y las capacidades del equipo.
| Aspecto | Procesamiento en el dispositivo | Procesamiento en la nube |
|---|---|---|
| Ubicación del cálculo | En el móvil, ordenador u otro equipo del usuario | En servidores remotos del proveedor |
| Conexión para la inferencia | Puede funcionar sin conexión si el modelo y la función ya están disponibles | Normalmente requiere conexión para enviar la solicitud y recibir la respuesta |
| Latencia potencial | Evita el viaje de red, aunque depende del hardware y del modelo | Añade el tiempo de comunicación, además del procesamiento remoto |
| Datos | La solicitud puede permanecer en el dispositivo si la función está diseñada así | Los datos enviados se procesan fuera del dispositivo, según el servicio y sus políticas |
La tabla describe tendencias, no garantías: una aplicación puede sincronizar datos, descargar modelos o enviar telemetría incluso cuando una inferencia concreta sea local.
La inferencia híbrida combina las dos rutas. Una app puede intentar primero una respuesta local y recurrir a un modelo remoto cuando el modelo local no está disponible, la consulta supera sus límites o el usuario solicita una función que requiere servicios en línea. La documentación para desarrolladores de Android describe precisamente ese tipo de alternativa: enviar ciertas solicitudes a modelos en la nube cuando Gemini Nano no esté disponible o no resulte adecuado.
Por tanto, «local» y «nube» no siempre son categorías excluyentes para una aplicación completa. Una función puede analizar un texto en el dispositivo y luego sincronizar el resultado; otra puede usar el modelo local para tareas sencillas y un servicio remoto para consultas más complejas. La ruta puede variar por función, así que es más útil preguntar qué ocurre con una operación concreta que clasificar toda una aplicación con una sola etiqueta.
Qué tareas pueden ejecutarse localmente
Las tareas adecuadas para el dispositivo suelen tener un alcance definido y caber dentro de los recursos del equipo. Entre los ejemplos documentados por las plataformas figuran transcribir o traducir voz, resumir textos cortos, reescribir mensajes, describir imágenes, reconocer texto en una fotografía y generar resultados estructurados. También puede haber funciones del sistema como el reconocimiento de escritura o la reducción de ruido durante una llamada.
Un ejemplo práctico es extraer texto de una imagen. La cámara captura una señal visual y un modelo de reconocimiento óptico de caracteres (OCR) identifica los caracteres; la aplicación puede mostrar el texto o permitir copiarlo. Android ofrece APIs de reconocimiento de texto que pueden procesar imágenes de la cámara en el dispositivo. Si la función solo necesita la imagen y el modelo local, puede operar sin enviar cada captura a un servicio remoto, aunque el comportamiento depende de la app concreta.
Un caso documentado en Android es resumir grabaciones de voz: la aplicación Grabadora de Google Pixel usa Gemini Nano para generar resúmenes sin conexión y en el dispositivo. Por separado, las APIs de IA generativa de ML Kit permiten transcribir audio hablado a texto, traducir voz y sintetizar voz a partir de texto. La disponibilidad de estas funciones depende de la aplicación y del dispositivo compatible.
También hay usos menos visibles, como clasificar contenido o encontrar archivos por significado en lugar de buscar solo coincidencias exactas. Un modelo puede crear representaciones numéricas de textos o imágenes —embeddings— para que un índice local recupere elementos relacionados. En otros casos, el sistema interpreta contenido que aparece en pantalla para ofrecer acciones contextuales. El procesamiento local no determina si la salida es correcta: la calidad depende del modelo y del contexto, y las tareas sensibles pueden necesitar revisión humana.
Ventajas posibles y límites de rendimiento
La ventaja más directa de la inferencia local es evitar parte del viaje de red: si la solicitud se resuelve en el dispositivo, la respuesta no tiene que esperar a que una petición llegue al servidor y vuelva. Esto puede reducir la latencia, aunque no garantiza que el cálculo sea rápido; un modelo exigente en un equipo modesto puede tardar más que un servicio remoto potente.
Otra posibilidad es funcionar sin conexión. Eso requiere que tanto el modelo como los componentes necesarios estén ya instalados y que la función no dependa de una consulta externa. La descarga inicial, la actualización del modelo, la sincronización de archivos o una herramienta conectada a Internet pueden seguir necesitando red. “Puede funcionar sin conexión” no significa “nunca necesita Internet”.
El hardware impone límites concretos: potencia de cálculo, memoria, espacio de almacenamiento, temperatura y energía disponible. Una NPU puede acelerar operaciones compatibles y dejar margen a otros recursos, pero no elimina el coste de ejecutar el modelo. En tareas prolongadas, el consumo y el calentamiento siguen siendo factores relevantes; las especificaciones del fabricante no bastan para deducir el rendimiento de cada aplicación o carga de trabajo.
El tamaño y la capacidad del modelo también condicionan lo que puede hacer. Un modelo compacto puede responder con rapidez a tareas acotadas, pero tener menos capacidad para instrucciones largas, contextos extensos o preguntas complejas. Google señala límites de hardware, tokens y capacidad del modelo para Gemini Nano, y propone inferencia híbrida cuando hace falta ampliar el alcance. La elección práctica es usar el modelo local si resuelve bien la tarea con los recursos disponibles y reservar la ruta remota para funciones que realmente la necesiten.
Privacidad y seguridad: qué garantiza y qué no
El procesamiento local puede reducir la cantidad de información que una función necesita transmitir: si una solicitud se resuelve en el equipo, no es necesario enviar esa entrada a un servidor para esa inferencia. Es una propiedad del recorrido, no una certificación general de privacidad. La aplicación todavía puede enviar otros datos, sincronizar contenido, registrar actividad o usar servicios remotos para funciones distintas.
La política de privacidad, los controles de la aplicación y la configuración del sistema determinan qué se recopila y con qué fines. También importa dónde se guardan la entrada, la salida y los datos temporales, quién puede acceder a ellos y si la aplicación los conserva después de procesarlos. Para una decisión sensible, hay que revisar el permiso solicitado, la configuración de la función y la política del proveedor, además de comprobar si se ofrece una opción para desactivarla o borrar sus datos.
El procesamiento local tampoco evita riesgos como una aplicación maliciosa, un dispositivo comprometido, el acceso indebido a una cuenta o una salida errónea del modelo. El cifrado del almacenamiento, la autenticación y los controles del sistema ayudan a proteger datos, pero son medidas distintas de la ubicación de la inferencia. Local no equivale automáticamente a seguro, igual que una conexión a la nube no determina por sí sola que un servicio sea inseguro.
Algunas plataformas ofrecen controles específicos. La documentación de Microsoft sobre Recall, por ejemplo, describe almacenamiento local cifrado, activación voluntaria y controles para pausar o borrar datos; son condiciones de esa función y no deben extrapolarse a toda la IA en el dispositivo. La pregunta útil es qué datos procesa la función, dónde los guarda, si salen del equipo y qué opciones de control tiene el usuario.
Cómo valorar una función antes de usarla
La etiqueta «IA en el dispositivo» puede orientar, pero para decidir conviene comprobar el comportamiento de la función concreta. En un móvil u ordenador, la información de compatibilidad puede indicar qué modelos y versiones se admiten; los ajustes de privacidad suelen mostrar permisos, almacenamiento y opciones de sincronización. Si se trata de una herramienta de trabajo, también puede haber políticas de administración que controlen qué funciones se habilitan.
Una comprobación práctica puede centrarse en cuatro preguntas: ¿qué entrada procesa? ¿Qué parte se ejecuta localmente? ¿Qué ocurre si no hay conexión? ¿Qué datos se conservan o se comparten? No presupongas que el modo sin conexión está activo solo porque el modelo se ejecuta localmente.
La comparación no consiste en declarar ganadora a una arquitectura. El dispositivo ofrece una ruta útil cuando importan el acceso sin conexión, la respuesta inmediata o reducir ciertas transmisiones; la nube puede servir cuando una función necesita un modelo de mayor capacidad o recursos que el equipo no tiene. La decisión depende del uso y los datos, así como de las opciones reales de la app, no solo del nombre comercial de la función.
En síntesis, IA en el dispositivo significa que una parte de la inferencia se realiza en el equipo del usuario. Puede mejorar la disponibilidad y limitar el envío de datos para esa operación, pero sus resultados dependen del hardware, el modelo y el diseño del software. La privacidad requiere examinar el recorrido completo; la capacidad local, por su parte, debe evaluarse frente a la tarea que se quiere resolver.