Qué significa inferencia local
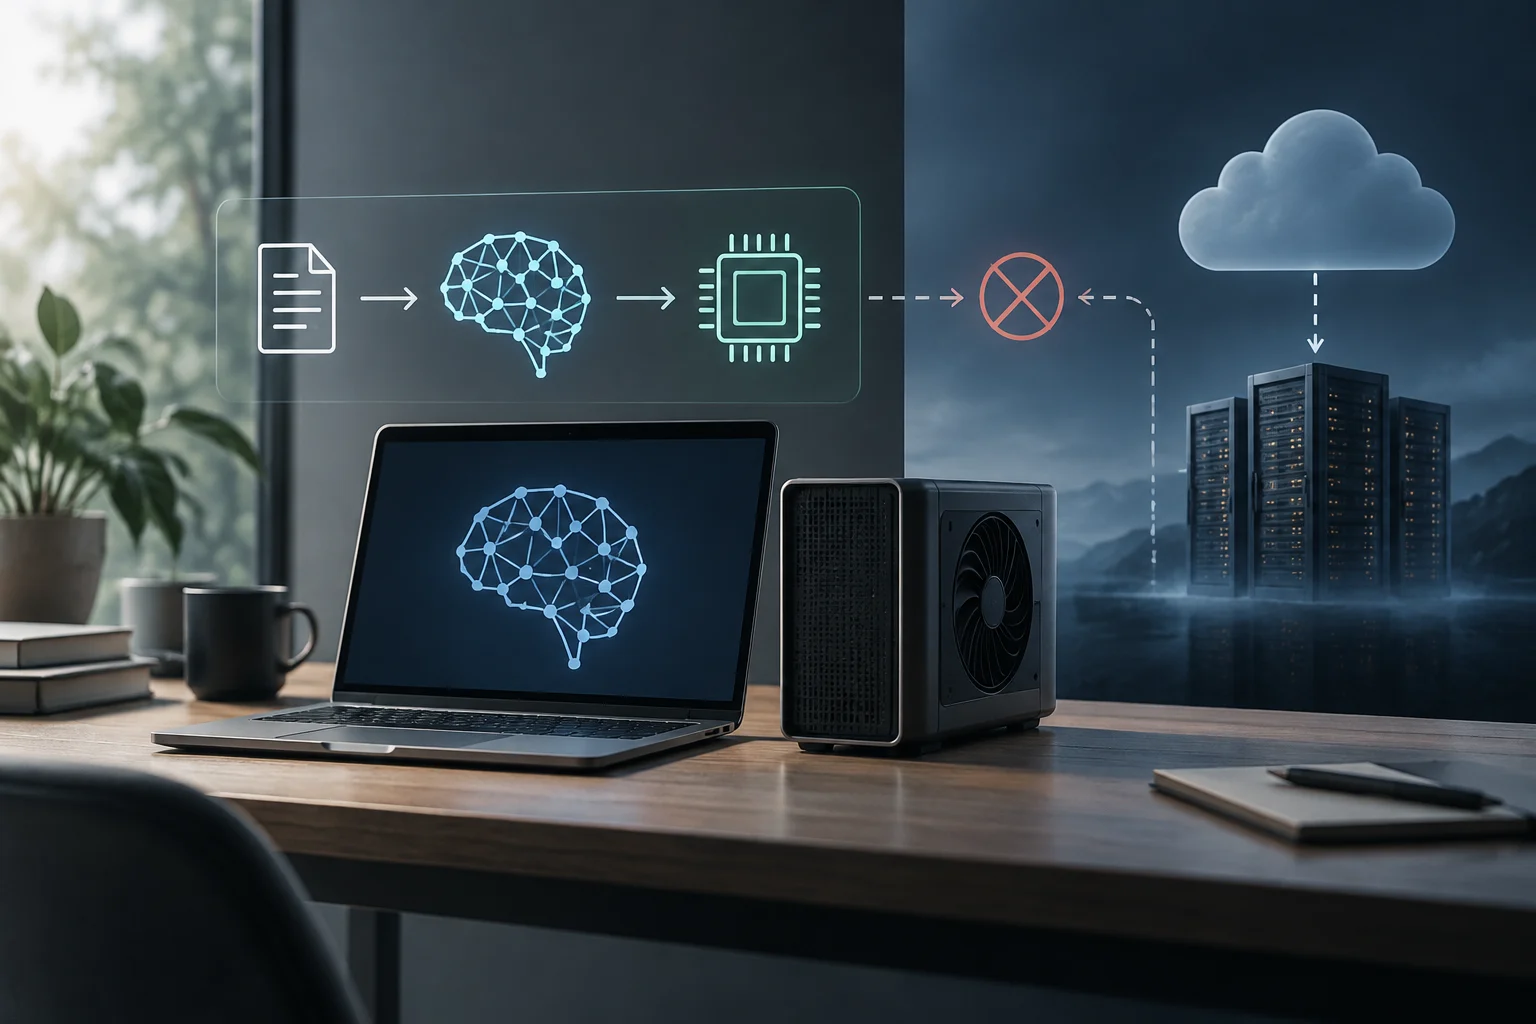
La inferencia local es la ejecución de un modelo de inteligencia artificial en el dispositivo del usuario o en una infraestructura que controla su organización. El modelo ya está entrenado: recibe una entrada, calcula una respuesta y la devuelve. En un asistente de texto, por ejemplo, puede generar una continuación; en una cámara, clasificar una imagen.
La palabra local describe dónde se realiza el cálculo, no quién creó el modelo ni cómo se obtuvo. Un modelo de pesos abiertos descargado de un repositorio puede ejecutarse en un ordenador propio; también puede ejecutarse un modelo distribuido por un proveedor. Lo decisivo es que la solicitud se procese en el equipo o entorno local, en vez de enviarse a un servicio remoto para obtener la respuesta.
No debe confundirse inferencia con entrenamiento. Entrenar ajusta los parámetros del modelo a partir de datos; inferir usa un modelo ya preparado para producir una salida ante una entrada nueva. La inferencia puede incluir operaciones adicionales —como recuperar documentos o llamar a una herramienta—, pero esas tareas no cambian el significado básico del término.
Cómo funciona el recorrido de una solicitud
En una aplicación local, primero se selecciona un modelo compatible y se cargan sus archivos en el almacenamiento y la memoria necesarios. La aplicación prepara la entrada —por ejemplo, convierte una imagen a la representación que espera un modelo visual o forma los tokens de un texto— y el motor de ejecución distribuye el cálculo entre CPU, GPU o aceleradores disponibles. Después, la aplicación transforma la salida interna en texto, etiquetas, puntuaciones u otro resultado que pueda utilizarse.
Del dato a la respuesta
En un modelo de lenguaje, el texto se divide en tokens y se procesa con el contexto pertinente. El modelo calcula una distribución de posibles tokens siguientes y el método de generación selecciona uno; el proceso se repite hasta terminar la respuesta. El resultado depende tanto de los pesos como de la configuración, el contexto y la estrategia de generación. El motor de inferencia no sustituye al modelo: proporciona el entorno que carga y ejecuta sus operaciones.
En visión artificial, el recorrido puede empezar con una imagen capturada por una cámara. El programa la adapta al tamaño y formato de entrada, ejecuta el modelo y convierte sus tensores de salida en objetos detectados, categorías o coordenadas. En sistemas de borde, como una cámara o un equipo industrial, el dispositivo puede enviar después una alerta o un resumen en vez de transmitir continuamente los datos originales. Ese diseño puede ahorrar ancho de banda, aunque depende de cómo esté construida la aplicación y de si transmite información por otras vías.
GPU, VRAM y RAM: qué recurso limita el modelo
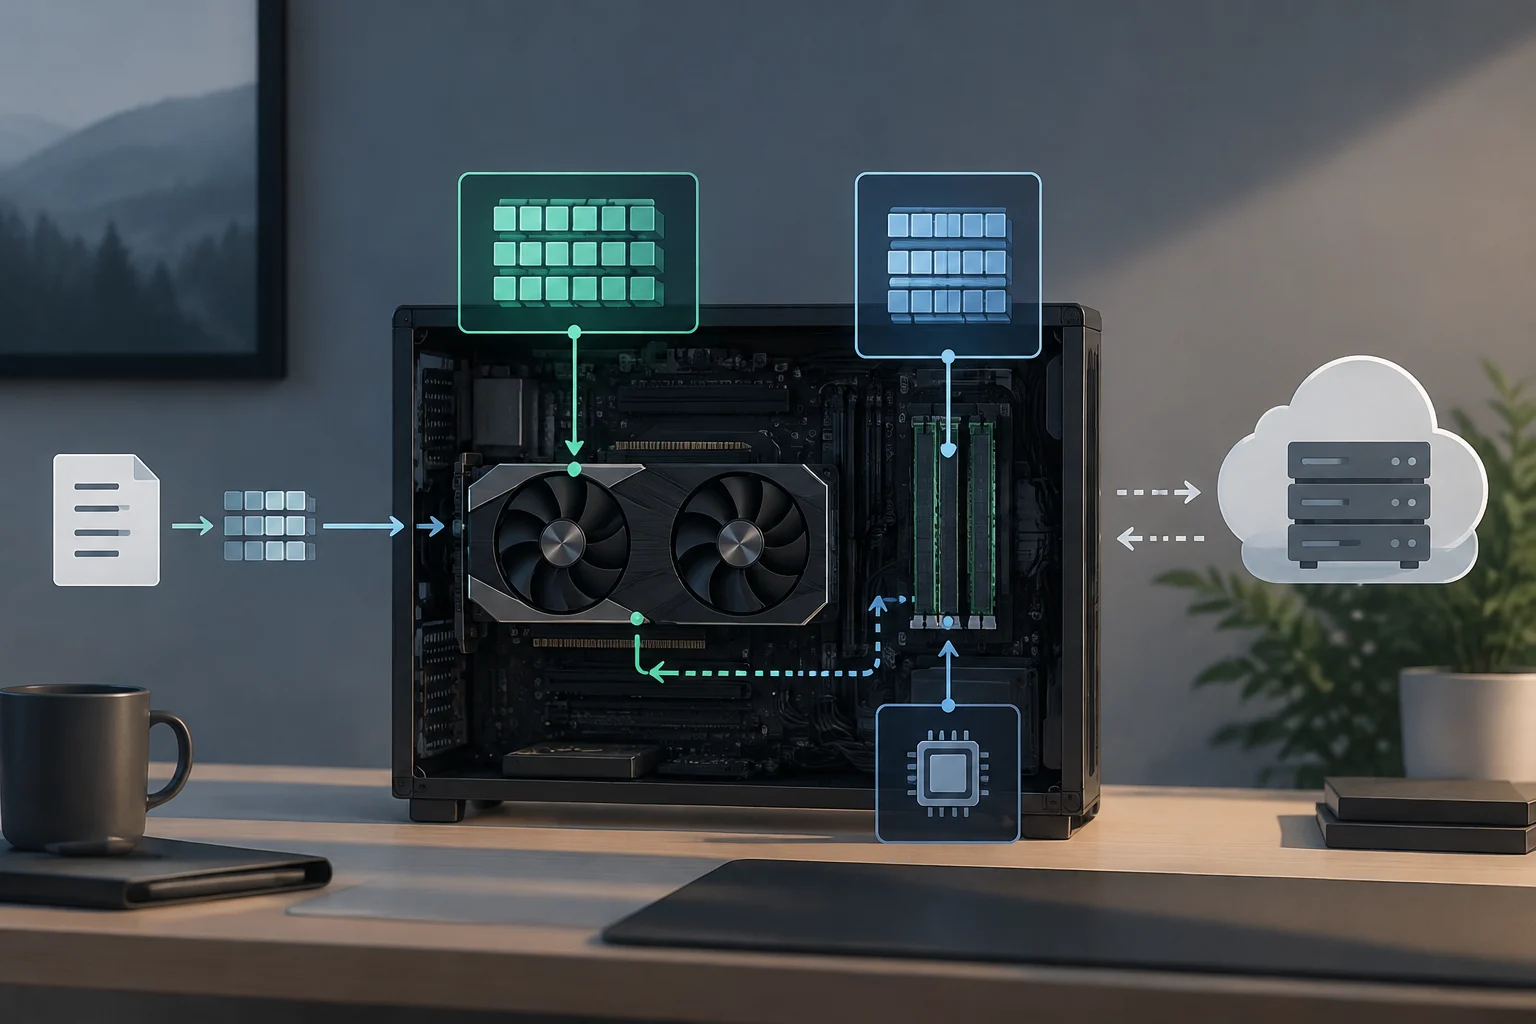
La viabilidad depende de que el modelo y los datos de trabajo quepan en la memoria disponible y de que el equipo pueda ejecutar el cálculo a una velocidad adecuada. En una GPU dedicada, la VRAM almacena pesos y otros datos que necesita el acelerador. La RAM del sistema aloja el proceso, puede contener partes del modelo y permite ejecutar cargas en CPU o apoyar una configuración que no cabe enteramente en la GPU. No son recursos intercambiables sin coste: mover datos entre memorias puede reducir el rendimiento.
La GPU puede acelerar operaciones paralelas habituales en redes neuronales, pero no es un requisito universal. Un modelo puede ejecutarse en CPU si el software y el formato lo permiten; suele ser una alternativa más lenta, no necesariamente imposible. Algunos equipos también disponen de NPU u otros aceleradores, cuyo uso depende de que el motor de ejecución y el modelo los admitan. La compatibilidad del conjunto importa tanto como el nombre del componente: sistema operativo, controlador, formato del modelo y motor deben trabajar juntos.
El tamaño del archivo del modelo sirve como primera pista, pero no representa por sí solo toda la memoria necesaria durante la inferencia. También cuentan la precisión o cuantización de los pesos, la longitud del contexto, el tamaño de lote y las memorias temporales que crea la ejecución. En un modelo de lenguaje, un contexto más extenso puede elevar el consumo de memoria; por eso, dejar margen es más prudente que dimensionar el equipo exactamente al tamaño descargado.
Una guía de hardware de PromptQuorum ofrece una regla orientativa para determinados modelos de lenguaje cuantizados: cita alrededor de 4–5 GB para un modelo de 7.000 millones de parámetros en Q4_K_M y alrededor de 40 GB para uno de 70.000 millones en esa cuantización. Son estimaciones de una configuración concreta, no requisitos universales ni una garantía de velocidad: el formato, el contexto y el motor pueden cambiar el consumo real. Para elegir equipo, conviene comprobar la ficha del modelo y medirlo con la carga de trabajo prevista.
Local o nube: diferencias que afectan a la decisión
En la inferencia remota, la aplicación envía una solicitud a un servidor mediante una API y recibe la respuesta por la red. El proveedor gestiona el hardware del servicio; el usuario evita instalar y mantener allí el modelo, pero debe considerar la conectividad, las condiciones del servicio y el tratamiento de los datos enviados. En local, la organización asume la descarga, el despliegue, la compatibilidad y el mantenimiento, mientras que el cálculo puede seguir funcionando sin una conexión externa si la aplicación no depende de otros servicios.
| Criterio | Inferencia local | Inferencia en la nube o por API |
|---|---|---|
| Lugar del cálculo | Dispositivo o infraestructura local | Servidores remotos del proveedor o del operador |
| Conexión durante la solicitud | Puede funcionar sin Internet si modelo y aplicación están disponibles localmente | La solicitud depende de la conexión con el servicio |
| Datos de entrada | Pueden permanecer en el entorno local; hay que revisar el resto de la aplicación | Se transmiten al servicio para procesarlos, según su configuración |
| Recursos y operación | El equipo propio limita memoria y capacidad; el usuario gestiona modelos y actualizaciones | El proveedor aporta capacidad y gestiona parte de la infraestructura |
| Coste | Hardware, electricidad, almacenamiento y mantenimiento; no equivale a coste cero | Puede cobrarse por uso o capacidad, según el servicio |
La tabla resume diferencias arquitectónicas, no una garantía sobre privacidad, rapidez o precio de un servicio particular. El envío de una solicitud a la nube no determina por sí solo cuánto tiempo se conserva ni quién puede acceder a ella: esas condiciones dependen del proveedor, la configuración y el contrato.
La latencia tampoco tiene un ganador automático. El procesamiento local evita el viaje de red hasta un servidor, lo que puede beneficiar a una aplicación interactiva o a un dispositivo con conectividad irregular. Pero una GPU remota potente puede calcular más rápido que un equipo modesto, mientras que un modelo local grande puede tardar demasiado para el uso previsto. Hay que distinguir el tiempo de comunicación del tiempo de cálculo y evaluar el recorrido completo.
El coste sigue una lógica similar. Ejecutar en un equipo que ya existe evita una tarifa por solicitud si no se usa un servicio facturado, pero no elimina el coste de compra, energía, soporte, sustitución y mantenimiento. En la nube, el gasto puede crecer con el uso; a cambio, se puede acceder a recursos que no están instalados en cada dispositivo. La decisión útil es comparar el coste total para una carga de trabajo y un período determinados, no equiparar “local” con gratuito ni “nube” con más caro.
Privacidad, seguridad y límites prácticos
Procesar datos localmente puede reducir la necesidad de enviar el contenido de la solicitud a un proveedor remoto. Eso reduce una ruta de exposición, pero no garantiza privacidad por sí solo. La aplicación podría sincronizar registros, consultar un servicio externo o enviar telemetría; también siguen siendo relevantes los permisos del sistema, el acceso de otros usuarios y la protección del dispositivo.
La ejecución local traslada responsabilidades al equipo que la opera. Hay que mantener actualizados el modelo y el software, controlar quién puede acceder al servicio local y revisar el origen y las condiciones de uso de los modelos. En una organización, la instalación en servidores propios tampoco significa automáticamente que los datos estén aislados: importan la red, las credenciales, los registros, las copias y la configuración de cada componente.
En capacidad, un equipo local suele imponer un techo práctico al tamaño y complejidad del modelo, al contexto que puede procesar y al número de solicitudes simultáneas. Un modelo más pequeño puede servir bien para una tarea delimitada, pero no tiene por qué igualar a un sistema remoto de mayor capacidad en todas las tareas. La calidad depende del modelo y del caso de uso, no únicamente de dónde se ejecuta.
También hay costes de operación que no aparecen en una tarifa por token: preparar el entorno, descargar archivos, resolver incompatibilidades, supervisar recursos y distribuir actualizaciones. En un dispositivo individual el mantenimiento puede ser sencillo; en una flota empresarial se convierte en una tarea de despliegue y soporte. La inferencia local ofrece control sobre el entorno, pero ese control implica trabajo técnico.
Motores de ejecución y herramientas
Las herramientas locales ocupan capas distintas. Un motor de inferencia ejecuta operaciones del modelo; una aplicación de escritorio puede añadir catálogo, conversación y controles; y un servidor local ofrece una interfaz para que otras aplicaciones envíen solicitudes. Antes de escoger, conviene distinguir esas funciones y comprobar qué formatos, aceleradores y sistemas operativos admite cada opción.
Microsoft documenta Foundry Local como una herramienta para descargar y ejecutar modelos compatibles en dispositivos Windows mediante la aceleración disponible, con herramientas de línea de comandos y SDK para integrarlos en aplicaciones. Su documentación de Azure Local describe, en un contexto de despliegue con Kubernetes, la gestión del ciclo de vida de modelos y puntos de conexión. No es una sola configuración universal: el producto y el entorno determinan los requisitos y el modo de administración.
Antes de adoptar Ollama o LM Studio en un proyecto, comprueba en la documentación oficial de cada herramienta el soporte de sistema, los formatos de modelo, los aceleradores, la interfaz local y las condiciones de licencia pertinentes. La compatibilidad depende de la herramienta, el modelo y el entorno concretos.
Una prueba inicial puede organizarse en pasos concretos:
- Define la tarea y los datos que recibirá el modelo.
- Elige un modelo cuya licencia y capacidades encajen con ese uso.
- Comprueba el tamaño, el formato y los requisitos de memoria publicados.
- Instala un motor compatible con el sistema y el hardware disponibles.
- Evalúa calidad, velocidad, consumo y estabilidad con entradas representativas.
- Decide cómo se protegerán el punto de acceso, los registros y las actualizaciones.
Una respuesta generada no demuestra por sí sola que el despliegue sea adecuado: hay que comprobar también fallos, privacidad y mantenimiento.
Cuándo elegir inferencia local y cuándo usar un enfoque híbrido
La inferencia local encaja cuando la conectividad no está garantizada, cuando interesa procesar datos cerca de donde se generan o cuando una política de la organización exige mantener cierto contenido en un entorno controlado. Una cámara que identifica una anomalía y envía solo una alerta es un ejemplo de procesamiento próximo al origen; un resumen de documentos internos puede ser otro, siempre que la aplicación, el modelo y el almacenamiento se mantengan dentro de los límites definidos por la organización.
La nube puede ser más apropiada si se necesita un modelo o una capacidad que el hardware propio no puede ofrecer, si se espera una demanda variable o si el equipo no dispone de tiempo para operar modelos. Para una aplicación con usuarios en muchos dispositivos, también puede simplificar el despliegue centralizado, aunque añade dependencia de red, condiciones del proveedor y gestión de datos transmitidos.
Un enfoque híbrido permite asignar tareas según disponibilidad, sensibilidad o complejidad: intentar primero un modelo local y recurrir a un servicio remoto cuando la tarea lo requiera. Google documenta para Android modos de enrutamiento que pueden preferir el dispositivo, preferir la nube o limitarse a uno de los dos entornos. El mecanismo de respaldo debe ser explícito: si una solicitud sensible puede salir del equipo, la aplicación debe informar al usuario y respetar la política establecida.
Para tomar una decisión, compara estas preguntas:
- ¿Qué datos entran y pueden salir del entorno local?
- ¿Qué nivel de calidad y qué tiempo de respuesta exige la tarea?
- ¿Cabe el modelo con margen en la memoria disponible?
- ¿Quién mantiene el software, los modelos y los controles de acceso?
- ¿Cómo varía el coste con el uso y con el hardware que ya existe?
- ¿Qué debe ocurrir si el modelo local no está disponible?
La respuesta puede ser distinta por tarea: no hace falta imponer una sola arquitectura a todas las funciones de una aplicación. Un modelo local puede atender trabajos rutinarios o sensibles, mientras que una API remota cubre solicitudes que exceden su capacidad, siempre que el usuario y la política acepten esa transferencia.