Tres unidades, fortalezas distintas
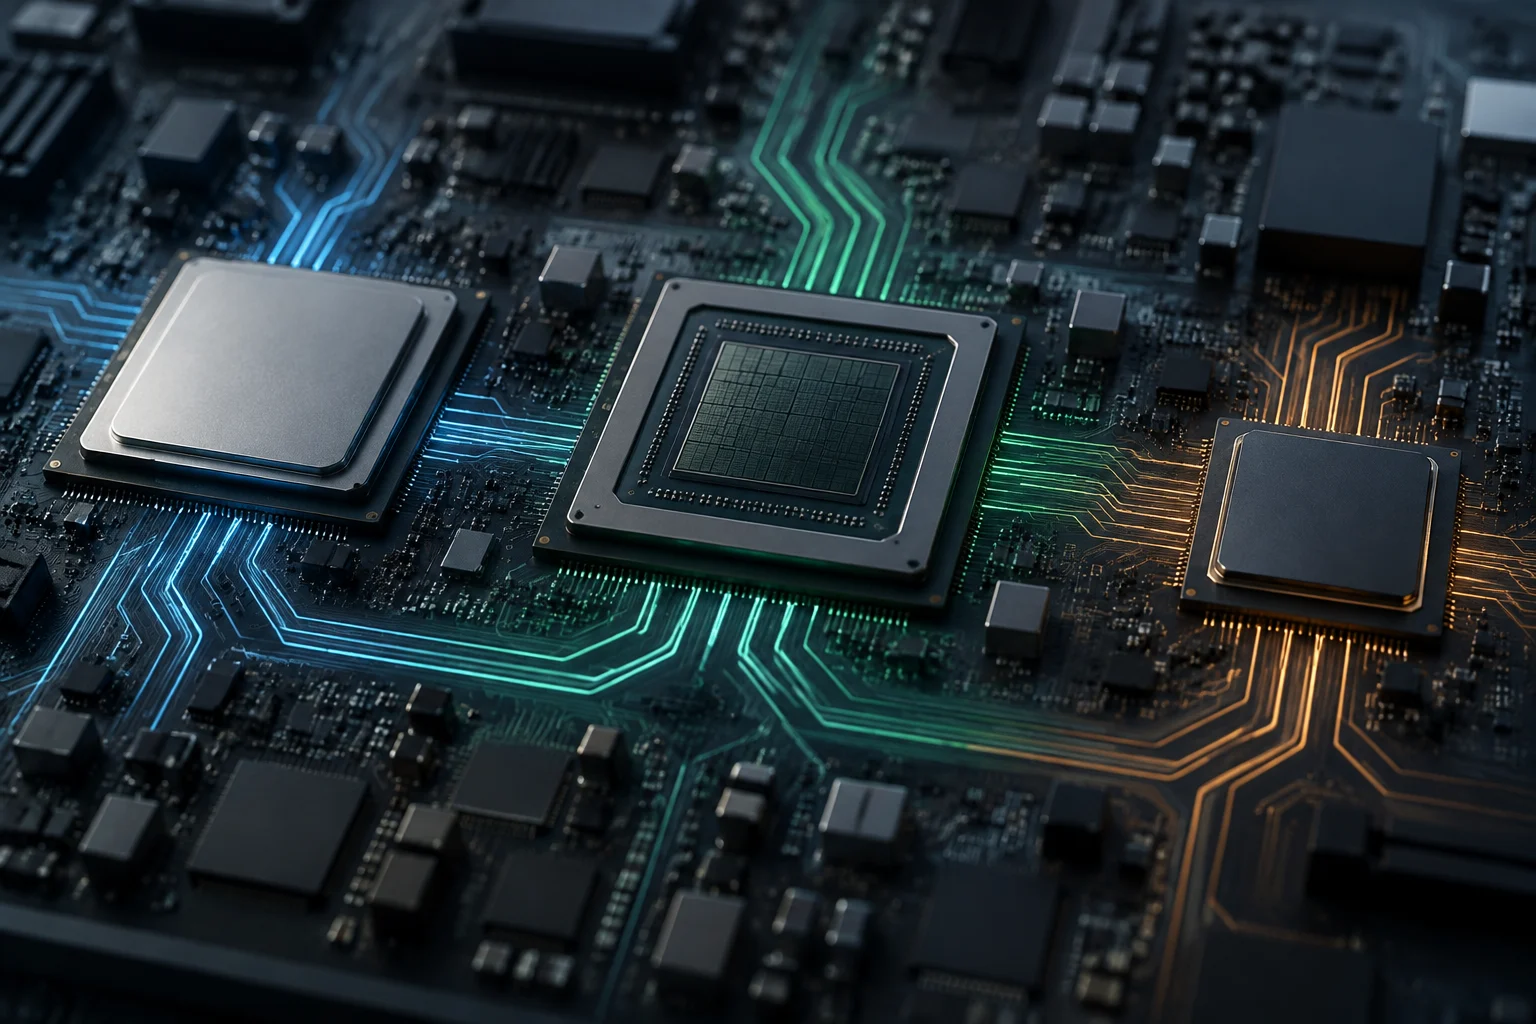
La CPU, la GPU y la NPU suelen presentarse como tres motores de procesamiento, pero no son opciones intercambiables para una misma tarea. Cada una tiene una arquitectura y un propósito predominante: la CPU coordina y ejecuta tareas generales, la GPU destaca cuando una carga puede repartirse entre muchos cálculos semejantes, y la NPU se orienta a operaciones usadas por redes neuronales y otros modelos de IA. La frontera no es absoluta: el trabajo real depende del programa, de sus bibliotecas y de los recursos disponibles en el equipo.
La CPU es el procesador de propósito general que ejecuta instrucciones del sistema operativo y de las aplicaciones. Puede ocuparse de cálculos, lógica, entrada y salida y secuencias de instrucciones que requieren decisiones sucesivas. Esa versatilidad hace que siga siendo necesaria incluso en un ordenador con aceleradores: organiza el trabajo, ejecuta partes que no se delegan y atiende tareas del sistema. No es preciso resumirla como «la más lenta» o «la más rápida» sin especificar una carga, porque la comparación cambia según el tipo de operación. Microsoft describe la CPU como el componente que dirige a otros elementos del dispositivo.
Una GPU empezó como unidad para gráficos, pero su capacidad de ejecutar muchos cálculos en paralelo también resulta útil fuera del renderizado. El contraste práctico no es que una GPU haga todo mejor, sino que puede procesar con eficiencia una carga cuando sus operaciones se pueden distribuir en paralelo. Una tarea con dependencias secuenciales o mucho control puede no beneficiarse de la misma manera. La documentación de NVIDIA sobre computación GPU y la explicación de AWS sobre GPU frente a CPU describen precisamente esta especialización en cálculos paralelos. NVIDIA · AWS.
La NPU, por su parte, es un acelerador diseñado para ejecutar determinados cálculos asociados con inteligencia artificial. Su presencia no significa que todas las funciones de IA vayan a ejecutarse allí: el modelo, el formato de sus operaciones, los controladores y el software de ejecución tienen que ser compatibles. En ausencia de esa ruta, un sistema puede ejecutar inferencia en CPU o GPU. La etiqueta del chip describe una capacidad, no garantiza su utilización en cada aplicación ni una mejora universal de velocidad o consumo.
Una aplicación puede repartir una carga
En un programa real, una operación visible para el usuario puede componerse de varias etapas: preparar datos, ejecutar el modelo, procesar el resultado y presentarlo en pantalla. No hay razón para que todas esas fases correspondan a un único chip. La CPU puede preparar entradas y coordinar la ejecución, un acelerador puede resolver operaciones intensivas y la CPU o la GPU puede encargarse de etapas posteriores. El reparto concreto depende de cómo se escribió la aplicación y de la infraestructura de software que conecta el modelo con el hardware.
Windows ML ofrece un ejemplo documentado de esa capa de coordinación en Windows: Microsoft lo describe como un marco de inferencia local impulsado por ONNX Runtime que puede ejecutar modelos en CPU, GPU o NPU mediante proveedores de ejecución. La documentación dice que Windows administra esos proveedores y que la selección depende de la ruta de ejecución disponible; no equivale a afirmar que cada modelo vaya a utilizar todas las unidades ni que una carga se divida automáticamente entre ellas. Documentación de Windows ML.
Conviene distinguir repartir una aplicación de dividir un mismo cálculo. Un programa puede usar la CPU para unas funciones y la GPU para otras sin distribuir una única operación entre ambas. También puede delegar una parte del modelo y mantener otras etapas en el procesador central. Para saber cuál de esas situaciones sucede hace falta documentación del marco o de la aplicación, y no basta con que el ordenador enumere varios procesadores.
Qué puede decidir el software
La aplicación, el formato del modelo, el proveedor de ejecución, el controlador y el sistema operativo forman una cadena. Si cualquiera de sus eslabones no admite una operación determinada, puede ser necesario recurrir a otra unidad o a otra implementación. Por eso, una aplicación puede comportarse de forma distinta en dos equipos que anuncian una NPU o una GPU: pueden variar la compatibilidad, el controlador, la memoria disponible y la versión del software.
La documentación de Windows ML indica que la ejecución local puede apoyarse en CPU, GPU y NPU, pero esa posibilidad no demuestra por sí sola una política idéntica en todas las aplicaciones. El dato relevante es la ruta que la aplicación activa, no solo el inventario de hardware. Una especificación general del procesador tampoco identifica qué unidad ejecutó una función concreta durante una sesión.
Aceleración disponible no es rendimiento garantizado
Que un equipo pueda acelerar una tarea significa que hay hardware y software capaces de ofrecer una ruta de ejecución compatible. No demuestra cuánto se acelerará, si el resultado será perceptiblemente más rápido o si el consumo total de energía será menor. Para esas conclusiones harían falta mediciones reproducibles con la misma carga, configuración, versión de software y condiciones de comparación. Disponibilidad y resultado son preguntas diferentes.
La GPU puede ser adecuada para trabajos paralelos, pero el beneficio efectivo también depende de si la tarea se presta a ese patrón y de cuánto tiempo se dedica a transferir datos o coordinar las operaciones. Una tarea pequeña puede no amortizar el coste de delegarla. Del mismo modo, una NPU puede mejorar la eficiencia de una operación compatible, pero la mera presencia del acelerador no permite extrapolar el resultado a todos los modelos o a toda la aplicación. La documentación de fabricantes explica el diseño y los usos previstos; no sustituye a una prueba de la carga concreta.
También importa el contexto. En un escritorio virtual, por ejemplo, la aceleración puede abarcar tanto el renderizado como la codificación de los fotogramas que se envían por la red. Microsoft advierte que la codificación acelerada por GPU puede mejorar la experiencia, pero también consumir más ancho de banda y recursos del cliente y del host. Es un recordatorio útil: incluso cuando se identifica una unidad concreta, el coste se desplaza entre recursos, y el resultado depende del sistema completo. Microsoft: aceleración de GPU en Azure Virtual Desktop.
Por eso, las comparaciones útiles especifican qué se mide: tiempo de respuesta, rendimiento sostenido, consumo del equipo, calidad del resultado o carga sobre la red. Una afirmación genérica como «usa la GPU» no responde a esas preguntas. A menos que la fuente publique una metodología y resultados pertinentes, es más riguroso describir la capacidad técnica que prometer una mejora cuantificada.
Ejecución local y privacidad: una afirmación con límites
La inferencia local significa que un modelo se ejecuta en el dispositivo, en lugar de enviar necesariamente toda esa ejecución a un servicio remoto. Windows ML se presenta como un marco para ejecutar modelos localmente en el hardware del usuario y acceder a CPU, GPU o NPU. Eso hace posible que una aplicación procese determinados datos sin una conexión a la nube para esa etapa, pero no demuestra que la aplicación completa no envíe datos por otros motivos. Microsoft: Windows ML.
Un acelerador no prueba por sí solo dónde viajan los datos. Tener GPU o NPU no confirma que una función opere sin conexión, que todos los datos permanezcan en el dispositivo ni que no se contacte con servidores para autenticación, sincronización, telemetría u otras tareas. Para evaluar privacidad hay que consultar la documentación y la política de la aplicación, identificar qué información procesa y comprobar qué funciones requieren red. El modelo de ejecución y el comportamiento de la aplicación son capas relacionadas, pero no idénticas.
La misma cautela se aplica a la palabra local. Puede referirse a una etapa concreta de inferencia, no necesariamente a todos los componentes de un servicio. Si un fabricante afirma que una función se procesa en el dispositivo, la pregunta útil es qué función, qué datos y bajo qué configuración. Una afirmación delimitada permite entender mejor el alcance que una promesa general de «IA privada» basada únicamente en el tipo de chip.
Cómo comprobar qué unidad se está usando
Para verificar una afirmación de aceleración, conviene avanzar desde la documentación más específica hacia los indicadores del sistema. Primero, hay que localizar la documentación de la aplicación o del marco y comprobar qué unidades admite, qué versiones requiere y si la función está habilitada por defecto. Después, se puede revisar la documentación del sistema operativo y del fabricante del hardware. La compatibilidad anunciada es un primer filtro, no una prueba de uso efectivo.
Un administrador de tareas u otra herramienta de monitorización puede aportar indicios sobre la actividad de CPU, GPU o NPU durante una operación. Pero una gráfica de uso no siempre identifica qué proceso, subcomponente o etapa produce la actividad; tampoco acredita por sí sola que el resultado se haya acelerado. La visibilidad depende de la versión del sistema, del controlador y de las capacidades de monitorización. Si el sistema no ofrece un contador específico, no debe inferirse que la unidad esté inactiva: simplemente puede faltar esa observación.
Una comprobación práctica puede seguir estos pasos:
- Identificar la función exacta y el nombre del modelo o tarea que ejecuta.
- Consultar si la aplicación declara compatibilidad con CPU, GPU o NPU y qué proveedor de ejecución utiliza.
- Revisar los requisitos del sistema, el controlador y la versión de la aplicación.
- Observar la actividad de los recursos durante una tarea controlada, sin tratar el indicador como prueba concluyente.
- Si importa el rendimiento, comparar la misma carga con metodología y condiciones documentadas.
Para obtener una conclusión sólida, hay que combinar la declaración del software con una observación apropiada y, cuando se afirma una mejora, con una medición comparable. No existe un único indicador que resuelva todas las preguntas: el monitor puede señalar actividad, la documentación puede confirmar compatibilidad y una prueba puede medir rendimiento, pero cada evidencia responde a algo distinto.
Una regla útil para leer las etiquetas
La forma más segura de interpretar CPU, GPU y NPU es pensar en especializaciones complementarias, no en una escala donde cada chip nuevo sustituye al anterior. La CPU conserva el papel general y de coordinación; la GPU puede acelerar cargas gráficas y paralelizables; la NPU puede atender operaciones de IA que el software y el modelo puedan dirigir a ella. La combinación depende de la carga y del soporte de software, no solo del nombre que aparece en una ficha técnica.
Ante una afirmación como «la IA se ejecuta en la NPU», conviene preguntar qué función se ejecuta allí, si el modelo y el programa admiten ese camino, cómo se verifica la actividad y qué resultado se midió. Ante «funciona localmente», hay que precisar qué etapa corre en el dispositivo y qué datos pueden seguir comunicándose con servicios externos. Esas preguntas separan una capacidad real de una conclusión más amplia que la evidencia no sostiene.
La distinción final es sencilla: las especificaciones describen lo que un componente está diseñado para hacer; la documentación del software explica qué rutas puede utilizar; la monitorización muestra actividad en un contexto concreto; y las pruebas comparables permiten evaluar el resultado. Ninguna de esas piezas, por separado, demuestra todas las demás. Usarlas juntas ayuda a entender qué está haciendo el ordenador sin convertir una etiqueta de aceleración en una promesa de rendimiento, eficiencia o privacidad.