Tre unità, punti di forza diversi
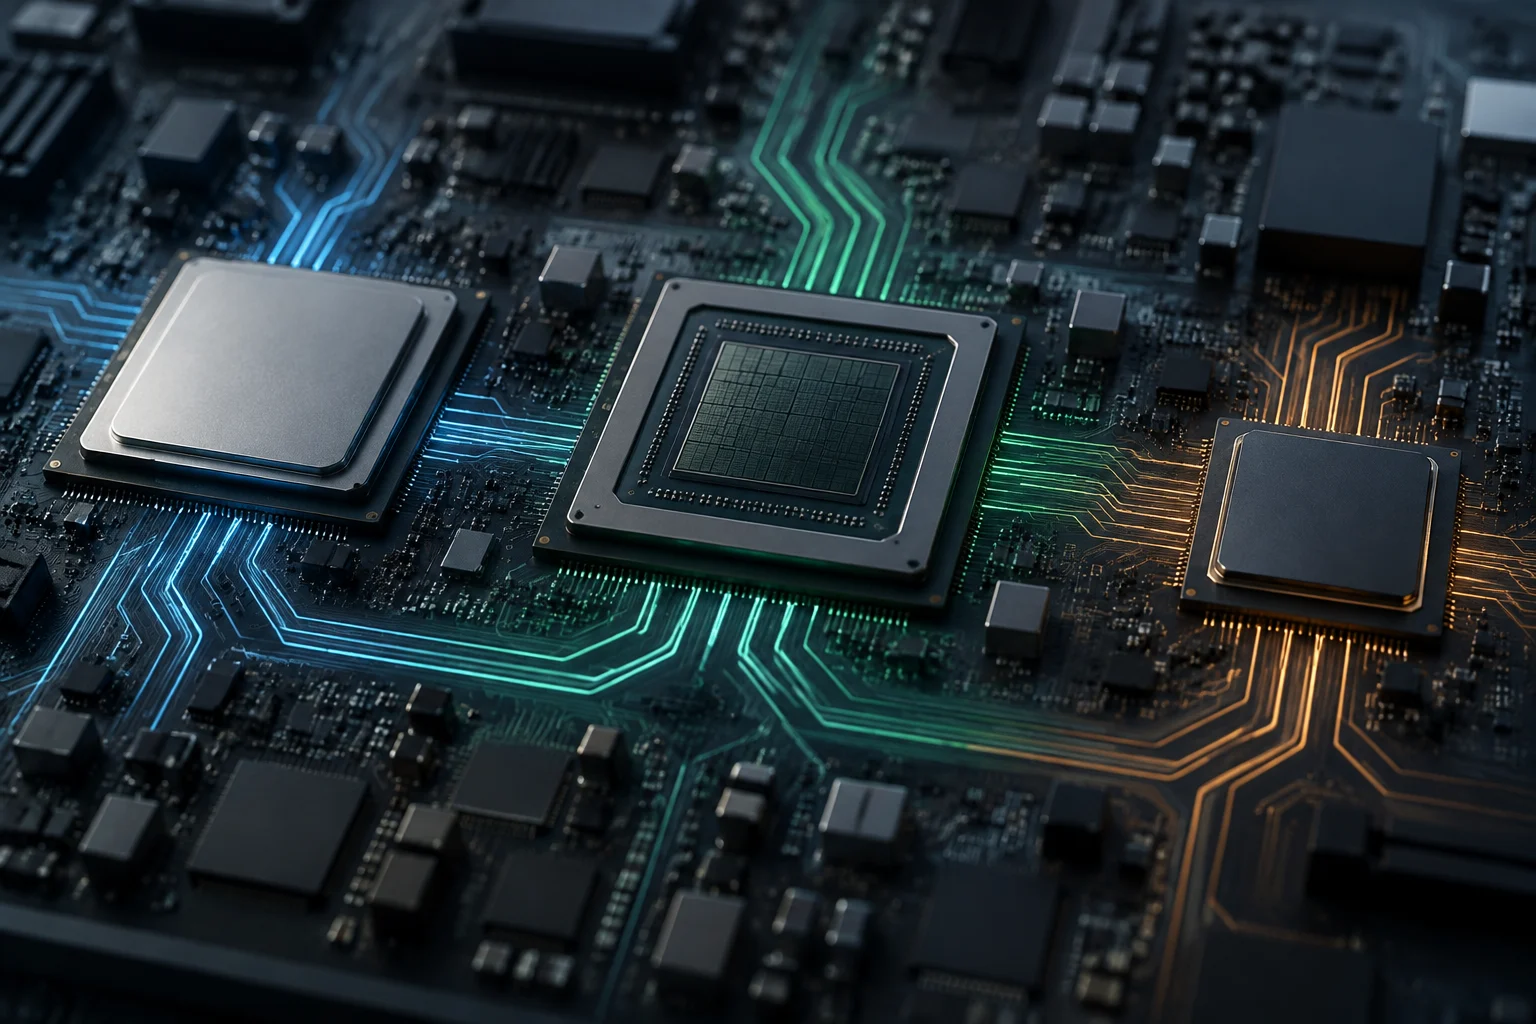
CPU, GPU e NPU vengono spesso presentate come tre motori di elaborazione, ma non sono alternative intercambiabili per la stessa attività. Ognuna ha un’architettura e uno scopo predominante: la CPU coordina ed esegue attività generiche, la GPU eccelle quando un carico può essere suddiviso tra molti calcoli simili, mentre la NPU è orientata alle operazioni usate dalle reti neurali e da altri modelli di IA. Il confine non è assoluto: il funzionamento effettivo dipende dal programma, dalle sue librerie e dalle risorse disponibili nel computer.
La CPU è il processore generico che esegue le istruzioni del sistema operativo e delle applicazioni. Può occuparsi di calcoli, logica, input e output e sequenze di istruzioni che richiedono decisioni successive. La sua versatilità la rende necessaria anche in un computer dotato di acceleratori: organizza il lavoro, esegue le parti non delegate e gestisce le attività del sistema. Non è corretto riassumerla come «la più lenta» o «la più veloce» senza specificare il carico, perché il confronto cambia in base al tipo di operazione. Microsoft descrive la CPU come il componente che dirige gli altri elementi di un dispositivo.
La GPU è nata come unità per la grafica, ma la sua capacità di eseguire molti calcoli in parallelo è utile anche al di fuori del rendering. La distinzione pratica non è che una GPU faccia tutto meglio, ma che possa elaborare con efficienza un carico quando le operazioni sono distribuibili in parallelo. Un’attività con dipendenze sequenziali o molto controllo potrebbe non trarne lo stesso vantaggio. La documentazione NVIDIA sul calcolo GPU e la spiegazione di AWS sulle differenze tra GPU e CPU descrivono proprio questa specializzazione nei calcoli paralleli. NVIDIA · AWS.
La NPU, invece, è un acceleratore progettato per eseguire determinati calcoli associati all’intelligenza artificiale. La sua presenza non significa che tutte le funzioni di IA vengano eseguite lì: il modello, il formato delle operazioni, i driver e il software di esecuzione devono essere compatibili. Se questo percorso non è disponibile, un sistema può eseguire l’inferenza su CPU o GPU. L’etichetta del chip descrive una capacità, ma non ne garantisce l’uso da parte di ogni applicazione né un miglioramento universale in termini di velocità o consumi.
Un’applicazione può distribuire un carico
In un programma reale, un’operazione visibile all’utente può articolarsi in più fasi: preparare i dati, eseguire il modello, elaborare il risultato e visualizzarlo sullo schermo. Non è necessario che tutte queste fasi facciano capo a un solo chip. La CPU può preparare gli input e coordinare l’esecuzione, un acceleratore può risolvere le operazioni più intensive e la CPU o la GPU può occuparsi delle fasi successive. La ripartizione concreta dipende da come è stata scritta l’applicazione e dall’infrastruttura software che collega il modello all’hardware.
Windows ML offre un esempio documentato di questo livello di coordinamento in Windows: Microsoft lo descrive come un framework per l’inferenza locale basato su ONNX Runtime, in grado di eseguire modelli su CPU, GPU o NPU tramite provider di esecuzione. La documentazione afferma che Windows gestisce questi provider e che la selezione dipende dal percorso di esecuzione disponibile; ciò non significa che ogni modello utilizzi tutte le unità o che un carico venga automaticamente suddiviso tra loro. Documentazione di Windows ML.
È utile distinguere la ripartizione del lavoro di un’applicazione dalla suddivisione dello stesso calcolo. Un programma può usare la CPU per alcune funzioni e la GPU per altre senza distribuire un’unica operazione tra le due. Può anche delegare una parte del modello e mantenere le altre fasi sul processore centrale. Per capire quale situazione si verifica servono le indicazioni del framework o dell’applicazione: non basta che il computer elenchi più processori.
Cosa può decidere il software
L’applicazione, il formato del modello, il provider di esecuzione, il driver e il sistema operativo formano una catena. Se uno degli anelli non supporta una determinata operazione, potrebbe essere necessario ricorrere a un’altra unità o implementazione. Per questo un’applicazione può comportarsi in modo diverso su due computer che dichiarano di avere una NPU o una GPU: possono variare la compatibilità, il driver, la memoria disponibile e la versione del software.
La documentazione di Windows ML indica che l’esecuzione locale può appoggiarsi a CPU, GPU e NPU, ma questa possibilità non dimostra che tutte le applicazioni seguano la stessa politica. Il dato rilevante è il percorso di esecuzione attivato dall’applicazione, non il solo inventario hardware. Inoltre, le specifiche generali del processore non identificano quale unità abbia eseguito una funzione concreta durante una sessione.
L’accelerazione disponibile non garantisce le prestazioni
Se un computer può accelerare un’attività, significa che hardware e software sono in grado di offrire un percorso di esecuzione compatibile. Non dimostra quanto aumenterà la velocità, se il risultato sarà sensibilmente più rapido o se il consumo energetico totale sarà inferiore. Per arrivare a queste conclusioni servono misurazioni riproducibili con lo stesso carico, configurazione, versione del software e condizioni di confronto. Disponibilità e risultato sono questioni diverse.
La GPU può essere adatta ai carichi paralleli, ma il vantaggio effettivo dipende anche da quanto l’attività si presta a questo schema e dal tempo necessario per trasferire i dati o coordinare le operazioni. Un’attività breve potrebbe non compensare il costo della delega. Analogamente, una NPU può migliorare l’efficienza di un’operazione compatibile, ma la sua semplice presenza non consente di estendere il risultato a tutti i modelli o all’intera applicazione. La documentazione dei produttori illustra la progettazione e gli usi previsti, ma non sostituisce una prova sul carico specifico.
Conta anche il contesto. In un desktop virtuale, ad esempio, l’accelerazione può riguardare sia il rendering sia la codifica dei fotogrammi inviati in rete. Microsoft avverte che la codifica accelerata dalla GPU può migliorare l’esperienza, ma anche consumare più larghezza di banda e risorse del client e dell’host. È un promemoria utile: anche quando si identifica un’unità specifica, i costi si spostano tra le risorse e il risultato dipende dal sistema nel suo complesso. Microsoft: accelerazione GPU in Azure Virtual Desktop.
Per questo i confronti utili specificano cosa viene misurato: tempo di risposta, prestazioni sostenute, consumo del computer, qualità del risultato o carico sulla rete. Un’affermazione generica come «usa la GPU» non risponde a queste domande. Se la fonte non pubblica una metodologia e risultati pertinenti, è più rigoroso descrivere la capacità tecnica che promettere un miglioramento quantificato.
Esecuzione locale e privacy: un’affermazione con dei limiti
L’inferenza locale significa che un modello viene eseguito sul dispositivo, anziché inviare necessariamente tutta l’esecuzione a un servizio remoto. Windows ML è presentato come un framework per eseguire modelli in locale sull’hardware dell’utente e accedere a CPU, GPU o NPU. Ciò consente a un’applicazione di elaborare determinati dati senza una connessione al cloud per quella fase, ma non dimostra che l’applicazione nel suo complesso non invii dati per altri motivi. Microsoft: Windows ML.
Un acceleratore, da solo, non dimostra dove viaggiano i dati. La presenza di una GPU o di una NPU non conferma che una funzione operi offline, che tutti i dati restino sul dispositivo o che l’applicazione non contatti server per autenticazione, sincronizzazione, telemetria o altre attività. Per valutare la privacy occorre consultare la documentazione e l’informativa dell’applicazione, individuare le informazioni trattate e verificare quali funzioni richiedono la rete. Il modello di esecuzione e il comportamento dell’applicazione sono livelli collegati, ma non identici.
La stessa cautela vale per la parola locale. Può riferirsi a una specifica fase di inferenza, non necessariamente a tutti i componenti di un servizio. Se un produttore afferma che una funzione viene elaborata sul dispositivo, le domande utili sono: quale funzione, quali dati e con quale configurazione? Un’affermazione circoscritta chiarisce la portata meglio di una promessa generica di «IA privata» basata soltanto sul tipo di chip.
Come verificare quale unità viene usata
Per verificare un’affermazione sull’accelerazione, conviene partire dalla documentazione più specifica e poi passare agli indicatori del sistema. Per prima cosa, si cerca la documentazione dell’applicazione o del framework e si controlla quali unità supporta, quali versioni richiede e se la funzione è attiva per impostazione predefinita. Poi si può consultare la documentazione del sistema operativo e del produttore dell’hardware. La compatibilità dichiarata è un primo filtro, non una prova di utilizzo effettivo.
Un task manager o un altro strumento di monitoraggio può fornire indizi sull’attività di CPU, GPU o NPU durante un’operazione. Tuttavia, un grafico di utilizzo non identifica sempre il processo, il sottocomponente o la fase che genera l’attività; inoltre, da solo non dimostra che il risultato sia stato accelerato. La visibilità dipende dalla versione del sistema, dal driver e dalle capacità di monitoraggio. Se il sistema non offre un contatore specifico, non bisogna dedurre che l’unità sia inattiva: potrebbe semplicemente mancare quel tipo di osservazione.
Una verifica pratica può seguire questi passaggi:
- Individuare la funzione esatta e il nome del modello o dell’attività che esegue.
- Verificare se l’applicazione dichiara la compatibilità con CPU, GPU o NPU e quale provider di esecuzione utilizza.
- Controllare i requisiti di sistema, il driver e la versione dell’applicazione.
- Osservare l’attività delle risorse durante un’operazione controllata, senza considerare l’indicatore una prova conclusiva.
- Se le prestazioni sono importanti, confrontare lo stesso carico con una metodologia e condizioni documentate.
Per arrivare a una conclusione solida occorre combinare le dichiarazioni del software con un’osservazione adeguata e, quando si afferma un miglioramento, con una misurazione comparabile. Non esiste un unico indicatore che risponda a tutte le domande: un monitor può segnalare attività, la documentazione può confermare la compatibilità e un test può misurare le prestazioni, ma ciascun tipo di evidenza risponde a una domanda diversa.
Una regola utile per interpretare le etichette
Il modo più sicuro per interpretare CPU, GPU e NPU è considerarli specializzazioni complementari, non una scala in cui ogni nuovo chip sostituisce il precedente. La CPU mantiene il ruolo generale e di coordinamento; la GPU può accelerare i carichi grafici e parallelizzabili; la NPU può gestire le operazioni di IA che il software e il modello sono in grado di indirizzarle. La combinazione dipende dal carico e dal supporto software, non solo dal nome riportato nelle specifiche.
Di fronte a un’affermazione come «l’IA viene eseguita sulla NPU», è utile chiedersi quale funzione vi venga eseguita, se il modello e il programma supportano quel percorso, come viene verificata l’attività e quale risultato è stato misurato. Per «funziona in locale», bisogna precisare quale fase viene eseguita sul dispositivo e quali dati possono comunque essere comunicati a servizi esterni. Queste domande distinguono una capacità reale da una conclusione più ampia non supportata dalle prove.
La distinzione finale è semplice: le specifiche descrivono ciò che un componente è progettato per fare; la documentazione del software spiega quali percorsi può utilizzare; il monitoraggio mostra l’attività in un contesto specifico; e i test comparabili permettono di valutare il risultato. Nessuno di questi elementi, da solo, dimostra tutti gli altri. Usarli insieme aiuta a capire cosa sta facendo il computer senza trasformare un’etichetta di accelerazione in una promessa di prestazioni, efficienza o privacy.