Che cosa significa IA sul dispositivo
L’IA sul dispositivo è l’elaborazione di una funzione di intelligenza artificiale direttamente sull’apparecchio che la utilizza: per esempio, un telefono, un computer o un browser. In termini tecnici, il modello vi esegue l’inferenza: riceve un input, calcola un risultato e lo restituisce all’applicazione. A seconda delle capacità del modello, l’input può essere testo, un’immagine, audio o un altro tipo di dato.
Il termine descrive dove viene eseguito il calcolo, non quale tipo di intelligenza abbia il sistema né chi lo abbia prodotto. Può trattarsi di un modello tradizionale di apprendimento automatico o di uno generativo; può essere una funzione semplice, come riconoscere il testo in un’immagine, oppure un’attività linguistica più complessa. La sola esecuzione locale non implica che l’intero servizio, l’app o i suoi dati restino fuori da Internet.
IA sul dispositivo indica l’inferenza eseguita sull’apparecchio dell’utente. Un’applicazione può combinare fasi locali e remote: per capire dove avviene il calcolo, occorre considerare il percorso della singola funzione.
Come il dispositivo elabora una richiesta
Il processo di base inizia quando un’applicazione prepara un input — per esempio, una frase da riassumere o un’immagine da descrivere — e lo passa a un modello disponibile localmente. Il modello trasforma l’input in operazioni matematiche e produce una risposta; l’app la mostra oppure la usa per completare un’attività. L’inferenza avviene sul dispositivo quando il calcolo non richiede l’invio della richiesta a un server.
Il modello può essere integrato nel sistema, scaricato separatamente oppure incluso nell’applicazione stessa. Un livello software stabilisce come richiamarlo e quali risorse hardware usare. Su Android, per esempio, Google descrive AICore come un servizio di sistema tra le app e Gemini Nano; la piattaforma gestisce l’accesso al modello e la sua distribuzione. È un esempio di architettura, non una caratteristica universale di tutti i telefoni.
A livello hardware, la CPU può gestire il flusso generale dell’applicazione ed eseguire modelli compatibili; la GPU può accelerare i calcoli paralleli e la NPU è progettata per determinate operazioni di apprendimento automatico. Non tutti i modelli usano la NPU: dipende dal dispositivo, dal sistema, dal formato del modello e dal software. In Windows, gli strumenti di inferenza possono selezionare un acceleratore compatibile e, in alcuni casi, ricorrere a CPU o GPU se un altro percorso non è disponibile.
Contano anche la memoria disponibile e la rappresentazione del modello. Un modello più grande o un input più lungo possono richiedere più memoria e tempo di calcolo. La quantizzazione riduce la precisione numerica dei pesi per rendere alcuni modelli più compatti o efficienti, con possibili compromessi sulla qualità. La presenza di un acceleratore, quindi, non garantisce che qualunque modello o funzione venga eseguito lì con buone prestazioni.
IA locale, IA nel cloud e inferenza ibrida
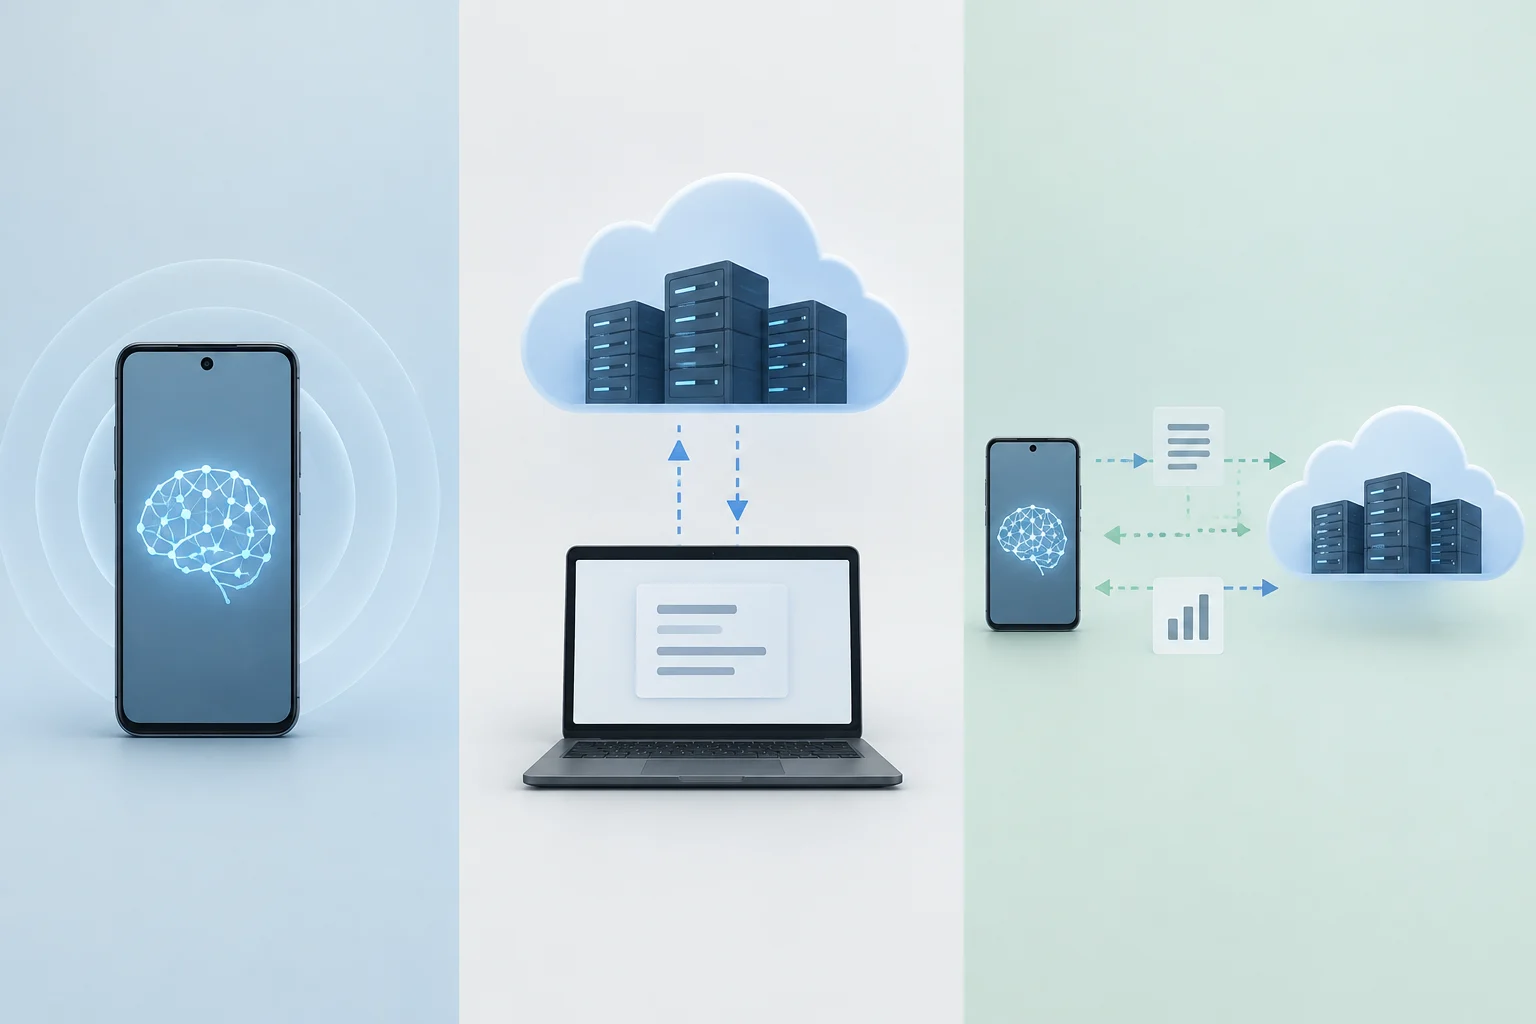
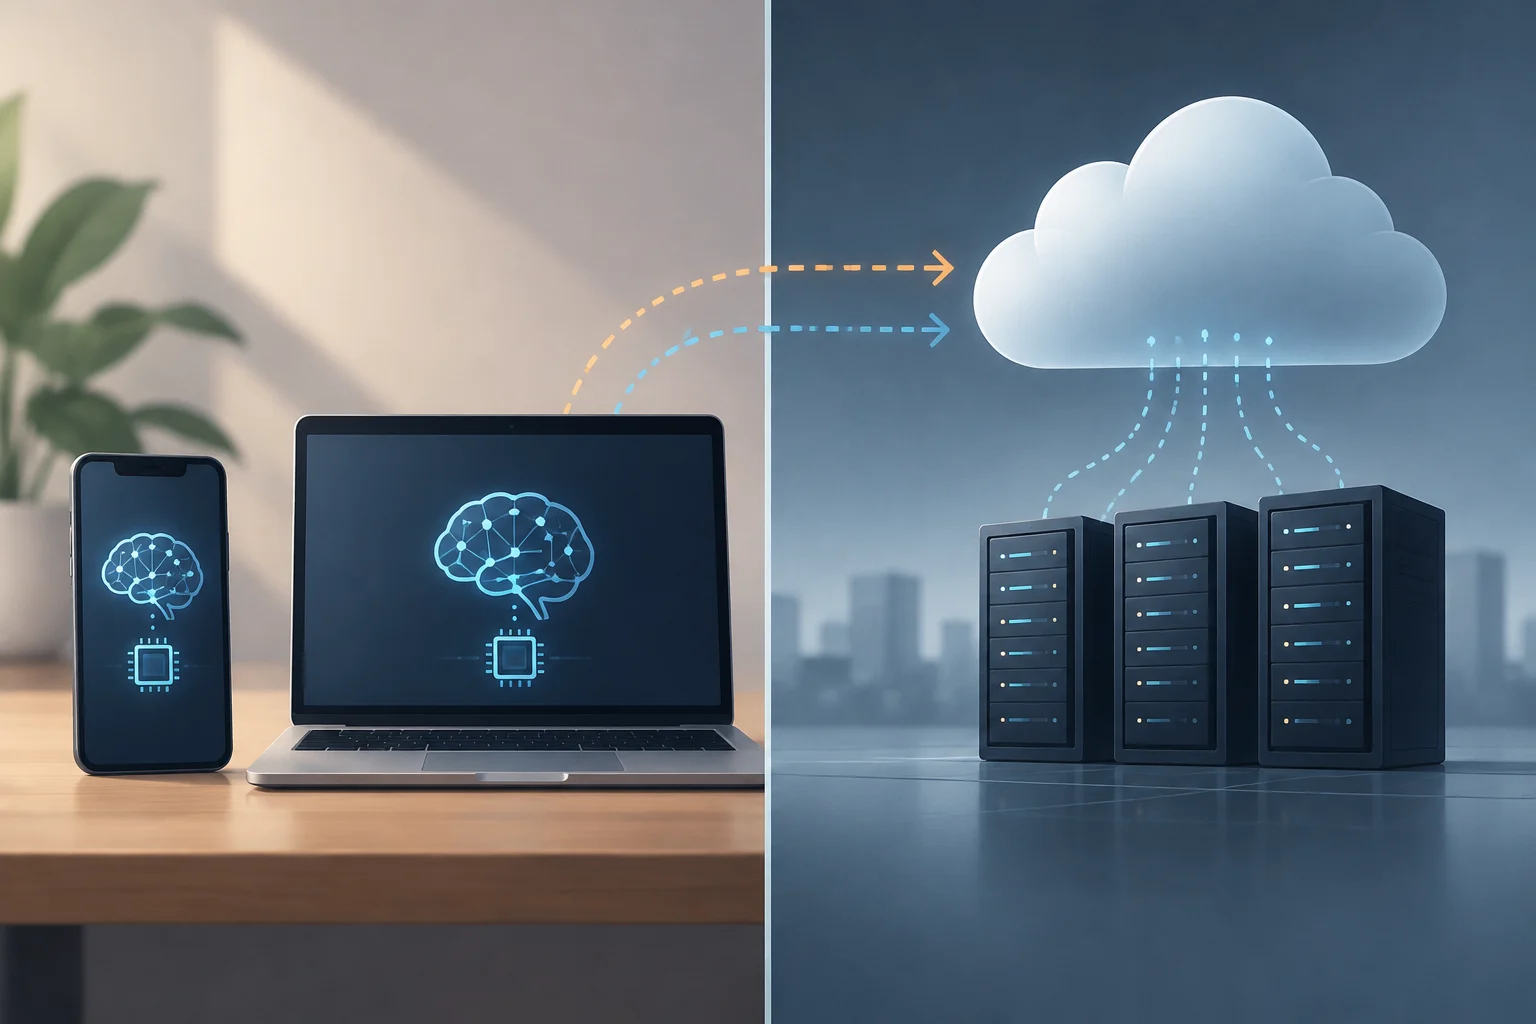
La distinzione principale riguarda il luogo in cui viene calcolata la risposta. In un percorso locale, il modello elabora la richiesta sul dispositivo. In un percorso cloud, l’applicazione trasmette i dati a un servizio remoto che esegue il modello e restituisce il risultato. Un’architettura ibrida può distribuire le fasi tra i due ambienti oppure scegliere un percorso in base all’attività e alle capacità del dispositivo.
| Aspetto | Elaborazione sul dispositivo | Elaborazione nel cloud |
|---|---|---|
| Dove avviene il calcolo | Sul telefono, computer o altro dispositivo dell’utente | Sui server remoti del fornitore |
| Connessione per l’inferenza | Può funzionare offline se modello e funzione sono già disponibili | Di norma serve una connessione per inviare la richiesta e ricevere la risposta |
| Latenza potenziale | Evita il percorso di rete, ma dipende dall’hardware e dal modello | Aggiunge il tempo di comunicazione a quello dell’elaborazione remota |
| Dati | La richiesta può restare sul dispositivo se la funzione è progettata in questo modo | I dati inviati vengono elaborati fuori dal dispositivo, secondo il servizio e le sue politiche |
La tabella descrive tendenze, non garanzie: un’applicazione può sincronizzare dati, scaricare modelli o inviare telemetria anche quando una specifica inferenza è locale.
L’inferenza ibrida combina i due percorsi. Un’app può prima provare a rispondere localmente e passare a un modello remoto se quello locale non è disponibile, se la richiesta supera i suoi limiti o se l’utente chiede una funzione che richiede servizi online. La documentazione per sviluppatori Android descrive proprio questo tipo di alternativa: alcune richieste possono essere inviate a modelli cloud quando Gemini Nano non è disponibile o non è adatto.
Di conseguenza, «locale» e «cloud» non sono sempre categorie esclusive per un’intera applicazione. Una funzione può analizzare un testo sul dispositivo e poi sincronizzare il risultato; un’altra può usare il modello locale per attività semplici e un servizio remoto per richieste più complesse. Il percorso può cambiare da una funzione all’altra, quindi è più utile chiedersi cosa accade a una specifica operazione che assegnare un’unica etichetta a tutta l’app.
Quali attività possono essere eseguite localmente
Le attività adatte al dispositivo hanno in genere un ambito definito e rientrano nelle risorse disponibili. Tra gli esempi documentati dalle piattaforme figurano la trascrizione o traduzione del parlato, il riepilogo di testi brevi, la riscrittura di messaggi, la descrizione di immagini, il riconoscimento del testo in una fotografia e la generazione di risultati strutturati. Possono esserci anche funzioni di sistema come il riconoscimento della scrittura a mano o la riduzione del rumore durante una chiamata.
Un esempio pratico è estrarre testo da un’immagine. La fotocamera acquisisce un segnale visivo e un modello di riconoscimento ottico dei caratteri (OCR) identifica i caratteri; l’applicazione può mostrare il testo o consentirne la copia. Android offre API di riconoscimento del testo in grado di elaborare sul dispositivo le immagini della fotocamera. Se la funzione richiede soltanto l’immagine e il modello locale, può operare senza inviare ogni acquisizione a un servizio remoto, anche se il comportamento dipende dall’app specifica.
Un caso d’uso documentato su Android è riassumere registrazioni vocali: l’app Registratore Google Pixel usa Gemini Nano per generare riepiloghi offline e sul dispositivo. Separatamente, le API di IA generativa di ML Kit consentono di trascrivere l’audio parlato in testo, tradurre la voce e sintetizzare la voce a partire dal testo. La disponibilità dipende dall’applicazione e dalla compatibilità del dispositivo.
Altri usi sono meno visibili, come classificare contenuti o trovare file in base al significato anziché cercare soltanto corrispondenze esatte. Un modello può creare rappresentazioni numeriche di testi o immagini — embedding — affinché un indice locale recuperi elementi correlati. In altri casi, il sistema interpreta ciò che appare sullo schermo per proporre azioni contestuali. L’elaborazione locale non garantisce che il risultato sia corretto: la qualità dipende dal modello e dal contesto, e le attività sensibili possono richiedere una verifica umana.
Possibili vantaggi e limiti delle prestazioni
Il vantaggio più diretto dell’inferenza locale è evitare una parte del percorso di rete: se la richiesta viene risolta sul dispositivo, la risposta non deve attendere che la chiamata raggiunga il server e torni indietro. Questo può ridurre la latenza, ma non garantisce un calcolo rapido; un modello impegnativo su un dispositivo modesto può impiegare più tempo di un servizio remoto potente.
Un’altra possibilità è il funzionamento offline. Perché avvenga, il modello e i componenti necessari devono essere già installati e la funzione non deve dipendere da una richiesta esterna. Il download iniziale, l’aggiornamento del modello, la sincronizzazione dei file o uno strumento connesso a Internet possono comunque richiedere la rete. «Può funzionare offline» non significa «non ha mai bisogno di Internet».
L’hardware impone limiti concreti: potenza di calcolo, memoria, spazio di archiviazione, temperatura ed energia disponibile. Una NPU può accelerare operazioni compatibili e lasciare risorse libere per altri compiti, ma non elimina il costo di esecuzione del modello. Per attività prolungate, consumo ed eventuale surriscaldamento restano importanti; le specifiche del produttore, da sole, non bastano a dedurre le prestazioni di ogni applicazione o carico di lavoro.
Anche dimensioni e capacità del modello condizionano ciò che può fare. Un modello compatto può rispondere rapidamente a compiti circoscritti, ma essere meno capace con istruzioni lunghe, contesti estesi o domande complesse. Google segnala limiti hardware, di token e di capacità del modello per Gemini Nano e propone l’inferenza ibrida quando serve ampliare le possibilità. La scelta pratica è usare il modello locale quando svolge bene l’attività con le risorse disponibili e riservare il percorso remoto alle funzioni che ne hanno davvero bisogno.
Privacy e sicurezza: cosa garantisce e cosa no
L’elaborazione locale può ridurre la quantità di informazioni che una funzione deve trasmettere: se una richiesta viene risolta sul dispositivo, per quella inferenza non occorre inviare l’input a un server. È una proprietà del percorso dei dati, non una certificazione generale di privacy. L’applicazione può comunque inviare altri dati, sincronizzare contenuti, registrare attività o usare servizi remoti per funzioni diverse.
L’informativa sulla privacy, i controlli dell’applicazione e le impostazioni di sistema determinano quali dati vengono raccolti e per quali finalità. Conta anche dove vengono memorizzati input, output e dati temporanei, chi può accedervi e se l’app li conserva dopo l’elaborazione. Per una scelta sensibile, è opportuno controllare le autorizzazioni richieste, le impostazioni della funzione e l’informativa del fornitore, oltre a verificare se sia possibile disattivarla o cancellarne i dati.
L’elaborazione locale non evita rischi come un’applicazione dannosa, un dispositivo compromesso, l’accesso non autorizzato a un account o un risultato errato del modello. La cifratura dell’archiviazione, l’autenticazione e i controlli di sistema aiutano a proteggere i dati, ma sono misure distinte dal luogo in cui avviene l’inferenza. Locale non significa automaticamente sicuro, così come una connessione cloud non rende di per sé insicuro un servizio.
Alcune piattaforme offrono controlli specifici per singole funzioni. La documentazione Microsoft su Recall, per esempio, descrive archiviazione locale cifrata, attivazione volontaria e controlli per sospendere o cancellare i dati; sono condizioni di quella funzione e non vanno estese a tutta l’IA sul dispositivo. Le domande utili sono quali dati elabora la funzione, dove li conserva, se escono dal dispositivo e quali controlli ha l’utente.
Come valutare una funzione prima di usarla
L’etichetta «IA sul dispositivo» può essere indicativa, ma è utile verificare il comportamento della funzione specifica. Su un telefono o computer, le informazioni di compatibilità possono indicare i modelli e le versioni supportati; le impostazioni di privacy possono mostrare autorizzazioni, archiviazione e opzioni di sincronizzazione.
Una verifica pratica può concentrarsi su quattro domande: quale input elabora? Quali parti vengono eseguite localmente? Cosa accade senza connessione? Quali dati vengono conservati o condivisi? Non dare per scontato che la modalità offline sia attiva solo perché il modello viene eseguito localmente.
Il confronto non serve a proclamare un’architettura vincitrice. La scelta dipende dall’uso e dai dati, oltre che dalle opzioni effettive dell’app, non soltanto dal nome commerciale della funzione. La latenza dell’inferenza locale dipende dall’hardware e dal modello; il ricorso al cloud può essere utile quando il modello locale non è disponibile, non è compatibile o non è adatto alla richiesta.
In sintesi, IA sul dispositivo significa che una parte dell’inferenza avviene sull’apparecchio dell’utente. Può migliorare la disponibilità e limitare l’invio di dati per quella specifica operazione, ma i risultati dipendono da hardware, modello e progettazione software. Per valutare la privacy occorre esaminare l’intero percorso dei dati; la capacità locale va invece confrontata con l’attività da svolgere.