Che cosa significa inferenza locale
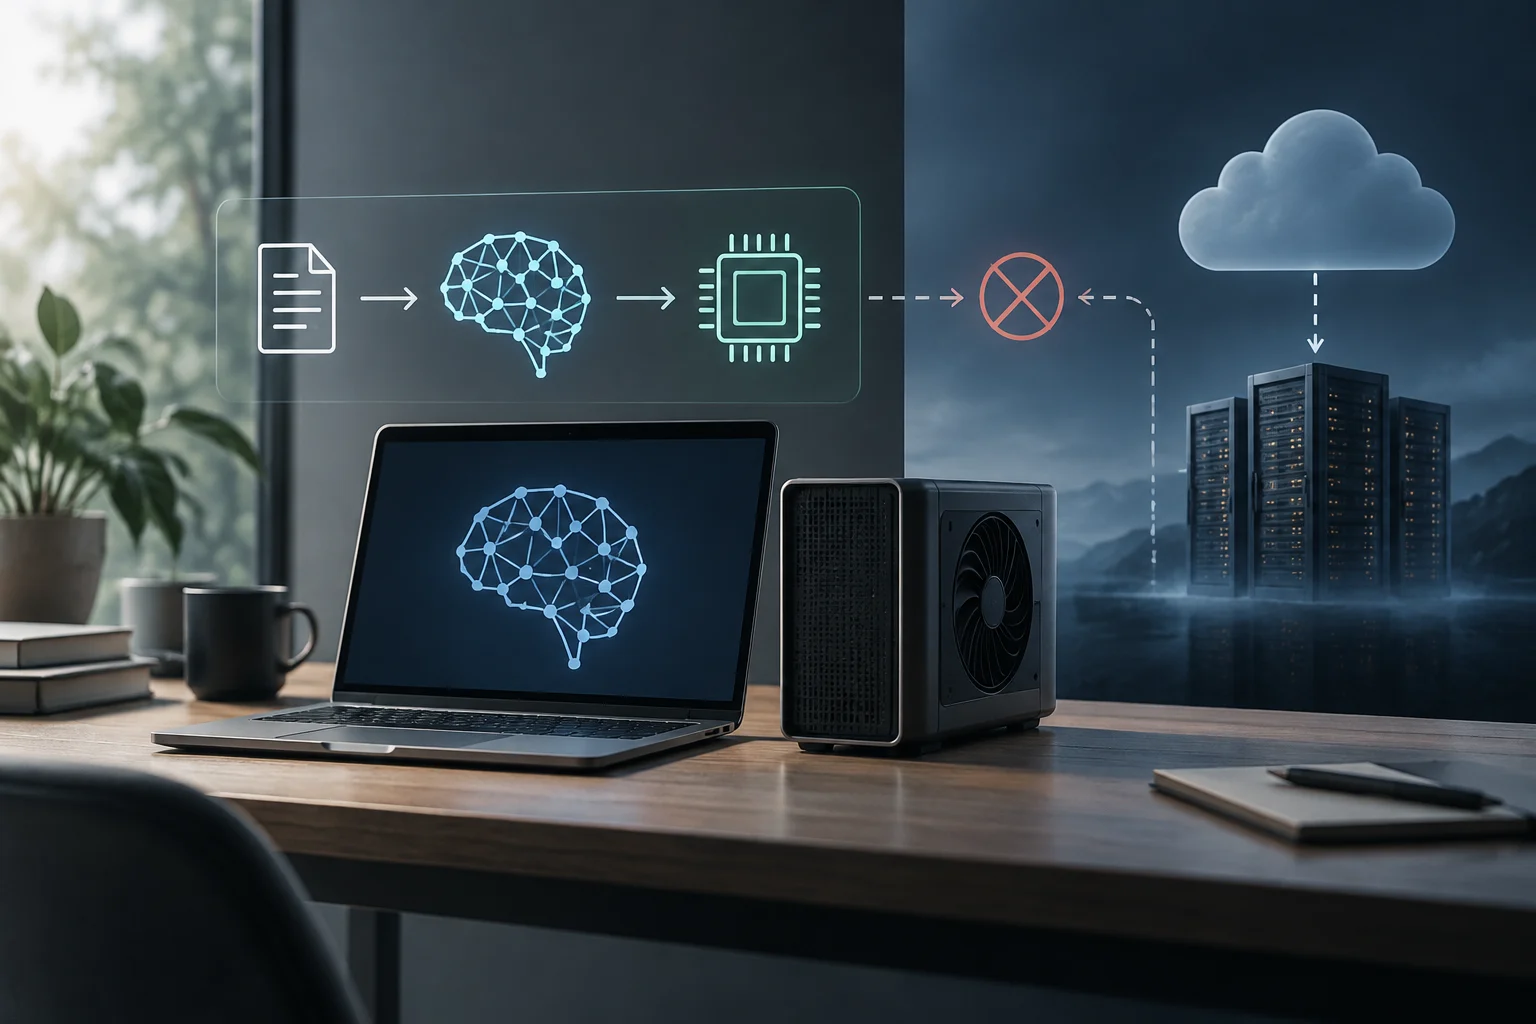
L’inferenza locale consiste nell’eseguire un modello di intelligenza artificiale sul dispositivo dell’utente o su un’infrastruttura controllata dalla sua organizzazione. Il modello è già stato addestrato: riceve un input, calcola una risposta e la restituisce. Per esempio, un assistente testuale può generare la continuazione di un testo; una fotocamera può classificare un’immagine.
La parola locale indica dove avviene il calcolo, non chi ha creato il modello né come è stato ottenuto. Un modello con pesi aperti scaricato da un archivio può essere eseguito su un computer di proprietà; lo stesso vale per un modello distribuito da un fornitore. Ciò che conta è che la richiesta venga elaborata sul dispositivo o nell’ambiente locale, anziché essere inviata a un servizio remoto per ottenere la risposta.
L’inferenza non va confusa con l’addestramento. Addestrare significa modificare i parametri del modello sulla base dei dati; inferire significa usare un modello già preparato per produrre un risultato a partire da un nuovo input. L’inferenza può comprendere operazioni aggiuntive, come recuperare documenti o richiamare uno strumento, senza che queste cambino il significato fondamentale del termine.
Il percorso di una richiesta
In un’applicazione locale si seleziona innanzitutto un modello compatibile e si caricano i relativi file nello spazio di archiviazione e nella memoria necessari. L’applicazione prepara l’input — per esempio, converte un’immagine nella rappresentazione prevista da un modello visivo oppure trasforma il testo in token — e il motore di esecuzione distribuisce il calcolo tra CPU, GPU e acceleratori disponibili. Infine, l’applicazione converte l’output interno in testo, etichette, punteggi o altri risultati utilizzabili.
Dai dati alla risposta
In un modello linguistico, il testo viene suddiviso in token ed elaborato insieme al contesto pertinente. Il motore di inferenza non sostituisce il modello: fornisce l’ambiente che ne carica ed esegue le operazioni.
Nella visione artificiale, il percorso può iniziare con un’immagine acquisita da una fotocamera. Il programma la adatta alle dimensioni e al formato di input richiesti, esegue il modello e converte i tensori di output in oggetti rilevati, categorie o coordinate. Nei sistemi edge, come una fotocamera o un dispositivo industriale, il dispositivo può poi inviare un avviso o un riepilogo invece di trasmettere continuamente i dati originali. Questa soluzione può risparmiare banda, ma il risultato dipende dalla struttura dell’applicazione e dall’eventuale invio di informazioni tramite altri canali.
GPU, VRAM e RAM: quali risorse limitano il modello
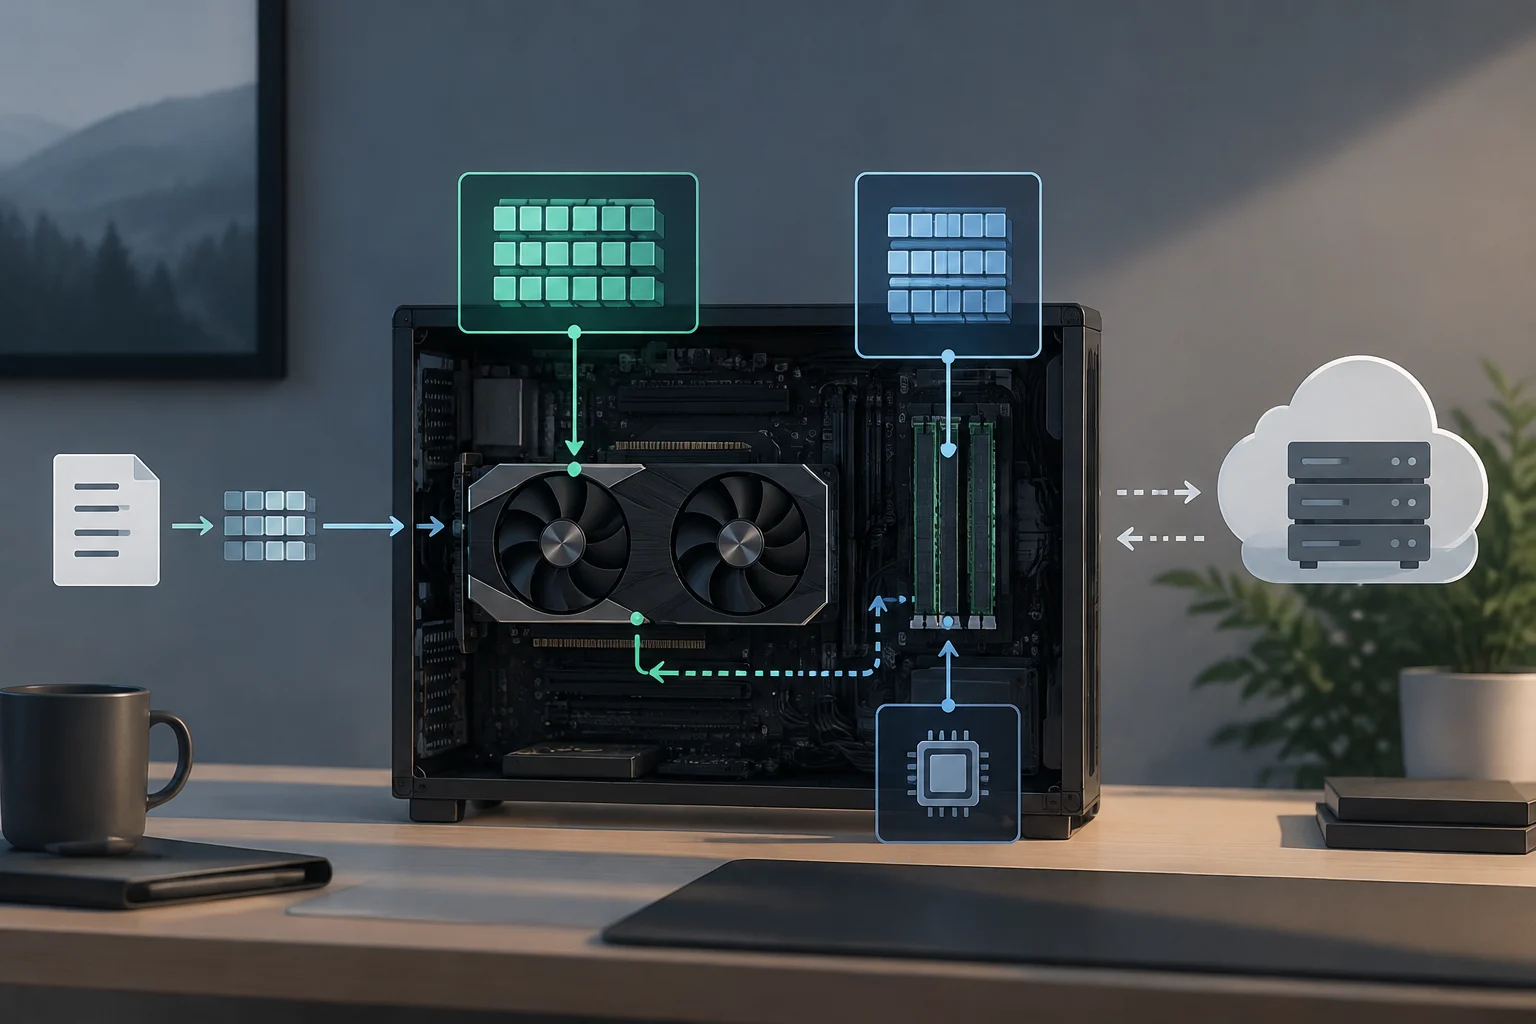
La fattibilità dipende dal fatto che il modello e i dati di lavoro possano stare nella memoria disponibile e dalla velocità con cui il dispositivo riesce a eseguire i calcoli. In una GPU dedicata, la VRAM contiene i pesi e gli altri dati necessari all’acceleratore. La RAM di sistema ospita il processo, può contenere parti del modello e permette l’esecuzione su CPU o di supportare configurazioni in cui il modello non entra interamente nella GPU.
La GPU può accelerare le operazioni parallele comuni nelle reti neurali, ma non è sempre indispensabile. Un modello può funzionare su CPU se software e formato lo consentono; di solito sarà più lento, ma non necessariamente inutilizzabile. Alcuni dispositivi dispongono anche di NPU o altri acceleratori, utilizzabili solo se supportati dal motore di esecuzione e dal modello. Conta la compatibilità dell’intero insieme, non soltanto il nome del componente: sistema operativo, driver, formato del modello e motore devono funzionare insieme.
La dimensione del file del modello è un primo indizio, ma non rappresenta da sola tutta la memoria richiesta durante l’inferenza. Contano anche la precisione o quantizzazione dei pesi, la lunghezza del contesto, la dimensione del batch e la memoria temporanea creata durante l’esecuzione. In un modello linguistico, un contesto più lungo può aumentare l’uso della memoria; è quindi prudente lasciare margine invece di dimensionare il dispositivo esattamente sulla dimensione del download.
Una guida hardware di PromptQuorum offre una regola indicativa per alcuni modelli linguistici quantizzati: circa 4–5 GB per un modello da 7 miliardi di parametri in Q4_K_M e circa 40 GB per uno da 70 miliardi nella stessa quantizzazione. Sono stime riferite a una configurazione specifica, non requisiti universali né una garanzia di velocità: formato, contesto e motore possono modificare il consumo effettivo. Per scegliere un dispositivo, è utile controllare la scheda del modello e misurarlo con il carico di lavoro previsto.
Locale o cloud: differenze che incidono sulla scelta
Con l’inferenza remota, l’applicazione invia una richiesta a un server tramite API e riceve la risposta attraverso la rete. Il fornitore gestisce l’hardware del servizio; l’utente evita di installarvi e gestirvi il modello, ma deve considerare la connettività, le condizioni del servizio e il trattamento dei dati inviati. Con l’inferenza locale, l’organizzazione si occupa di download, distribuzione, compatibilità e manutenzione; il calcolo può proseguire senza una connessione esterna se l’applicazione non dipende da altri servizi.
| Criterio | Inferenza locale | Inferenza cloud o tramite API |
|---|---|---|
| Dove avviene il calcolo | Dispositivo o infrastruttura locale | Server remoti del fornitore o dell’operatore |
| Connessione durante la richiesta | Può funzionare senza Internet se modello e applicazione sono disponibili localmente | La richiesta dipende dalla connessione al servizio |
| Dati in ingresso | Possono rimanere nell’ambiente locale; occorre comunque esaminare il resto dell’applicazione | Vengono trasmessi al servizio per l’elaborazione, in base alla configurazione |
| Risorse e operatività | L’hardware proprio limita memoria e capacità; l’utente gestisce modelli e aggiornamenti | Il fornitore mette a disposizione capacità e gestisce parte dell’infrastruttura |
| Costo | Hardware, elettricità, spazio di archiviazione e manutenzione: non equivale a costo zero | Può essere calcolato in base all’uso o alla capacità, secondo il servizio |
La tabella riassume differenze architetturali, non garantisce privacy, velocità o prezzo di uno specifico servizio. L’invio di una richiesta al cloud non determina da solo per quanto tempo sarà conservata né chi potrà accedervi: queste condizioni dipendono dal fornitore, dalla configurazione e dal contratto.
La latenza non ha un vincitore automatico. L’elaborazione locale evita il percorso di rete fino al server, un vantaggio possibile per applicazioni interattive o dispositivi con connettività instabile. Tuttavia, una potente GPU remota può calcolare più rapidamente di un dispositivo modesto, mentre un grande modello locale può richiedere troppo tempo per l’uso previsto. È importante distinguere il tempo di comunicazione da quello di calcolo e valutare l’intero percorso.
Anche i costi seguono una logica simile. Eseguire il modello su un dispositivo già disponibile evita una tariffa per richiesta se non si usa un servizio a pagamento, ma non elimina i costi di acquisto, energia, assistenza, sostituzione e manutenzione. Nel cloud la spesa può crescere con l’utilizzo; in cambio, si accede a risorse non installate su ogni dispositivo. La scelta utile confronta il costo totale per un carico di lavoro e un periodo definiti, senza equiparare “locale” a gratuito o “cloud” a più caro.
Privacy, sicurezza e limiti pratici
Elaborare i dati localmente può ridurre la necessità di inviare il contenuto della richiesta a un fornitore remoto. Questo riduce una possibile via di esposizione, ma non garantisce da solo la privacy. Un’applicazione potrebbe sincronizzare registri, interrogare un servizio esterno o inviare telemetria; restano importanti anche i permessi del sistema, l’accesso di altri utenti e la protezione del dispositivo.
L’esecuzione locale trasferisce responsabilità al team che gestisce il dispositivo o il servizio. Occorre mantenere aggiornati modello e software, controllare chi può accedere al servizio locale e verificare l’origine e le condizioni d’uso dei modelli. In un’organizzazione, installare software sui propri server non significa automaticamente che i dati siano isolati: contano la rete, le credenziali, i registri, i backup e la configurazione di ciascun componente.
Per quanto riguarda la capacità, l’hardware locale pone di norma un limite pratico alle dimensioni e alla complessità del modello, al contesto elaborabile e al numero di richieste simultanee. Un modello più piccolo può andare bene per un compito circoscritto, ma non è detto che eguagli un sistema remoto più potente in tutte le attività. La qualità dipende dal modello e dal caso d’uso, non soltanto dal luogo in cui viene eseguito.
Ci sono anche costi operativi che non compaiono in una tariffa per token: predisporre l’ambiente, scaricare file, risolvere incompatibilità, monitorare le risorse e distribuire aggiornamenti. La manutenzione può essere semplice su un singolo dispositivo; in una flotta aziendale diventa un’attività di distribuzione e assistenza. L’inferenza locale offre controllo sull’ambiente, ma tale controllo richiede lavoro tecnico.
Motori di esecuzione e strumenti
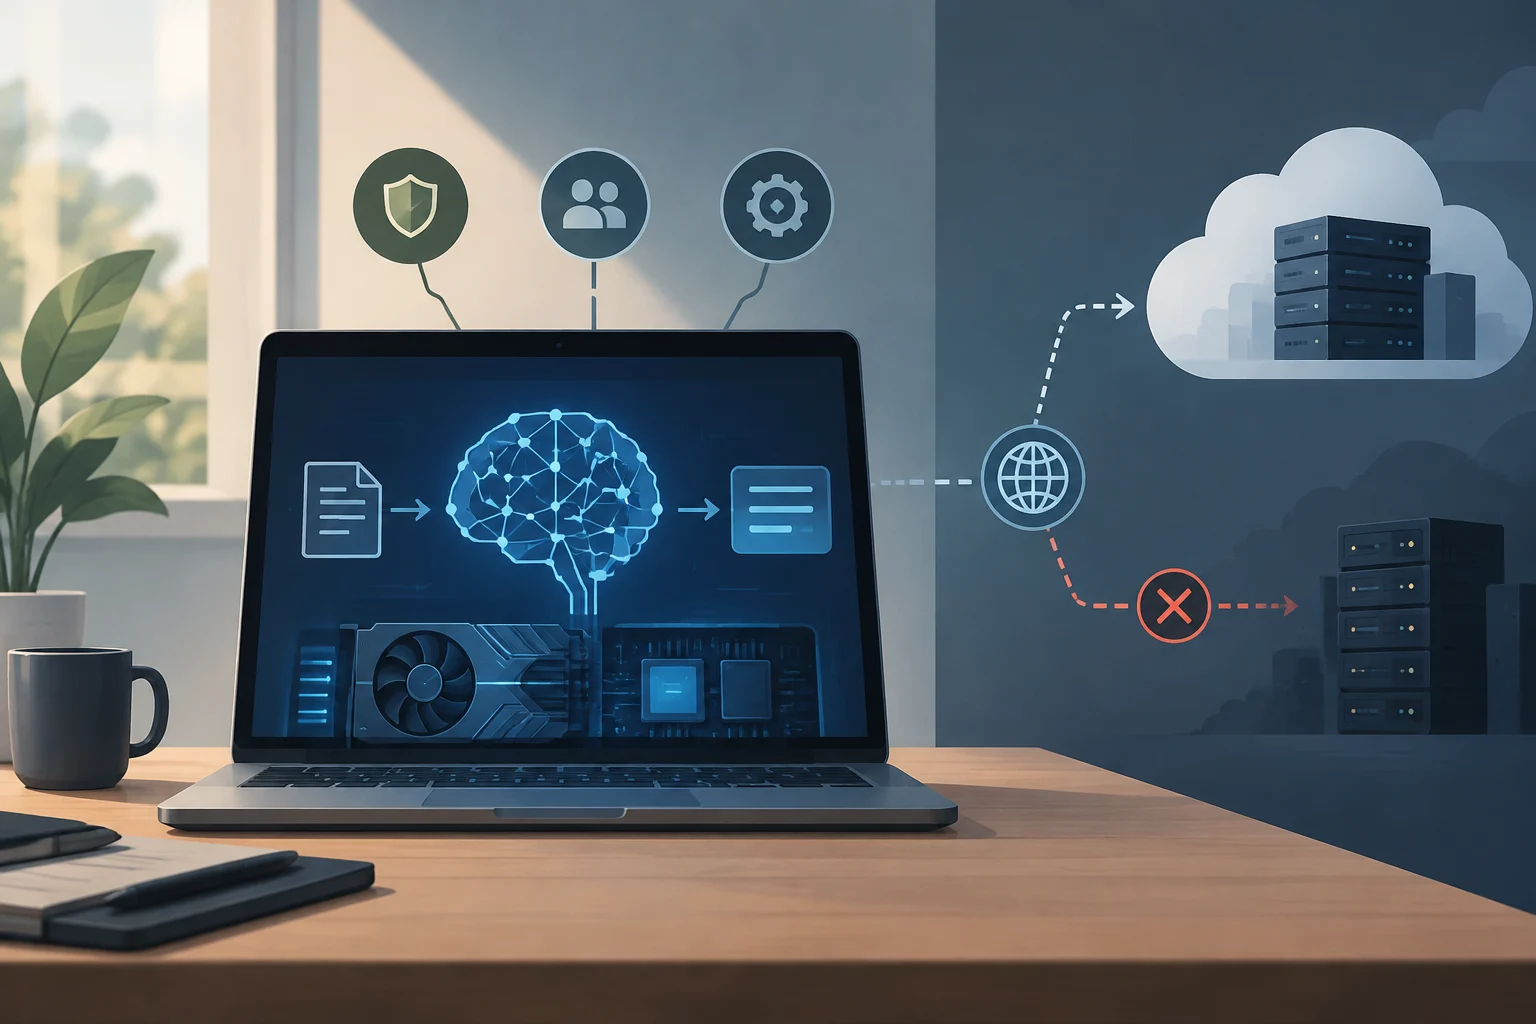
Gli strumenti locali operano su livelli diversi. Un motore di inferenza esegue le operazioni del modello; un’applicazione desktop può aggiungere catalogo, interfaccia di conversazione e controlli; un server locale offre un’interfaccia attraverso cui altre applicazioni inviano richieste. Prima di scegliere, è utile distinguere queste funzioni e verificare formati, acceleratori e sistemi operativi supportati da ciascuna opzione.
Microsoft documenta Foundry Local come strumento per scaricare ed eseguire modelli compatibili su dispositivi Windows usando l’accelerazione hardware disponibile, con strumenti da riga di comando e SDK per l’integrazione nelle applicazioni. La documentazione di Azure Local descrive, nel contesto di una distribuzione Kubernetes, la gestione del ciclo di vita dei modelli e degli endpoint. Non esiste un’unica configurazione valida per tutti: requisiti e modalità di gestione dipendono dal prodotto e dall’ambiente.
Prima di adottare Ollama o LM Studio in un progetto, controlla nella documentazione ufficiale di ciascuno strumento quali sistemi operativi, formati di modello, acceleratori e interfacce locali sono supportati e quali condizioni di licenza si applicano. La compatibilità dipende dallo specifico strumento, modello e ambiente.
Una prima valutazione può seguire questi passaggi concreti:
- Definisci il compito e i dati che riceverà il modello.
- Scegli un modello la cui licenza e capacità siano adatte all’uso previsto.
- Controlla dimensioni, formato e requisiti di memoria pubblicati.
- Installa un motore compatibile con il sistema e l’hardware disponibili.
- Valuta qualità, velocità, consumo e stabilità con input rappresentativi.
- Decidi come proteggere il punto di accesso, i registri e gli aggiornamenti.
Una risposta generata non dimostra da sola che la distribuzione sia adeguata: occorre valutare anche errori, privacy e manutenzione.
Quando scegliere l’inferenza locale e quando un approccio ibrido
L’inferenza locale è adatta quando la connettività non è garantita, quando è utile elaborare i dati vicino al luogo in cui vengono generati o quando una politica aziendale richiede che alcuni contenuti rimangano in un ambiente controllato. Una fotocamera che rileva un’anomalia e invia soltanto un avviso è un esempio di elaborazione vicino alla fonte; un riepilogo di documenti interni può esserlo a sua volta, purché applicazione, modello e archiviazione restino entro i limiti definiti dall’organizzazione.
Il cloud può essere più indicato se serve un modello o una capacità che l’hardware disponibile non può offrire, se la domanda è variabile o se il team non ha tempo per gestire i modelli. Per un’applicazione usata su molti dispositivi, può anche semplificare la distribuzione centralizzata, pur aggiungendo dipendenza dalla rete, condizioni del fornitore e gestione dei dati trasmessi.
Un approccio ibrido assegna i compiti in base a disponibilità, sensibilità o complessità: prima si prova un modello locale e si ricorre a un servizio remoto quando il compito lo richiede. Google documenta per Android modalità di instradamento che possono privilegiare il dispositivo, il cloud o limitarsi a uno dei due ambienti. La procedura di ripiego deve essere esplicita: se una richiesta sensibile può uscire dal dispositivo, l’applicazione deve informare l’utente e rispettare la politica stabilita.
Per decidere, confronta queste domande:
- Quali dati vengono inseriti e possono uscire dall’ambiente locale?
- Quale qualità e quale tempo di risposta richiede il compito?
- Il modello entra agevolmente nella memoria disponibile?
- Chi mantiene software, modelli e controlli di accesso?
- Come varia il costo in base all’uso e all’hardware già disponibile?
- Che cosa deve accadere se il modello locale non è disponibile?
La risposta può cambiare da un compito all’altro: non è necessario imporre una sola architettura a tutte le funzioni di un’applicazione. Un modello locale può svolgere attività ordinarie o sensibili, mentre un’API remota può gestire richieste che superano le sue capacità, se l’utente e la politica consentono il trasferimento.