Calculer la taille des poids
Une première estimation part du nombre de paramètres et de l’espace occupé par chacun. La formule approximative est paramètres × bits par paramètre ÷ 8 ; le résultat est exprimé en octets, et non en mémoire totale nécessaire à l’exécution du modèle. Par exemple, 7 milliards de paramètres stockés sur 32 bits correspondent à environ 28 Go décimaux de poids. Sur 16 bits, l’estimation tombe à environ 14 Go.
Ces chiffres décrivent les poids statiques et n’incluent ni le KV cache, ni les buffers d’exécution, ni la mémoire nécessaire au système d’exploitation et aux autres applications. Par conséquent, la taille d’un fichier de modèle ne garantit pas que l’ordinateur dispose d’assez de mémoire pour le charger et générer du texte. La demande finale dépend également de la configuration et de la méthode d’exécution.
La quantification réduit la mémoire occupée par les poids en les stockant avec une précision moindre, par exemple en int8 ou int4, tout en cherchant à préserver autant que possible la précision des résultats. À titre de référence arithmétique, 7 milliards de valeurs sur quatre bits correspondraient à environ 3,5 Go décimaux, avant prise en compte des métadonnées et autres coûts. Ce chiffre ne mesure exactement ni la taille du fichier ni la mémoire nécessaire à l’exécution : les méthodes et leurs exigences varient selon le modèle, le matériel et l’implémentation.
La réduction de précision peut impliquer un compromis sur la qualité. Hugging Face décrit différentes méthodes de quantification, avec leurs avantages et leurs inconvénients, et souligne que le choix approprié dépend du cas d’usage. Ne partez pas du principe que tous les modèles ou toutes les tâches tolèrent aussi bien la même quantification ; il est utile de tester le format concerné sur les tâches importantes.
Contexte et KV cache
Pendant la génération, le KV cache conserve des informations d’attention sur les tokens traités. Sa consommation ne se déduit pas uniquement de la taille des poids : elle dépend de l’architecture et de la configuration, et augmente lorsqu’un contexte plus long est traité. Ainsi, deux exécutions du même modèle peuvent nécessiter des quantités de mémoire différentes si elles utilisent des longueurs de contexte distinctes.
Ollama indique que sa fenêtre de contexte par défaut est de 4096 tokens et documente différentes façons de la modifier. La valeur par défaut du serveur peut être définie avec OLLAMA_CONTEXT_LENGTH ; avec ollama run, la documentation montre /set parameter num_ctx 4096, et pour l’API, le paramètre num_ctx. La valeur appropriée dépend de la tâche : augmenter le contexte peut permettre de traiter davantage de contenu, mais aussi accroître les besoins en mémoire.
Ollama permet également de sélectionner le type de quantification du KV cache avec OLLAMA_KV_CACHE_TYPE. Sa documentation précise que cette option nécessite l’activation de Flash Attention et que la valeur par défaut du cache est f16. q8_0 utilise environ deux fois moins de mémoire que f16, avec une perte de précision décrite comme très faible ; q4_0 en utilise environ un quart, avec une perte faible à moyenne qui peut être plus visible dans les contextes longs. L’effet sur la qualité dépend du modèle et de la tâche.
Il n’existe pas de valeur unique de mémoire pour le KV cache qui s’applique à tous les modèles. Avant de dimensionner un système, identifiez le modèle, le contexte prévu et la configuration du cache, puis vérifiez la consommation sur la machine concernée. Les estimations approximatives des poids ne remplacent pas cette vérification.
Additionner la mémoire sans confondre estimation et exigence
Pour planifier, prenez en compte poids + KV cache + mémoire d’exécution. La taille des poids peut être estimée avec la formule précédente, mais les sources disponibles ne donnent ni valeur universelle pour les buffers ni règle générale permettant de convertir cette somme en RAM ou VRAM requise. Le total observé dépend de l’implémentation, du backend, du modèle et de la configuration.
Un tableau permet de distinguer ce qui peut être calculé de ce qu’il convient de mesurer :
| Composant | Ce que l’on peut estimer | Ce qu’il faut vérifier |
|---|---|---|
| Poids | Paramètres × bits par paramètre ÷ 8, à titre approximatif | Taille du modèle et format de quantification |
| KV cache | Varie avec le contexte et la configuration | Utilisation mémoire avec le contexte prévu |
| Mémoire d’exécution | Aucune valeur universelle dans les sources disponibles | Consommation réelle du runtime et marge disponible |
| RAM et VRAM | Dépendent de l’emplacement de chargement du modèle | Répartition indiquée par l’outil utilisé |
En pratique, évitez de considérer le calcul des poids comme un minimum garanti. Prévoyez de la marge pour le système et les autres applications, et mesurez une exécution réelle avant d’augmenter le contexte ou de lancer davantage de tâches en parallèle. Ollama indique que les requêtes parallèles peuvent multiplier le contexte effectif et l’allocation mémoire supplémentaire ; l’effet concret dépend des réglages et de la mémoire disponible.
RAM, VRAM et répartition du modèle
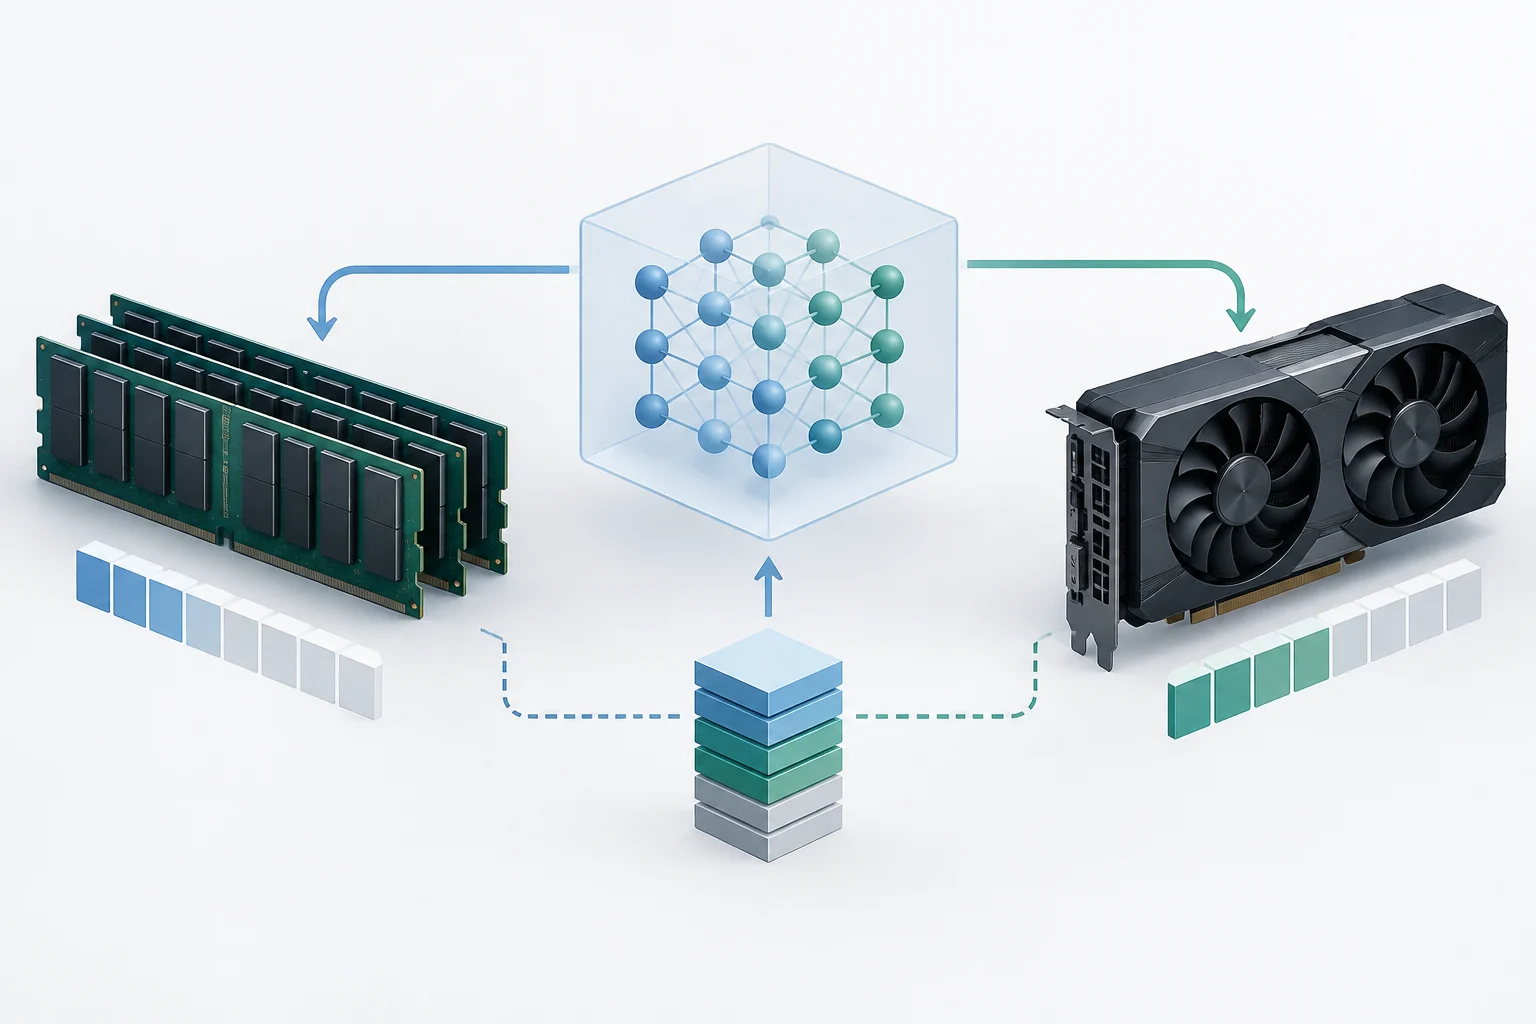
La RAM système et la VRAM du GPU sont des ressources distinctes. Selon le runtime, le matériel et la mémoire disponible, un modèle peut être chargé dans l’une d’elles ou réparti entre les deux. La seule taille des poids ne permet pas de conclure que l’exécution utilisera exclusivement le GPU ni qu’elle sera plus rapide sur toutes les machines.
Pour vérifier l’emplacement dans Ollama, exécutez ollama ps et consultez la colonne PROCESSOR. Selon sa documentation, 100% GPU signifie que le modèle a été entièrement chargé sur le GPU ; 100% CPU, qu’il a été chargé dans la mémoire système ; et une indication telle que 48%\/52% CPU\/GPU, qu’il a été réparti entre les deux. Interprétez cette sortie comme une description du chargement, et non comme une mesure de vitesse.
Dans llama.cpp, le guide de performances indique qu’avant le début de l’inférence, la sortie de diagnostic peut montrer si cuBLAS décharge du travail sur le GPU. Parmi les exemples documentés figurent des lignes indiquant les couches envoyées au GPU et la VRAM utilisée. Lorsque ces messages apparaissent, le guide précise que le GPU est utilisé ; la quantité dépend de l’exécution et ne doit pas être considérée comme une exigence générale.
Ollama explique qu’au chargement d’un modèle, il évalue la VRAM disponible : si le modèle tient entièrement sur un GPU, il le charge à cet endroit ; s’il ne tient pas sur un seul GPU, il peut le répartir entre les GPU disponibles. La documentation associe, lorsque c’est possible, le chargement sur un seul GPU à une réduction des transferts sur le bus PCI. La répartition effective doit être vérifiée pour chaque configuration.
Vérifier l’utilisation et ajuster la configuration
Commencez par calculer une valeur de référence pour les poids et notez le contexte ainsi que le type de quantification envisagés. Chargez ensuite le modèle et consultez ollama ps pour vérifier sa taille et la colonne du processeur. Si vous utilisez llama.cpp avec CUDA, examinez les messages de diagnostic au démarrage pour savoir si des couches sont déchargées vers le GPU et quelle quantité de VRAM est signalée comme utilisée.
Sur les systèmes NVIDIA, nvidia-smi peut aider à observer la VRAM occupée. Cette lecture et les outils du runtime reflètent une exécution particulière ; ne transformez pas une mesure ponctuelle en valeur universelle pour d’autres modèles, contextes ou machines. Si la consommation approche la mémoire disponible, réduisez d’abord le contexte ou examinez le type de cache et la quantification des poids, puis mesurez à nouveau.
Pour le contexte d’Ollama, modifiez OLLAMA_CONTEXT_LENGTH ou utilisez num_ctx par l’interface correspondante, selon la méthode documentée pour le serveur, l’exécution en ligne de commande ou l’API. Pour quantifier le KV cache, définissez OLLAMA_KV_CACHE_TYPE et vérifiez que Flash Attention est activée. Envisagez q8_0 si vous souhaitez réduire la mémoire avec une perte de précision décrite comme très faible ; évaluez q4_0 avec davantage de prudence, surtout dans les contextes longs.
Dans llama.cpp, l’option -t N contrôle le nombre de threads. Le guide recommande d’éviter une valeur trop élevée si le processeur est surchargé et propose d’essayer moins de threads pour diagnostiquer une génération lente. Ce n’est ni un réglage de mémoire ni une amélioration garantie : le résultat dépend de la machine et de la charge.
Routine pratique avant l’exécution
Pour dimensionner la mémoire en limitant les surprises, procédez dans cet ordre : identifiez le nombre de paramètres et la précision des poids ; calculez leur taille approximative ; fixez un contexte réaliste ; choisissez un type de cache si votre configuration le permet ; et gardez une marge pour le système et les autres processus. Exécutez ensuite le modèle et comparez l’estimation aux mesures disponibles.
Si l’exécution ne tient pas dans la mémoire prévue, ne modifiez qu’une variable à la fois : essayez un contexte plus court, une autre quantification des poids ou, lorsqu’elle est activée, une quantification du KV cache. Notez la consommation observée avec le modèle et la configuration afin de rendre la comparaison utile. La meilleure estimation est celle qui a été validée sur la machine cible, et non une valeur isolée calculée à partir du seul nombre de paramètres.
L’essentiel est de distinguer trois éléments : le poids des paramètres, la mémoire ajoutée par l’exécution et l’emplacement de chaque partie. Le premier chiffre peut être approché par une formule simple ; les autres nécessitent de tenir compte du contexte et de vérifier le comportement du runtime. Cela évite de confondre la taille d’un modèle avec la mémoire totale nécessaire à son utilisation.