Que signifie l’inférence locale ?
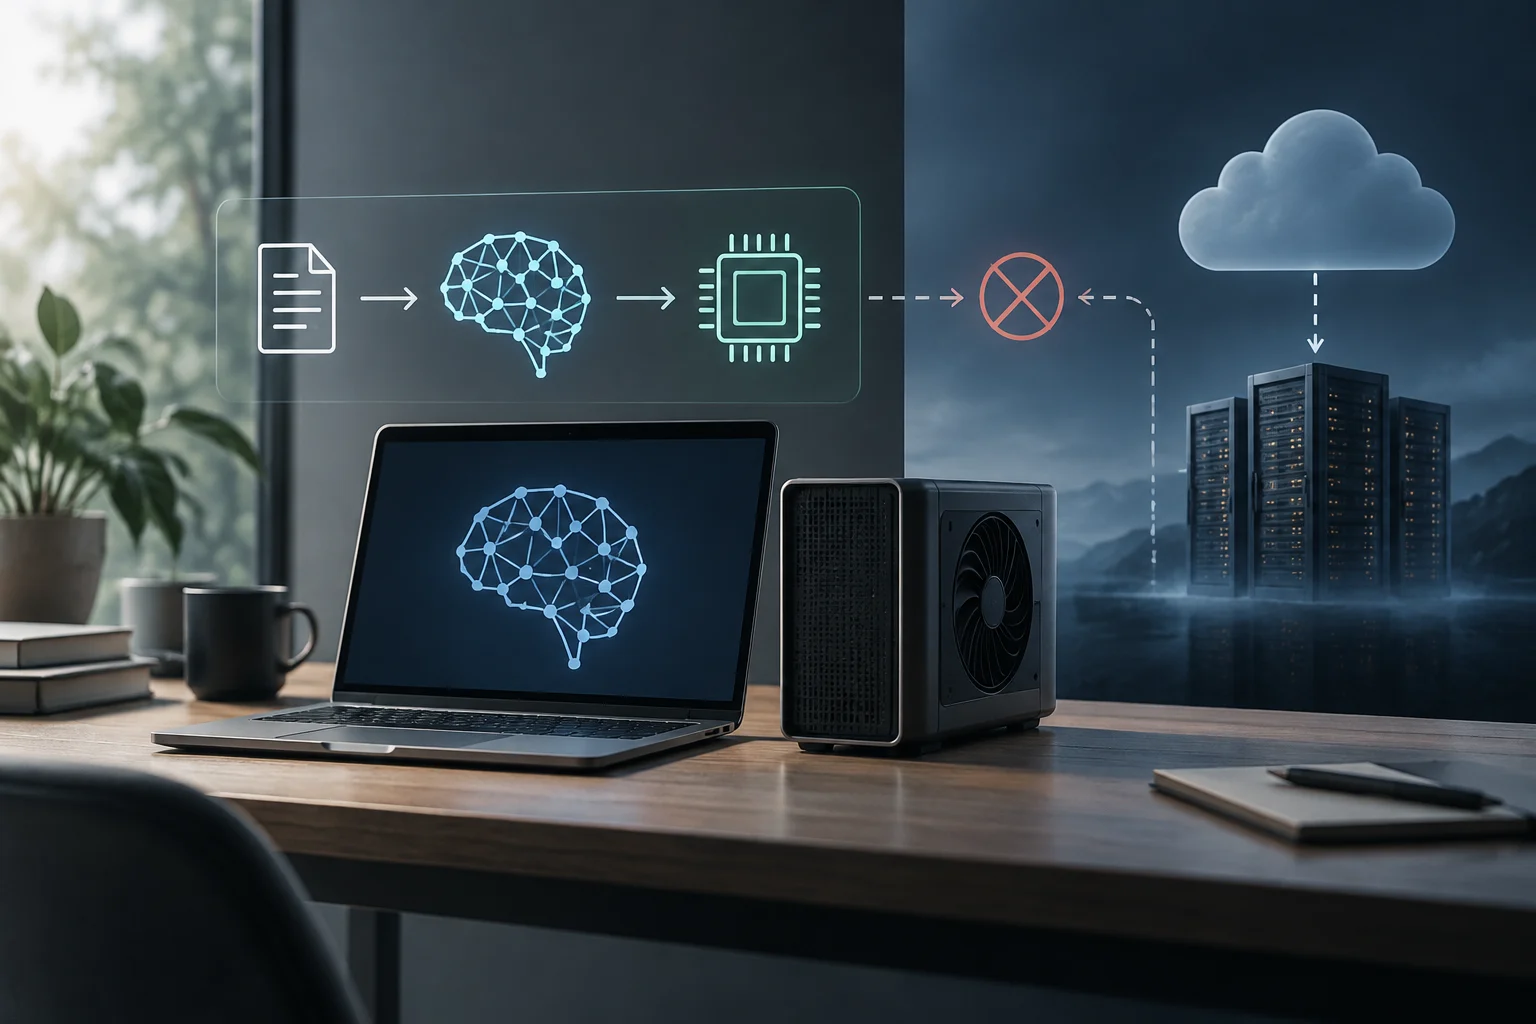
L’inférence locale consiste à exécuter un modèle d’intelligence artificielle sur l’appareil de l’utilisateur ou sur une infrastructure contrôlée par son organisation. Le modèle a déjà été entraîné : il reçoit une entrée, calcule une réponse et la renvoie. Un assistant textuel peut, par exemple, générer la suite d’un texte ; une caméra peut classer une image.
Le mot local désigne l’endroit où le calcul est effectué, pas l’identité du créateur du modèle ni la manière dont on l’a obtenu. Un modèle à poids ouverts téléchargé depuis un dépôt peut fonctionner sur un ordinateur personnel ; un modèle distribué par un fournisseur peut aussi y être exécuté. L’essentiel est que la requête soit traitée sur l’appareil ou dans l’environnement local, plutôt que transmise à un service distant pour produire la réponse.
Il ne faut pas confondre inférence et entraînement. L’entraînement ajuste les paramètres du modèle à partir de données ; l’inférence utilise un modèle préparé pour produire un résultat à partir d’une nouvelle entrée. L’inférence peut comprendre d’autres opérations, comme la recherche de documents ou l’appel à un outil, sans que ces tâches changent le sens fondamental du terme.
Le parcours d’une requête
Dans une application locale, on commence par choisir un modèle compatible et charger ses fichiers dans le stockage et la mémoire nécessaires. L’application prépare l’entrée — par exemple en convertissant une image dans la représentation attendue par un modèle de vision ou en transformant un texte en jetons — et le moteur d’exécution répartit les calculs entre le processeur, le GPU et les accélérateurs disponibles. L’application convertit ensuite la sortie interne en texte, étiquettes, scores ou autre résultat exploitable.
Des données à la réponse
Dans un modèle de langage, le texte est découpé en jetons et traité avec le contexte pertinent. Le modèle calcule une distribution de jetons suivants possibles, puis la méthode de génération en sélectionne un ; le processus se répète jusqu’à la fin de la réponse. Le résultat dépend des poids, mais aussi de la configuration, du contexte et de la stratégie de génération. Le moteur d’inférence ne remplace pas le modèle : il fournit l’environnement qui charge et exécute ses opérations.
En vision par ordinateur, le traitement peut commencer par une image capturée par une caméra. Le programme l’adapte à la taille et au format d’entrée requis, exécute le modèle, puis convertit ses tenseurs de sortie en objets détectés, catégories ou coordonnées. Dans un système de périphérie, comme une caméra ou un équipement industriel, l’appareil peut ensuite envoyer une alerte ou un résumé au lieu de transmettre en continu les données originales. Cette conception peut économiser de la bande passante, mais cela dépend de l’application et des autres canaux qu’elle utilise éventuellement.
GPU, VRAM et RAM : les ressources qui limitent le modèle
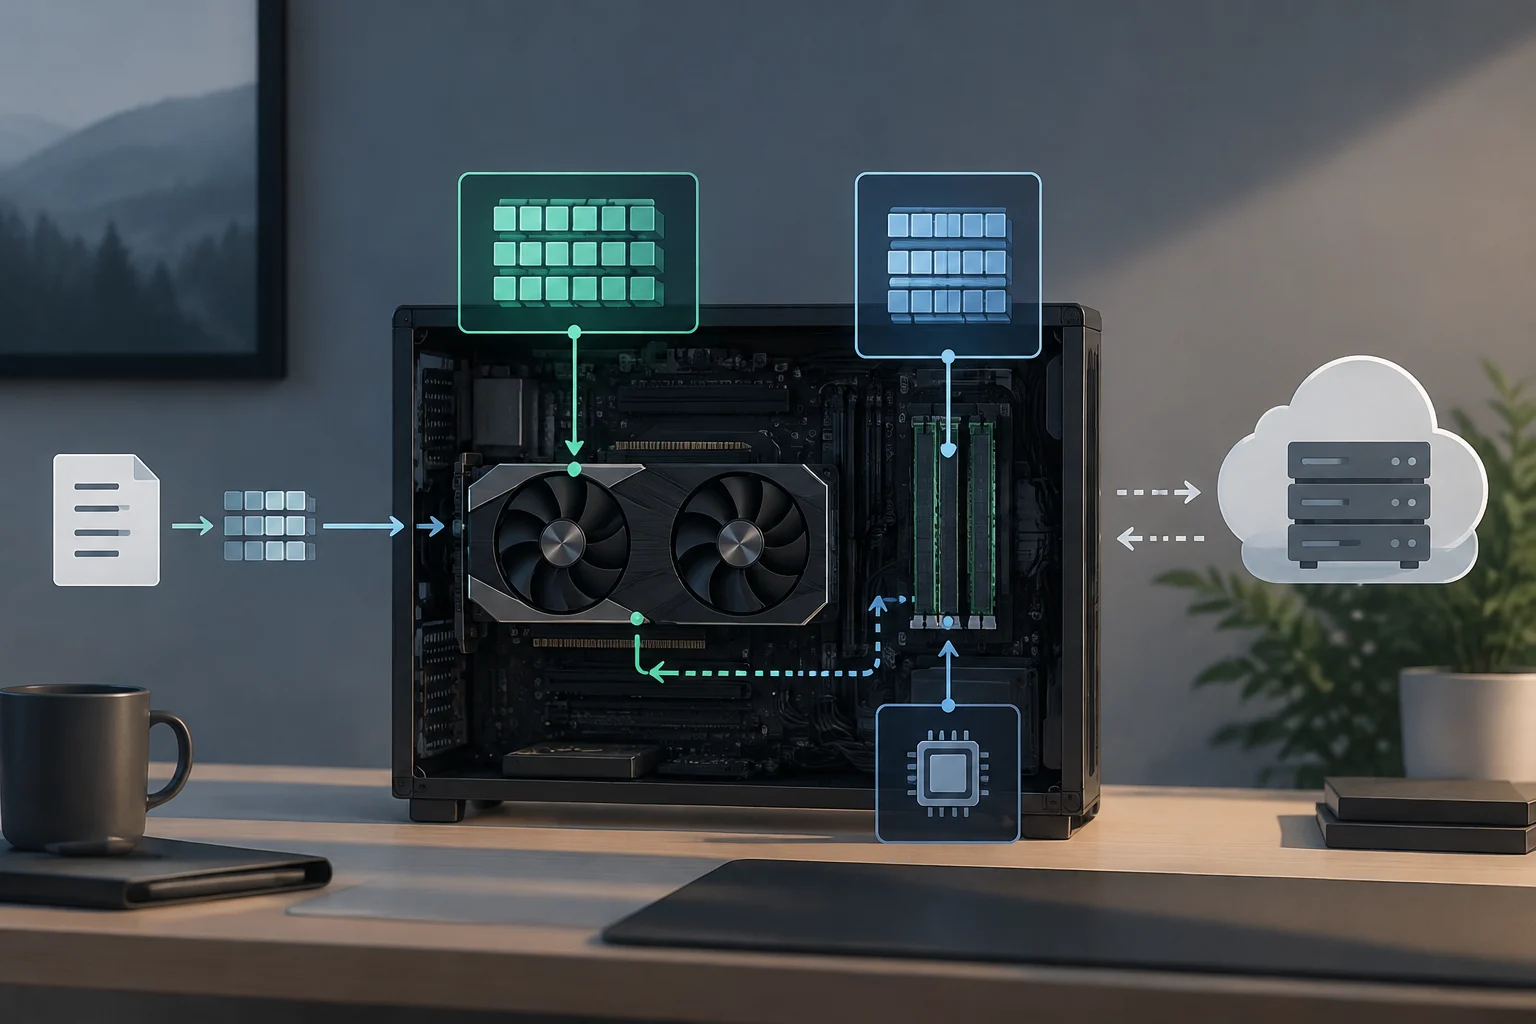
La faisabilité dépend de la capacité à faire tenir le modèle et les données de travail dans la mémoire disponible, ainsi que de la vitesse de calcul de l’appareil. Dans un GPU dédié, la VRAM stocke les poids et les autres données nécessaires à l’accélérateur. La RAM système héberge le processus, peut contenir une partie du modèle et permet l’exécution sur processeur ou une configuration où le modèle ne tient pas entièrement dans le GPU. Ces ressources ne sont pas interchangeables sans coût : les transferts entre mémoires peuvent réduire les performances.
Un GPU peut accélérer les opérations parallèles courantes dans les réseaux neuronaux, mais il n’est pas toujours nécessaire. Un modèle peut fonctionner sur processeur si le logiciel et le format le permettent ; l’exécution sera souvent plus lente, mais pas nécessairement impossible. Certains appareils disposent aussi d’un NPU ou d’autres accélérateurs, utilisés seulement si le moteur d’exécution et le modèle les prennent en charge. La compatibilité de l’ensemble compte autant que le nom d’un composant : système d’exploitation, pilote, format du modèle et moteur doivent fonctionner de concert.
La taille du fichier du modèle donne une première indication, mais ne représente pas à elle seule toute la mémoire nécessaire pendant l’inférence. La précision ou la quantification des poids, la longueur du contexte, la taille des lots et la mémoire temporaire créée à l’exécution entrent aussi en compte. Pour un modèle de langage, un contexte plus long peut accroître la consommation mémoire ; mieux vaut donc garder une marge que dimensionner l’appareil exactement à la taille du téléchargement.
Un guide matériel de PromptQuorum donne une règle indicative pour certains modèles de langage quantifiés : environ 4–5 Go pour un modèle de 7 milliards de paramètres en Q4_K_M et environ 40 Go pour un modèle de 70 milliards de paramètres dans cette même quantification. Ces chiffres correspondent à une configuration particulière, et ne constituent ni des exigences universelles ni une garantie de vitesse : le format, le contexte et le moteur peuvent modifier la consommation réelle. Pour choisir un appareil, vérifiez la fiche du modèle et mesurez ses performances avec la charge prévue.
Local ou cloud : les différences qui influencent le choix
Avec l’inférence distante, l’application envoie une requête à un serveur par une API et reçoit la réponse sur le réseau. Le fournisseur gère le matériel du service ; l’utilisateur évite d’y installer et d’y maintenir le modèle, mais doit tenir compte de la connexion, des conditions du service et du traitement des données transmises. En local, l’organisation prend en charge le téléchargement, le déploiement, la compatibilité et la maintenance. Le calcul peut continuer sans connexion externe si l’application ne dépend pas d’autres services.
| Critère | Inférence locale | Inférence dans le cloud ou par API |
|---|---|---|
| Lieu du calcul | Appareil ou infrastructure locale | Serveurs distants du fournisseur ou de l’opérateur |
| Connexion pendant la requête | Peut fonctionner sans Internet si le modèle et l’application sont disponibles localement | La requête dépend de la connexion au service |
| Données d’entrée | Peuvent rester dans l’environnement local ; les autres composants de l’application restent à examiner | Transmises au service pour traitement, selon sa configuration |
| Ressources et exploitation | Le matériel propre limite la mémoire et la capacité ; l’utilisateur gère les modèles et les mises à jour | Le fournisseur apporte de la capacité et gère une partie de l’infrastructure |
| Coût | Matériel, électricité, stockage et maintenance : ce n’est pas gratuit pour autant | Peut être facturé selon l’usage ou la capacité, selon le service |
Le tableau résume des différences d’architecture ; il ne garantit pas la confidentialité, la rapidité ou le prix d’un service particulier. L’envoi d’une requête au cloud ne détermine pas à lui seul sa durée de conservation ni les personnes qui peuvent y accéder : cela dépend du fournisseur, de la configuration et du contrat.
La latence ne désigne pas automatiquement un gagnant. Le traitement local évite l’aller-retour réseau vers un serveur, ce qui peut être utile pour une application interactive ou un appareil dont la connexion est irrégulière. Mais un GPU distant puissant peut calculer plus vite qu’un appareil modeste, tandis qu’un grand modèle local peut prendre trop de temps pour l’usage visé. Il faut distinguer le temps de communication du temps de calcul et évaluer le parcours complet.
Le coût obéit à une logique similaire. Exécuter un modèle sur un appareil déjà disponible évite une facturation par requête si l’on n’utilise pas de service payant à l’usage, mais n’efface pas les coûts d’achat, d’énergie, d’assistance, de remplacement et de maintenance. Dans le cloud, les dépenses peuvent augmenter avec l’usage ; en contrepartie, on accède à des ressources qui ne sont pas installées sur chaque appareil. Il est utile de comparer le coût total pour une charge de travail et une période définies, sans assimiler « local » à gratuit ni « cloud » à plus cher.
Confidentialité, sécurité et limites pratiques
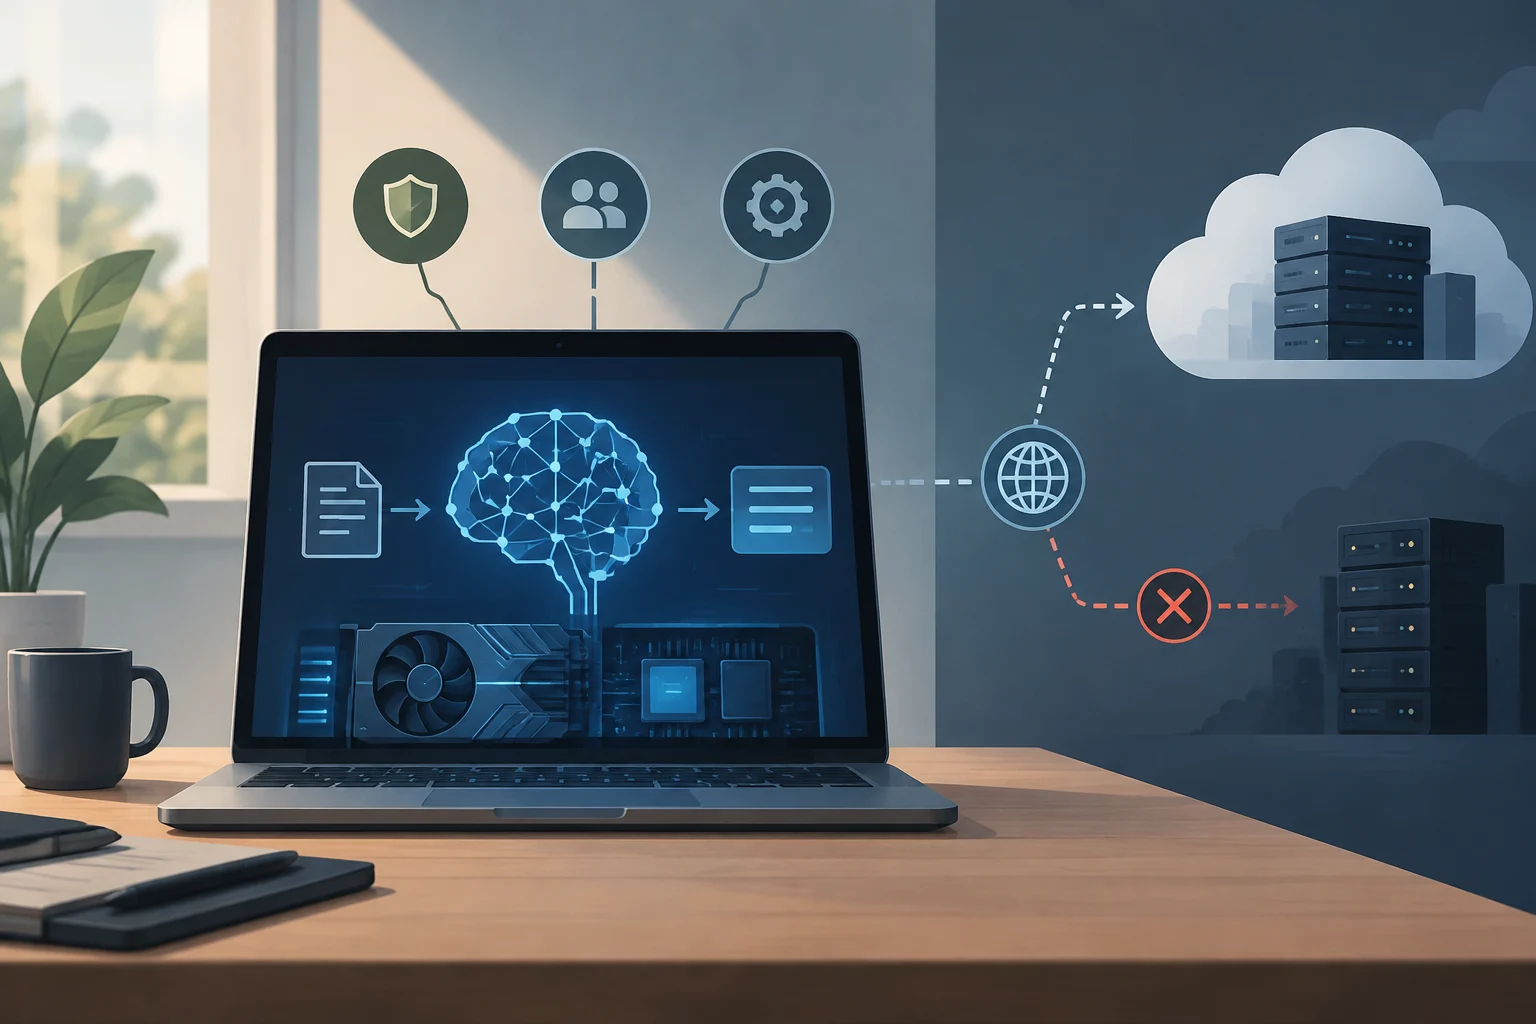
Le traitement local peut réduire la nécessité d’envoyer le contenu d’une requête à un fournisseur distant. Cela réduit une voie d’exposition, mais ne garantit pas à lui seul la confidentialité. Une application peut synchroniser des journaux, interroger un service externe ou envoyer de la télémétrie ; les autorisations du système, l’accès des autres utilisateurs et la protection de l’appareil restent également importants.
L’exécution locale transfère des responsabilités à l’équipe qui exploite l’appareil ou le service. Il faut maintenir le modèle et le logiciel à jour, contrôler l’accès au service local et examiner l’origine des modèles ainsi que leurs conditions d’utilisation. Dans une organisation, installer un logiciel sur ses propres serveurs ne signifie pas automatiquement que les données sont isolées : le réseau, les identifiants, les journaux, les sauvegardes et la configuration de chaque composant comptent aussi.
En matière de capacité, le matériel local fixe généralement une limite pratique à la taille et à la complexité du modèle, au contexte traité et au nombre de requêtes simultanées. Un modèle plus petit peut convenir à une tâche bien délimitée, sans nécessairement égaler un système distant plus puissant pour toutes les tâches. La qualité dépend du modèle et du cas d’usage, pas seulement de son lieu d’exécution.
Il existe aussi des coûts d’exploitation absents d’une facturation au jeton : préparation de l’environnement, téléchargement des fichiers, résolution des incompatibilités, surveillance des ressources et distribution des mises à jour. La maintenance peut être simple sur un appareil individuel ; dans une flotte d’entreprise, elle devient une tâche de déploiement et d’assistance. L’inférence locale donne le contrôle de l’environnement, mais ce contrôle suppose un travail technique.
Moteurs d’exécution et outils
Les outils locaux interviennent à différents niveaux. Un moteur d’inférence exécute les opérations du modèle ; une application de bureau peut ajouter un catalogue, une interface de conversation et des commandes ; un serveur local fournit une interface permettant à d’autres applications d’envoyer des requêtes. Avant de choisir, distinguez ces fonctions et vérifiez les formats, accélérateurs et systèmes d’exploitation pris en charge.
Microsoft présente Foundry Local comme un outil permettant de télécharger et d’exécuter des modèles compatibles sur des appareils Windows, avec l’accélération matérielle disponible et des outils en ligne de commande ainsi que des SDK pour l’intégration dans des applications. La documentation d’Azure Local décrit, dans le contexte d’un déploiement Kubernetes, la gestion du cycle de vie des modèles et des points de terminaison. Il n’existe pas de configuration universelle unique : le produit et l’environnement déterminent les exigences et le mode d’administration.
Avant d’adopter Ollama ou LM Studio dans un projet, consultez la documentation officielle de chaque outil pour vérifier les systèmes d’exploitation, formats de modèle, accélérateurs, interfaces locales et conditions de licence applicables. La compatibilité dépend de l’outil, du modèle et de l’environnement concernés.
Une première évaluation peut suivre ces étapes concrètes :
- Définir la tâche et les données que recevra le modèle.
- Choisir un modèle dont la licence et les capacités correspondent à cet usage.
- Vérifier la taille, le format et les besoins mémoire publiés.
- Installer un moteur compatible avec le système et le matériel disponibles.
- Évaluer la qualité, la vitesse, la consommation et la stabilité sur des entrées représentatives.
- Décider comment protéger le point d’accès, les journaux et les mises à jour.
Une réponse générée ne suffit pas à prouver qu’un déploiement convient : il faut aussi évaluer les échecs, la confidentialité et la maintenance.
Quand choisir l’inférence locale ou une approche hybride
L’inférence locale convient lorsque la connexion n’est pas garantie, lorsqu’il est préférable de traiter les données près de leur lieu de production ou lorsqu’une politique organisationnelle impose de garder certains contenus dans un environnement contrôlé. Une caméra qui détecte une anomalie et n’envoie qu’une alerte illustre le traitement proche de la source ; le résumé de documents internes peut en être un autre exemple, si l’application, le modèle et le stockage respectent les limites définies par l’organisation.
Le cloud peut être plus adapté si la tâche exige un modèle ou une capacité que le matériel disponible ne peut pas fournir, si la demande devrait varier ou si l’équipe ne dispose pas du temps nécessaire pour exploiter les modèles. Pour une application utilisée sur de nombreux appareils, il peut aussi simplifier le déploiement centralisé, tout en ajoutant une dépendance au réseau, des conditions imposées par le fournisseur et la gestion des données transmises.
Une approche hybride répartit les tâches selon la disponibilité, la sensibilité ou la complexité : on essaie d’abord un modèle local et on fait appel à un service distant lorsque la tâche le nécessite. Google documente sur Android des modes de routage permettant de privilégier l’appareil, de privilégier le cloud ou de se limiter à l’un des deux environnements. Le mécanisme de repli doit être explicite : si une requête sensible risque de quitter l’appareil, l’application doit en informer l’utilisateur et respecter la politique établie.
Pour décider, comparez les questions suivantes :
- Quelles données sont traitées et peuvent-elles quitter l’environnement local ?
- Quel niveau de qualité et quel délai de réponse la tâche exige-t-elle ?
- Le modèle tiendra-t-il avec une marge suffisante dans la mémoire disponible ?
- Qui maintiendra le logiciel, les modèles et les contrôles d’accès ?
- Comment le coût évolue-t-il avec l’usage et le matériel déjà disponible ?
- Que doit-il se passer si le modèle local n’est pas disponible ?
La réponse peut varier d’une tâche à l’autre : il n’est pas nécessaire d’imposer une architecture unique à toutes les fonctions d’une application. Un modèle local peut traiter des tâches courantes ou sensibles, tandis qu’une API distante prend en charge les requêtes qui dépassent ses capacités, à condition que l’utilisateur et la politique autorisent ce transfert.