Modelle und Daten: Welches System verwendest du?
Modell und Anwendung
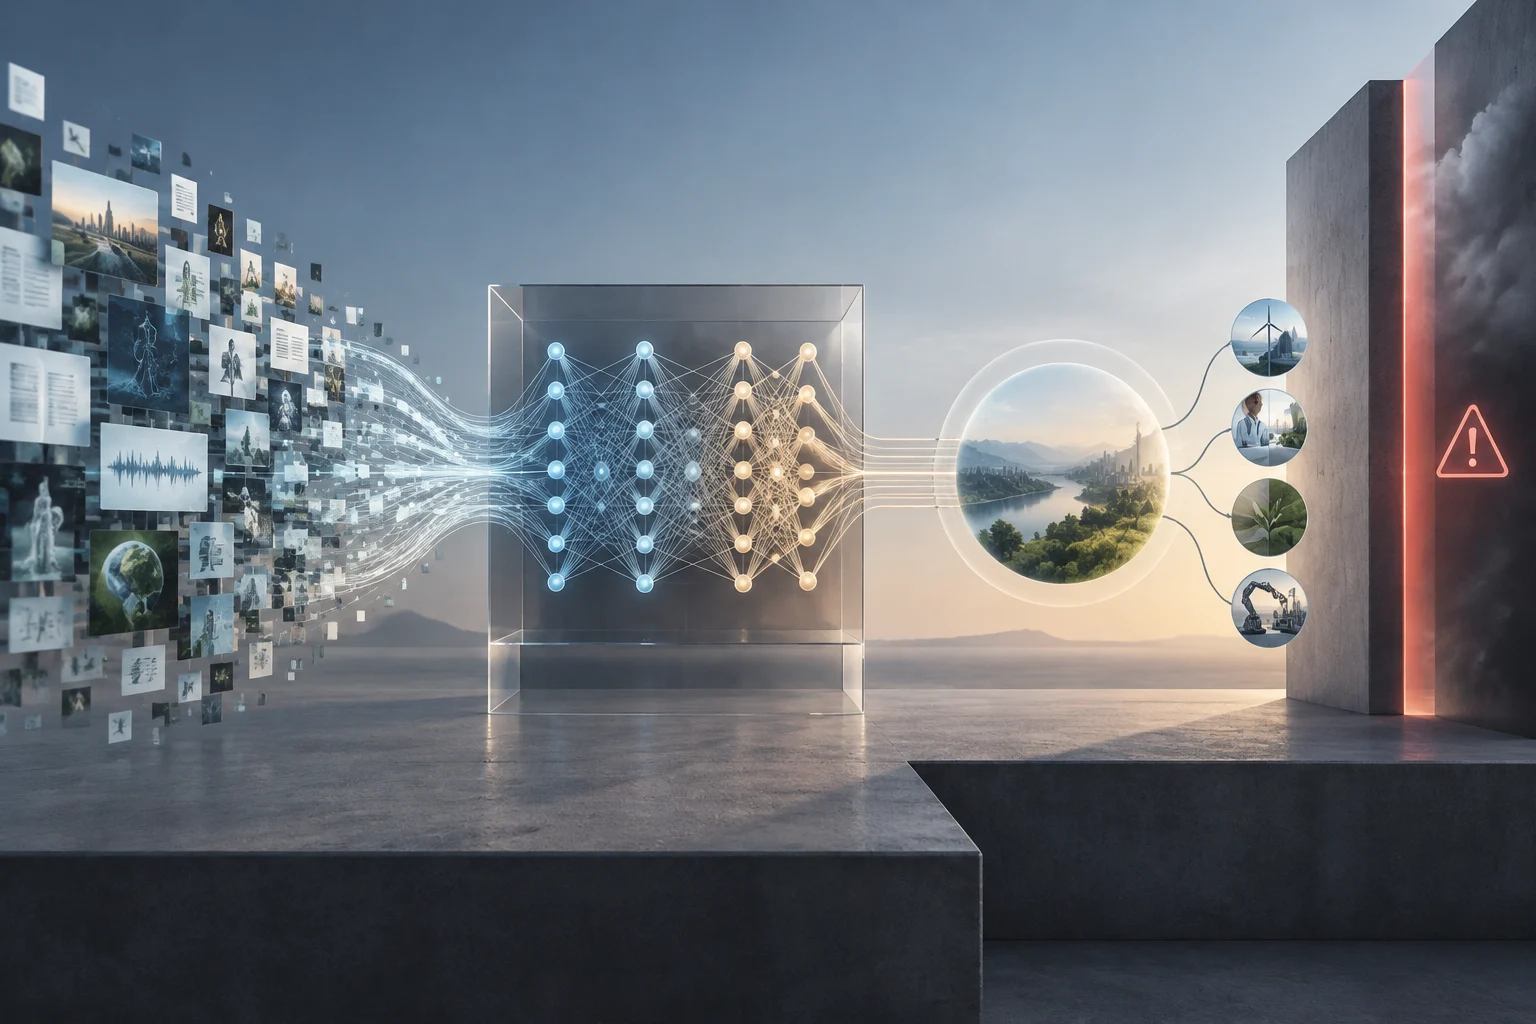
Ein maschinelles Lernmodell ist ein Computersystem, das mit Daten trainiert wurde, um Vorhersagen zu treffen oder Inhalte zu erzeugen. Es ist keine Hardwarekomponente, sondern das System, das diese Aufgaben ausführt.
Parameter und Trainingsdaten
Parameter sind numerische Werte, die zu einem maschinellen Lernmodell gehören. Bei Sprachmodellen nutzt das System diese Werte, um Wahrscheinlichkeiten für Folgen von Tokens zu schätzen und Vorhersagen oder Text auszugeben.
Ein Modell kann dank statistischer Muster, die es gelernt hat, schlüssige Antworten erzeugen. Das beweist jedoch weder Bewusstsein noch menschliches Verständnis. Überzeugendes Sprachverhalten ist von belegtem Wissen zu unterscheiden: Auch eine gut formulierte Antwort kann Fehler enthalten.
Training, Inferenz und Feinabstimmung
Training und Inferenz
Beim Training wird ein Modell anhand von Daten angepasst. Bei der Inferenz erzeugt ein bereits trainiertes Modell auf Grundlage einer Eingabe eine Ausgabe oder Vorhersage. Wer einem Chatbot eine Frage stellt, nutzt das Modell, um eine Antwort zu erhalten; eine Feinabstimmung erfordert dagegen zusätzliches Training.
Was bedeutet Feinabstimmung?
Die Feinabstimmung (Fine-Tuning) ist zusätzliches Training, das ein Modell an eine bestimmte Aufgabe oder Datenart anpasst. Sie ist nicht dasselbe wie eine Anweisung im Gespräch. „Fasse diesen Text zusammen“ verändert die Anfrage an das System; Anweisungen können die Ausgabe beeinflussen, ohne die Modellparameter zu ändern.
Diese Unterscheidung ist auch für den Datenschutz wichtig: Inferenz beschreibt, wie eine Ausgabe entsteht, nicht, was der Anbieter anschließend mit den übermittelten Daten macht. Nutzung bei der Anfrage und spätere Verarbeitung sind verschiedene Fragen; ob Eingaben oder Protokolle gespeichert werden, hängt von den Bedingungen, Einstellungen und Datenschutzregeln des jeweiligen Dienstes ab.
LLMs, Tokens, Kontext und Gedächtnis
LLM und Tokenizer
LLM steht für Large Language Model, auf Deutsch großes Sprachmodell: ein Modell, das Wahrscheinlichkeiten für Tokens oder Tokenfolgen schätzt und zur Texterzeugung verwendet werden kann. Ein Token kann je nach Segmentierungsmethode ein Wort, ein Wortteil oder ein Zeichen sein. Der Tokenizer zerlegt Text in Tokens und wandelt sie anschließend in numerische Kennungen um, die das Modell verarbeiten kann. Token, Wort und Zeichen sind nicht allgemein gleichzusetzen; die Segmentierung unterscheidet sich auch je nach Sprache.
Kontextfenster und Gedächtnis
Das Kontextfenster ist die begrenzte Menge an Tokens, die ein Sprachmodell bei der Erzeugung einer Ausgabe erhält. Sie kann Anweisungen, den Gesprächsverlauf, Werkzeuge und externe Daten umfassen. Kontextverwaltung bedeutet, gezielt auszuwählen, welche Informationen dem Modell bereitgestellt werden; bei sehr langen Kontexten kann die Fähigkeit, Angaben genau abzurufen, nachlassen.
Ein Gedächtnis kann eine zusätzliche Funktion eines Modells oder des Systems sein, das es einsetzt, ebenso wie Werkzeuge oder Informationsabruf. Aktueller Kontext ist kein dauerhaftes Erinnerungsvermögen, und Informationen abzurufen ist nicht dasselbe wie ein Modell erneut zu trainieren.
Prompt: eine Aufgabe mit Kontext formulieren
Ein Prompt ist eine Eingabe, die Anweisungen und Beispiele enthalten kann, um die Antwort eines Modells zu lenken. Ein Beispiel: „Fasse diesen fiktiven Text in drei Stichpunkten zusammen und nenne, welche Angabe ungeklärt bleibt.“ Das ist eine Möglichkeit, die Ausgabe anzupassen, aber keine Garantie für ein korrektes Ergebnis.
Anweisungen präzisieren die Aufgabe und lenken die Antwort, garantieren aber nicht deren Richtigkeit. Beispiele können außerdem zeigen, welche Art von Ausgabe erwartet wird. Die Qualität hängt davon ab, wie der Kontext aufgebaut ist und wie gut das Modell die Aufgabe bewältigt.
Embeddings, semantische Suche und RAG
Embeddings und semantische Suche
Ein Embedding ist eine numerische Darstellung von Daten. Bei der semantischen Suche können Embeddings Inhalte so abbilden, dass sie anhand erlernter Beziehungen verglichen werden können, etwa nach der Ähnlichkeit von Konzepten.
RAG: erst abrufen, dann antworten
RAG steht für Retrieval-Augmented Generation, also generative Erzeugung mit Informationsabruf. Das System ruft Informationen aus einer externen Quelle ab und ergänzt damit den Kontext, den das Modell für die Antwort erhält. So können externe Daten einbezogen werden, ohne das Modell erneut zu trainieren. Für den Abruf kommen verschiedene Verfahren infrage, darunter semantische Suche.
RAG kann Dokumente in den Kontext einbringen, die dem Modell zuvor nicht vorlagen, ohne es neu zu trainieren oder seine Parameter zu ändern. Darin unterscheidet sich RAG vom Fine-Tuning. Ein abgerufener Text wird dadurch nicht automatisch richtig verstanden: Die Antwort kann ihn falsch zusammenfassen, eine Bedingung auslassen oder mit Informationen vermischen, die im Dokument nicht stehen. Es ist daher hilfreich, die Quelle und die relevante Textstelle zu prüfen.
Agenten, Werkzeuge und Arbeitsabläufe
Werkzeuge und Agenten
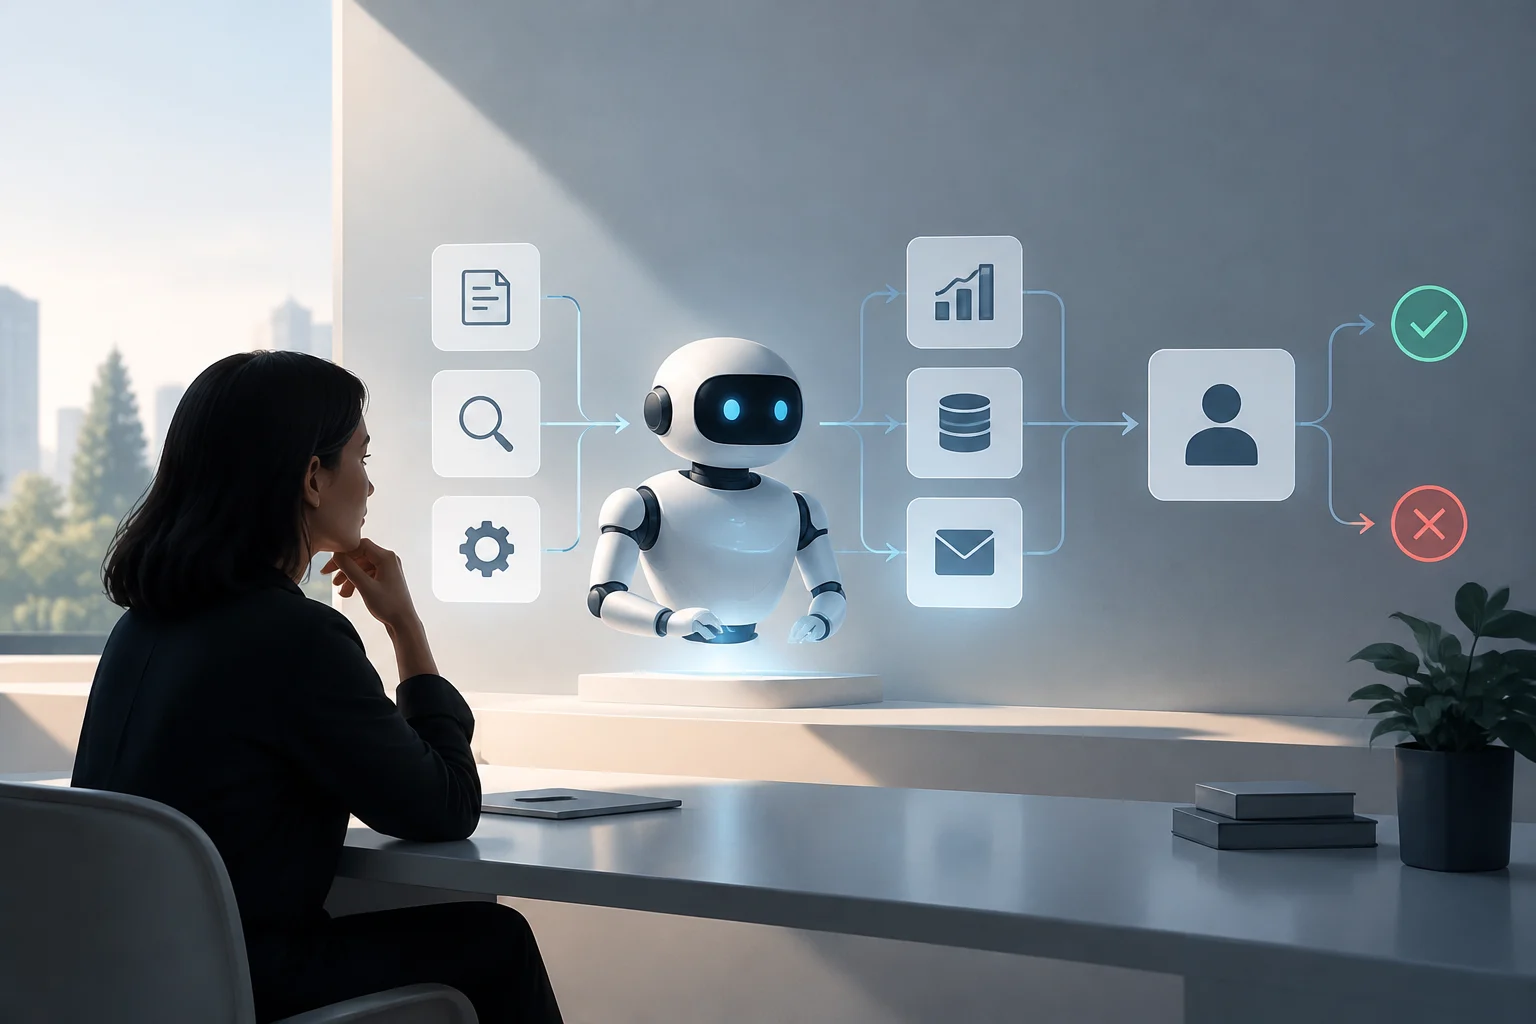
Ein Werkzeug erweitert die Fähigkeiten eines Modells, etwa indem es Informationen abrufen oder eine Aktion ausführen kann. Als Agent wird häufig ein System bezeichnet, in dem ein Modell seine Schritte und den Einsatz von Werkzeugen dynamisch steuert, um eine Aufgabe zu erledigen. Der Begriff wird auch für Systeme mit festgelegten Abläufen verwendet; seine Bedeutung hängt daher vom Kontext ab.
Arbeitsablauf und Autonomie
Ein Arbeitsablauf organisiert Modelle und Werkzeuge mit vorab festgelegten Schritten. Bei einem Agenten kann das Modell dynamisch entscheiden, welche Aktionen es ausführt und welche Werkzeuge es nutzt. Entscheidend ist, wer die Schritte festlegt; welche Aktionen möglich sind, hängt von den integrierten Werkzeugen und Berechtigungen ab.
Je mehr Handlungsmöglichkeiten ein System hat, desto wichtiger sind die Prüfung seiner Berechtigungen und geeignete Kontrollpunkte. Bei sensiblen Vorgängen sollte der Zugriff auf Konten und Daten begrenzt und vor dem Senden, Veröffentlichen, Kaufen oder Löschen eine Bestätigung verlangt werden. Ein Agent kann Fehler machen oder sie weitertragen; die Bezeichnung belegt weder zuverlässige Autonomie noch macht sie Aufsicht überflüssig.
Generative KI und multimodale Systeme
Generative KI erzeugt Inhalte – etwa Text, Bilder, Audio oder Video – auf Grundlage erlernter Muster und einer Eingabe. Andere Systeme des maschinellen Lernens können sich darauf konzentrieren, etwas zu klassifizieren oder einen Wert vorherzusagen, zum Beispiel die Zugehörigkeit eines Bildes zu einer Kategorie.
Ein multimodales System kann mehr als eine Inhaltsart verarbeiten, zum Beispiel Text und Bilder. Manche Modelle nehmen etwa ein Bild zusammen mit einer schriftlichen Frage entgegen. Welche Formate unterstützt werden, hängt vom Modell ab: Die Dokumentation zu Transformers beschreibt Modelle, die Text und Bilder verarbeiten, sowie einige, die auch Video unterstützen.
Multimodalität bedeutet weder automatisch mehrere Aufgaben noch einen automatischen Internetzugang. Ein System kann Bild und Text kombinieren, ohne mit dem Web verbunden zu sein; ein anderes kann mehrere Aufgaben ausschließlich mit Text erledigen. Um eine Funktion zu bewerten, solltest du prüfen, welche Formate sie annimmt und welche Ergebnisse oder externen Dienste sie nutzen kann.
Halluzinationen, Verzerrungen und Evaluation
Halluzination oder Konfabulation
Als Halluzination oder Konfabulation wird eine falsche oder fehlerhafte Antwort bezeichnet, die ein System überzeugend formuliert oder die durch den bereitgestellten Kontext nicht gestützt wird. Ein hypothetisches Beispiel wäre, eine Aussage einer nicht existierenden Quelle zuzuschreiben. Flüssige Sprache ist kein Beleg für Genauigkeit; wichtige Zitate, Namen, Daten und Behauptungen solltest du überprüfen.
Verzerrung, Evaluation und Benchmark
Eine Verzerrung ist eine systematische Tendenz, die Ausgaben oder deren Folgen beeinflussen kann. Bei KI-Systemen kann sie sich in Leistungsunterschieden zwischen Gruppen oder in Ergebnissen zeigen, die Verzerrungen aus den Trainingsdaten übernehmen. Deshalb reicht eine allgemeine Testfrage nicht aus: Wichtig ist, wie das System bei relevanten Fällen und Gruppen für den vorgesehenen Einsatz reagiert.
Ein Benchmark misst und vergleicht die Leistung von Modellen anhand von Kennzahlen für bestimmte Aufgaben oder Datensätze. Welche Kennzahlen passen, hängt von Aufgabe und Daten ab.
Um ein Tool zu bewerten, solltest du repräsentative Beispiele für deine Aufgabe verwenden und je nach Einsatz Genauigkeit, Fehler, Grenzen, Barrierefreiheit und Kosten prüfen. Unterscheide Messergebnisse eines Tests von der Leistung im Alltag: Ein Ergebnis beschreibt konkrete Bedingungen und garantiert keine vergleichbare Leistung in anderen Situationen. Keine einzelne Prüfung beseitigt alle Risiken.
Datenschutz, Daten, Urheberrecht und Lizenzen
Daten und Datenschutz
Inferenz beschreibt, wie ein Modell aus einer Eingabe eine Ausgabe erzeugt. Sie legt aber nicht fest, wie personenbezogene Daten verarbeitet werden. Prüfe vor der Weitergabe von Informationen, welche Daten der Dienst verlangt und welche Kontrollmöglichkeiten er bietet.
Als Vorsichtsmaßnahme solltest du personenbezogene oder sensible Daten weglassen, wenn sie nicht erforderlich sind, und beim Ausprobieren von Funktionen fiktive Beispiele verwenden.
Urheberrecht und Lizenz
Das US Copyright Office untersucht den Schutz KI-generierter Werke und die Rolle des menschlichen Beitrags. In seinem Bericht zu KI-generierten Ergebnissen befasst es sich mit menschlicher Urheberschaft und dem Umfang kreativer Kontrolle, die eine Person ausüben kann.
In den Vereinigten Staaten kommt das US Copyright Office zu dem Schluss, dass der Schutz KI-generierter Ergebnisse vom menschlichen Beitrag abhängt und im Einzelfall geprüft werden muss. Dem Bericht zufolge reichen Anweisungen allein nicht aus, um die Urheberschaft zu bestimmen. Diese Analyse bezieht sich auf das Recht der Vereinigten Staaten, nicht auf eine weltweit geltende Regel.
Die wichtigsten Unterschiede auf einen Blick
| Begriffe | Praktischer Unterschied |
|---|---|
| Modell / Anwendung | Ein Modell wurde mit Daten trainiert, um Vorhersagen zu treffen oder Inhalte zu erzeugen; eine Anwendung kann seine Ausgaben nutzen. |
| Training / Inferenz | Beim Training wird das Modell angepasst; bei der Inferenz wird es zur Erzeugung einer Ausgabe verwendet. |
| Token / Wort | Ein Token ist eine Einheit des Tokenizers und kann ein Wort, ein Wortteil oder ein anderes Fragment sein. |
| Kontext / Gedächtnis | Der Kontext umfasst Informationen, die das Modell für eine Ausgabe erhält; ein Gedächtnis kann eine zusätzliche Systemfunktion sein. |
| RAG / Feinabstimmung | RAG ruft Informationen ab und ergänzt den Kontext; bei der Feinabstimmung wird das Modell für eine Anpassung weitertrainiert. |
| Agent / Arbeitsablauf | Ein Agent kann Schritte und Werkzeuge auswählen; ein Arbeitsablauf folgt vorab festgelegten Schritten. |
| Multimodal / multitasking | Multimodal bezieht sich auf Datenarten, multitasking auf verschiedene Aufgaben. |
| Benchmark / Ergebnis im Einsatz | Ein Benchmark misst unter bestimmten Bedingungen; er garantiert keine Leistung für jede Anwendung. |
Um zu entscheiden, ob ein Tool für dich geeignet ist, solltest du klären, welches Modell oder welche Funktionen es verwendet, welche Daten du übermitteln musst, auf welche Dokumente oder Dienste es zugreifen kann, welche Aktionen es ausführen darf und welche Datenschutz- und Urheberrechtsbedingungen gelten. Betrifft eine Antwort eine wichtige Entscheidung, prüfe die Angaben anhand einer geeigneten Quelle, statt ihre Sicherheit oder sprachliche Flüssigkeit als Garantie zu betrachten.